5.3 构建器模式:声明式对象树的骨架
5.3 构建器模式:声明式对象树的骨架
本节摘要:构建器是 Groovy DSL 的基础设施,把"方法调用 + 闭包"翻译成层级化的对象树。本节讲内置构建器(MarkupBuilder、JsonBuilder)的工作原理、BuilderSupport 与 FactoryBuilderSupport 的扩展机制、methodMissing 在其中的角色,以及构建器的性能、类型安全与适用边界。
本节导读
阅读完本节,你应当能够:
- 解释构建器如何把方法名映射为节点、闭包体映射为子节点、参数映射为属性。
- 用 MarkupBuilder 和 JsonBuilder 生成 XML/JSON,理解其声明式语法。
- 通过继承 BuilderSupport 实现自定义构建器,理解 createNode/setParent/setChild 的作用。
- 说明 FactoryBuilderSupport 的工厂注册机制如何实现"语法与实现分离"。
- 评估构建器的性能代价与适用边界,知道什么时候不该用。
一、问题与直觉:对象树应该"看得到形状"
在传统面向对象里,创建一棵复杂对象树意味着大量构造函数调用与 setter 链,代码充满了噪音,数据结构的形状被淹没在语法里。构建器的洞察是:代码的结构应该直接反映数据的结构。如果一段配置数据的层级是 父节点 → 子节点 → 孙节点,那么写它的代码也应该是同样的嵌套,一眼可见。
Groovy 构建器把方法名变成节点名,把闭包体变成子节点集合,把参数变成属性值。这种映射不是硬编码,而是基于 MOP 的动态解析——遇到未定义的方法,methodMissing 捕获它,把它当作节点名。于是你可以写出 html { body { div '内容' } } 这样的声明式代码,它生成的是一棵对应的对象树。
二、核心原理:构建器的机制
内置构建器:MarkupBuilder 与 JsonBuilder
MarkupBuilder 专为生成 XML/HTML 而生,JsonBuilder 面向 JSON。它们完美展示"闭包嵌套表达层级":
def writer = new StringWriter() def html = new groovy.xml.MarkupBuilder(writer) html.html { head { title '用户列表' } body { ul { li '张三' li '李四' } } } println writer.toString()
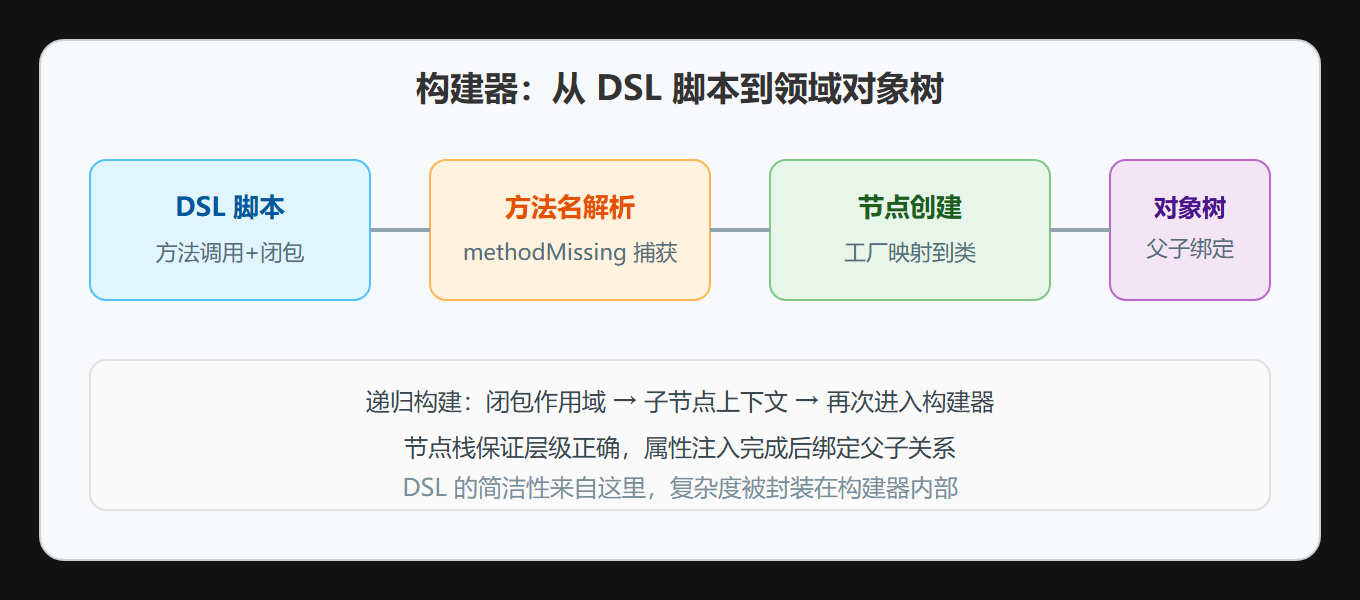
构建器内部维护一个节点栈,确保子节点正确挂载到父节点之下。闭包内的每行方法调用被拦截,转化为一个 XML 元素,参数成为属性。缩进结构直接对应层级——这就是"代码即数据"。
自定义构建器:BuilderSupport
内置构建器只覆盖通用场景,真正的领域 DSL 需要定制。Groovy 提供了 BuilderSupport 抽象类作为基石,它封装了节点管理、父子关系绑定的核心逻辑,你只需要实现几个方法:
createNode:根据方法名创建领域对象。setParent/setChild:维护对象之间的引用关系。
class FlowBuilder extends BuilderSupport { List steps = [] protected Object createNode(name) { [name: name, children: []] } protected void setParent(parent, child) { if (parent) parent.children << child } protected Object postNodeCompletion(parent, node) { if (!parent) steps << node node } } def flow = new FlowBuilder() flow.build { step1 { check '校验库存' } step2 { check '校验支付' } } println flow.steps*.name // [step1, step2]
BuilderSupport 把"构建算法"与"具体产品"解耦,符合开闭原则——业务变化时只需调整节点创建逻辑,不用动构建引擎。
FactoryBuilderSupport:语法与实现分离
FactoryBuilderSupport 在 BuilderSupport 之上引入工厂模式,注册"名称 → 类"的映射表,构建器根据方法名动态查找类进行实例化:
class UiBuilder extends groovy.util.FactoryBuilderSupport { UiBuilder() { registerFactory('button') { new Button() } registerFactory('panel') { new Panel() } } }
方法名 button 可以映射到不同实现(Swing 按钮或 Web 按钮),取决于运行时工厂配置。这种间接层换取了巨大的架构灵活性——通过工厂注册,你甚至能动态加载插件扩展 DSL 词汇表,无需重新编译核心引擎。这是 Groovy 在 DSL 领域的杀手锏之一。
构建器管线全貌
三、工程实践要点:构建器的边界
| 场景 | 推荐做法 | 理由 |
|---|---|---|
| 生成 XML/HTML | MarkupBuilder | 内置、声明式、免配对标签 |
| 生成 JSON | JsonBuilder | 与 Web API 交互无缝 |
| 领域对象树 | 自定义 BuilderSupport | 算法与产品解耦 |
| 语法/实现分离 | FactoryBuilderSupport | 工厂注册、可扩展 |
| 配置 DSL | 自定义构建器 | 配置文件可编程化 |
| 热点路径 | 避免构建器 | 动态分派开销 |
💡 关键直觉:把构建器想成"预制构件 + 拼装手册"——构建器提供拼装逻辑(算法),工厂决定用什么构件(类),DSL 脚本是拼装说明(数据)。三者分离,任何一方变化都不必推翻其他两方。
⚠️ 常见坑:构建器让所有错误推迟到运行时。方法名拼错、参数不对,编译期全不知道,运行时报错还要靠堆栈猜。缓解手段:对 DSL 使用场景写充分的测试;关键路径上配合类型检查扩展;错误信息里携带方法名与上下文,让报错可读。
性能真相
构建器涉及大量动态分派、闭包创建与反射调用,执行效率低于直接构造函数调用。高频交易或低延迟系统里,这种开销可能不可接受。两个对策:核心热点路径退回传统实例化;非核心路径(配置、报表、测试数据)放心用构建器。判断标准仍然是那句——先清晰,热点再优化。
与 Kotlin DSL 的对比
Kotlin 的类型安全构建器在编译期提供了更强保障(错误提前暴露),而 Groovy 构建器在动态脚本里更灵活。这不是谁取代谁,而是不同取舍。对于"必须高度动态、脚本化"的场景,Groovy 构建器依然有优势;对于"大型静态项目",Kotlin DSL 更合适。了解对手才能知道自己该站在哪。
构建器成功的前提
最后强调一个容易忽略的前提:构建器的成败取决于领域模型本身。如果领域模型设计混乱、对象关系耦合度高,构建器只会放大问题。动手写构建器之前,先审视领域模型的聚合根与实体关系,确认它适合树状或图状的自然表达。命名也要遵循领域术语——用 customer 而不是 CustomerBean,用 address 而不是 AddressVO。语言层面的对齐,决定了 DSL 能否被业务专家接受。
四、深入:构建器与元编程的协作
构建器之所以强大,在于它和元编程形成了深度协作。这里拆三个协作点。
第一个是 methodMissing 与节点栈。构建器内部维护节点栈,而 methodMissing 负责"无中生有"地接受方法名。当脚本调用 div { ... } 时,构建器不知道 div 是什么方法——methodMissing 捕获它,压入节点栈,闭包体作为子节点上下文继续递归。这套机制让构建器能接受任意词汇,语法由用户书写,结构由构建器组装。
第二个是闭包委托与父子关系。每个节点的闭包体都通过 delegate 绑定到构建器,确保子节点的创建发生在正确的父节点上下文中。BuilderSupport 的 setParent/setChild 在闭包执行完成后被调用,把已完成的子节点挂到父节点上。委托与节点栈配合,形成了"进入闭包 → 创建子节点 → 完成挂载 → 返回父节点"的递归流程。
第三个是 FactoryBuilderSupport 与插件化。工厂注册表让"词汇"与"实现"解耦——同一个词在不同配置下映射到不同类。更进一步,你可以在运行时动态注册工厂,加载插件扩展词汇表,而无需重新编译。这是 Groovy 构建器在复杂系统中的终极优势:语言本身也是可扩展的。
构建器的常见反模式
三个反模式要警惕。一是"构建器套构建器"——把构建器生成的树再传给另一个构建器,调试时堆栈深不可测。二是"为了构建器而构建器"——简单的三五个字段也上构建器,样板比直接构造还多。三是"构建器做业务逻辑"——在闭包体内塞入复杂的计算、状态变更,让声明式语言变得有副作用。记住:构建器适合"描述结构",不适合"执行逻辑"。
五、常见问题
构建器和传统 Builder 模式什么关系?
名字像,但不同层面。传统 Builder 模式是对象创建的设计模式(链式 setter);Groovy 构建器是"用闭包描述树形结构"的语言机制,它内部可能用传统 Builder,但对外呈现的是声明式 DSL。可以理解为:传统 Builder 管"怎么造一个对象",Groovy 构建器管"怎么用语言描述一片对象图"。
构建器能复用吗?
能。构建器实例可以多次执行 build 逻辑,每次生成独立的对象树。但要注意闭包捕获的外部状态——如果闭包捕获了可变外部变量,多次构建可能产生不一致结果。规范做法:构建器无状态化,或每次构建用新闭包。
JsonBuilder 和 @Canonical 生成 JSON 有什么区别?
不同层面。JsonBuilder 是"手写式"构建 JSON 结构(像写对象字面量),@Canonical 是"自动生成"序列化方法(把现有对象转 JSON)。前者灵活、适合拼装动态结构;后者省事、适合固定模型。二选一的标准:数据形状是动态拼装还是固定映射。
构建器的调用时机与生命周期
理解构建器的一个关键细节是"构建时机"。默认情况下,构建器在闭包执行过程中即时构建对象树(eager);而 Gradle 等框架用"延迟配置"(lazy)让配置块在任务真正执行时才解析。两者的差异影响巨大:即时构建简单直接,适合一次性场景;延迟配置节省资源、支持按需触发,但实现复杂。设计自己的构建器时,先想清楚"对象树该什么时候成形"——这决定了构建器是 eager 还是 lazy,也决定了它的性能特征。
构建器与 JSON/XML 的序列化协作
构建器不只能生成结构化文档,还能和序列化框架协作。比如从对象树反向生成 JSON 时,可以复用构建器的层级逻辑;解析 XML 到领域对象时,XmlSlurper 的 GPath 访问与构建器的对称操作正好互补。实践里最常见的组合是:读入用 XmlSlurper/JsonSlurper(解析),写出用 MarkupBuilder/JsonBuilder(生成),两边都基于同一套层级心智模型。这让 Groovy 处理半结构化数据的体验非常统一。
四、常见问题
methodMissing 在构建器里扮演什么角色?
它是构建器实现动态分发的底层支撑。当调用一个未定义的方法时,methodMissing 被触发,构建器借此捕获方法名并将其视为节点名。这让构建器能"无中生有"地接受任意节点词汇——语法由调用方书写,结构由构建器组装。
构建器生成的代码能静态检查吗?
默认不能。构建器的方法名都是动态的,编译器无法验证。但通过类型检查扩展,可以让编译器理解特定构建器的词汇表,实现部分静态保障。这是 Groovy 官方推荐的方向:既保留构建器语法糖,又提前发现错误。
什么时候该放弃构建器?
三个信号:构建逻辑超过领域逻辑的复杂度(说明抽象层次失衡);需要严格类型契约的公共 API(构建器会让签名模糊);性能敏感的调用路径。出现任一信号,回到传统方式。
重点提炼
- 本质:方法名→节点、闭包体→子节点、参数→属性,代码结构反映数据结构。
- 内置构建器:MarkupBuilder 生成 XML/HTML,JsonBuilder 生成 JSON。
- BuilderSupport:createNode/setParent/setChild 三方法定制领域构建器。
- FactoryBuilderSupport:工厂注册实现语法与实现分离,支持插件扩展。
- methodMissing:动态分发底层支撑,让构建器接受任意词汇。
- 性能边界:动态分派开销大,热点路径退回传统实例化。
- 领域前提:模型清晰 + 命名对齐领域术语,构建器才有价值。
理论、技术、骨架都齐了,下一节用完整实战把它们焊在一起——从零构建一个订单校验 DSL。