5.4 实战:从零构建一个订单校验 DSL
5.4 实战:从零构建一个订单校验 DSL
本节摘要:用完整实战整合 5.1-5.3 的全部能力——设计一个让业务方也能读懂的订单校验规则语言。本节从需求分析出发,逐步构建规则定义、组合、执行与错误报告,演示闭包委托、命令链、构建器的实际运用,并评估这个 DSL 带来的价值与成本。
本节导航
阅读完本节,你应当能够:
- 完成一个 DSL 从需求分析到落地的完整流程。
- 用闭包委托实现"规则块"的层次化定义。
- 用 methodMissing 支持可扩展的规则动词。
- 设计清晰的错误报告,让业务方从报错里读懂问题。
- 评估自己构建的 DSL 的价值与维护成本,知道何时该停下来。
一、需求与直觉:让校验规则"长在业务语言里"
场景还原:电商订单校验,规则很多——金额下限、会员折扣上限、库存检查、风控校验。传统写法是在 Java 里写一堆 if-else,每次改规则都要改代码。更糟的是,业务方看不懂代码,只能通过"需求→实现"的翻译链路沟通,损耗在所难免。
我们想要的状态:规则用一种业务方也读得懂的语法书写,例如:
orderRules { rule '金额下限' { when { order.amount < 100 } then { "订单金额 ${order.amount} 低于下限 100" } } rule '会员折扣上限' { when { order.memberLevel == 'GOLD' && order.discount > 0.2 } then { '金卡会员折扣超出上限' } } }
业务方看这段代码,不需要懂编程——"金额下限、当金额小于 100 时报错",这就是业务语言。本实战的目标,就是把这种体验真正做出来。
二、设计:用闭包委托构建"规则块"
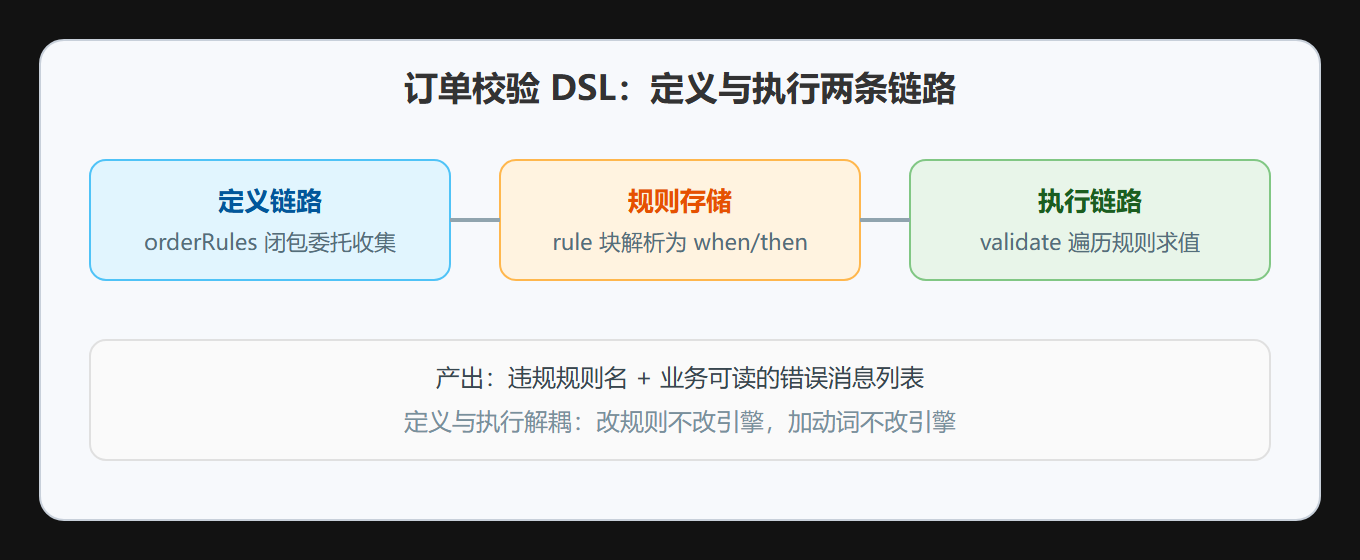
第一版设计聚焦核心:规则定义要用"块"的形式(orderRules 包着多个 rule),每个 rule 里有 when(条件)和 then(结论)。这正是闭包委托的用武之地——用 delegate 让 rule 块内部的方法调用(when、then)落到 RuleBuilder 上下文上。
class RuleEngine { def rules = [] // 入口:orderRules { ... } 收集所有规则定义 def orderRules(Closure body) { def collector = new RuleCollector(rules) body.delegate = collector body.resolveStrategy = Closure.DELEGATE_FIRST body() } // 执行:对订单跑所有规则,返回违规列表 List validate(order) { rules.findAll { !it.when(order) }.collect { it.message(order) } } } class RuleCollector { def rules RuleCollector(rules) { this.rules = rules } def rule(String name, Closure body) { def builder = new RuleBuilder(name) body.delegate = builder body.resolveStrategy = Closure.DELEGATE_FIRST body() rules << builder.build() } } class RuleBuilder { String name Closure condition Closure message RuleBuilder(name) { this.name = name } def when(Closure c) { this.condition = c } def then(Closure m) { this.message = m } def build() { [name: name, when: condition, message: message] } }
这段代码的结构:RuleEngine 是入口与执行器,RuleCollector 收集规则定义,RuleBuilder 承接单条规则的两个块。三层委托关系清晰——这正是 5.2 讲的"闭包委托构建层次化结构"的实例。
三、扩展:methodMissing 让规则动词可生长
第二版考虑可扩展性:如果业务方想加"并且/或者"这类组合语义,或者自定义检查函数怎么办?用 methodMissing 捕获未定义的动词,把它们路由到规则上下文,词汇表就能持续生长,不用改核心引擎。
class RuleBuilder { // ... 已有字段 ... def methodMissing(String name, args) { if (name.startsWith('check_')) { // 支持 check_xxx 形式的自定义检查 def param = args[0] // 动态注册检查逻辑 this.@customChecks << [name: name, fn: param] return this } throw new MissingMethodException(name, this.class, args) } }
methodMissing 的价值在"规则是变化的",而引擎是稳定的——新增动词不碰引擎代码,只在规则脚本里写新检查。这就是运行时元编程在 DSL 里的典型应用。
四、执行与报告:让报错说人话
规则写好了,执行结果要可读。设计三原则:错误消息带业务上下文(订单号、金额、违规规则名);多条错误一起返回,别"报一个停一个";错误消息模板化,业务方看得懂。
def engine = new RuleEngine() engine.orderRules { /* 上面的规则定义 */ } def order = [id: 'A001', amount: 50, memberLevel: 'GOLD', discount: 0.3] def violations = engine.validate(order) violations.each { println "校验失败:$it" }
输出类似"校验失败:订单金额 50 低于下限 100"。业务方看到这条消息,不用查代码就能理解问题。这正是 DSL 的价值——不仅规则可读,报错也可读。
规则执行管线全景
五、工程实践要点:这套 DSL 的代价与边界
做完了,要冷静评估。这套 DSL 带来了什么?规则可读性大幅提升,业务方能参与规则编写与评审,规则变更不必改 Java 代码。代价呢?规则调试难度高(报错在运行时,且经过委托层)、类型安全缺失、性能有动态开销。
| 收益 | 成本 |
|---|---|
| 业务方可读规则 | 调试复杂度上升 |
| 规则变更无需发版 | 运行时错误更晚暴露 |
| 词汇可扩展 | 需维护文档与示例 |
| 校验逻辑集中 | 新手学习曲线 |
⚠️ 常见坑:为这个 DSL 写"完备的语法文档",把简单的事搞复杂。一个业务方 + 程序员都懂的 DSL,文档应该是一页纸的示例,而不是几百页的语法参考。如果示例页超过三屏,说明词汇设计过复杂,该收敛了。
💡 关键直觉:DSL 是"有生命的代码",它会随业务演进。一开始只做 20% 的词汇(when/then/rule),跑起来让业务方用,从使用反馈里长出剩下的 80%。别想一次设计完美——那是外部 DSL 才需要的事前投入,内部 DSL 的优势就是"边用边长"。
安全与性能的收敛
如果这个 DSL 会被非技术人员编辑,沙箱必须上:用 SecureASTCustomizer 限制规则脚本能访问的类与操作,防止恶意代码。如果校验量巨大(每秒数万订单),热点路径上缓存规则解析结果,或把常用规则用 @CompileStatic 编译。安全与性能不是 DSL 的选修课,是上生产前的必修课。
测试策略
DSL 的测试分两层:引擎层的单元测试(RuleEngine 的收集与执行逻辑)与规则层的集成测试(用真实规则脚本验证行为)。规则层测试尤其重要——规则是业务契约,规则改了必须验证不破坏既有订单流。Spock 正好适合写这种"读起来像规范"的测试,第 6.2 节会展开。
六、进阶:让 DSL 支持"组合规则"与"数据驱动"
第一版规则是独立的,真实业务往往需要组合:多条件同时满足、或条件满足其一、规则分组。这里展示两个进阶扩展,用到的还是我们已经掌握的技术。
组合逻辑:在 when 里写复合条件
Groovy 闭包天然支持布尔运算,规则组合不需要新机制——业务方直接在 when 里用 &&、|| 组合条件即可:
rule '大额跨区订单需人工审核' { when { order.amount > 5000 && order.region != user.region } then { '大额订单且收货区与下单区不一致,需人工审核' } }
这里的关键设计决策是:把"组合"的复杂度交给规则脚本,而不是引擎。引擎只负责"规则是否通过 + 消息是什么",组合逻辑由脚本书写。这是"引擎稳定、脚本灵活"原则的体现——复杂度向易变的一侧倾斜。
数据驱动:规则模板 + 数据表
如果一批规则只有参数不同(如不同品类的金额下限),可以为规则引入数据表:
def limits = [ [cat: '手机', min: 100], [cat: '家电', min: 500], [cat: '配件', min: 20] ] limits.each { l -> engine.orderRules { rule "品类${l.cat}金额下限" { when { order.cat == l.cat && order.amount < l.min } then { "品类${order.cat}订单金额 ${order.amount} 低于下限 ${l.min}" } } } }
数据与规则模板分离,规则数量从"手写 N 条"变成"一条模板 + 一张数据表"。这是数据驱动测试思想(第 6.2 节 Spock 的 where 块)在 DSL 里的迁移——逻辑与数据分离是通用工程原则。
七、收尾:给这套 DSL 打分
最后用 5.1 的三个维度给这套订单校验 DSL 打分,做个完整闭环。
表达力:规则可读性达到目标——业务方能读懂 when/then 结构,且能参与编写。打分偏高。
安全性:如果规则脚本来自内部团队且不直接执行用户输入,风险可控;如果未来开放给外部编辑,必须补沙箱(SecureASTCustomizer)。当前状态打分中等。
可演化性:引擎与规则分离,新增规则不动引擎,methodMissing 支持新动词,演化路径清晰。打分偏高。
三个维度综合评估:这套 DSL 在"业务规则频繁变化"的假设下是净正收益。如果规则数量少于十条、变化频率低,那么它的维护成本(文档、测试、调试难度)可能超过收益——这就是为什么评估框架要提前用,而不是做完才反思。
本章回顾
- 完整流程:需求 → 设计 → 实现 → 扩展 → 报告 → 评估,六步闭环。
- 三层委托:RuleEngine → RuleCollector → RuleBuilder 构建规则块。
- methodMissing 扩展:check_xxx 动词让词汇表可生长。
- 组合规则:复合条件交给脚本闭包,引擎保持稳定。
- 数据驱动:规则模板 + 数据表,逻辑与数据分离。
- 三围评估:表达力、安全性、可演化性逐项打分。
- 成本意识:规则少且变化低时,DSL 不划算,退回普通代码。
这一章的实战,其实就是 Groovy 生态里那些工具的迷你版。下一章我们去看真正的"巨无霸"——Gradle、Spock、Grails 和 Jenkins,看它们如何把 DSL 做到生产级。
八、常见问题
这套校验 DSL 和直接用 Java 写校验有什么区别?
代码量上,Java 校验每个规则要一个方法加一堆样板;DSL 里一条规则就是 when/then 两行。沟通上,Java 校验逻辑业务方读不懂,DSL 规则业务方能评审、能参与编写。维护上,Java 改规则要发版,DSL 规则可以外置、热更新。但也要看到反面:Java 校验有类型安全、IDE 补全、编译器检查;DSL 规则这些全没有。所以判断标准是"规则变化的频率和参与者的构成"——变化频繁且业务方参与,DSL 胜出;否则 Java 更省心。
规则引擎的 methodMissing 会不会吞掉真正的拼写错误?
会,这是运行时元编程的固有风险。engine.wen_highValue 拼错了,methodMissing 不会报编译错误,而是尝试解析后可能静默失败或抛运行时异常。缓解手段:methodMissing 对"未注册的规则名"给出明确错误提示(而不是静默);为规则名建立索引和校验;测试覆盖"拼写错误"这个用例,确保报错清晰。任何 DSL 都要在"动态灵活"和"错误快速暴露"之间找平衡。
这个 DSL 能直接上线吗?
取决于安全与性能要求。上线前必须做三件事:规则脚本沙箱化(限制可访问的类与操作);规则解析结果缓存(避免每次执行都重新解析);对核心规则写测试固化。如果规则会由非技术用户编辑,沙箱是强制项,不是可选项。做完这三件事,它才具备生产级的基本条件。这套流程本身,就是你之后给任何业务构建 DSL 时都要重复的标准动作——从最小词汇起步,用真实需求驱动扩展,上线前补齐安全与性能,再以三个设计维度做冷静的复盘评估。每一次重复,你对"什么时候该建 DSL"的判断就会更准一分。这套流程的价值在于:它把"要不要建 DSL"从模糊的感觉变成了可复用的决策路径——先用小词汇验证价值,再让真实需求驱动演化,最后用三维度评估收口。
本章回顾
- 需求驱动:规则校验场景天然适合 DSL,业务方可读是核心目标。
- 闭包委托:orderRules → rule → when/then 三层委托构建规则块。
- methodMissing:让规则动词可扩展,词汇表随业务生长。
- 错误报告:消息带业务上下文,多错误一次返回,业务方可读。
- 定义与执行解耦:改规则不改引擎,加动词不改引擎。
- 冷静评估:DSL 有调试与安全成本,不值得就退回普通代码。
- 演进策略:先做最小词汇,边用边长,安全性能上生产前补齐。
从这一章的 DSL 实战里,你其实已经提前摸到了 Groovy 生态的核心工具——Gradle、Spock、Grails 都是这么设计出来的。下一章我们走进这个生态,看它们怎么把 DSL 用到了极致。