6.4 脚本化集成:GroovyShell 与 Jenkins Pipeline
6.4 脚本化集成:GroovyShell 与 Jenkins Pipeline
本节摘要:Groovy 最强的渗透力在于脚本化集成——Java 应用里嵌入规则脚本、CI/CD 里编排流水线。本节讲 GroovyShell 的绑定机制、GroovyClassLoader 的类隔离与热替换、脚本缓存的性能优化,以及 Jenkins Pipeline 的沙箱安全与 CPS 执行模型。
阅读收获
阅读完本节,你应当能够:
- 用 GroovyShell + Binding 在 Java 应用中嵌入并执行脚本。
- 理解 GroovyClassLoader 的动态加载机制与类隔离策略。
- 用脚本编译缓存消除解析/编译开销,逼近原生调用性能。
- 理解 Jenkins Pipeline 的脚本安全沙箱与白名单机制。
- 说明 CPS 转换如何让 Jenkins 脚本实现跨重启的异步执行。
- 建立脚本化集成的安全与性能纪律。
一、问题与直觉:Java 应用怎么"长出"可变的逻辑
Java 是静态编译的,类一旦加载就不易改变。但现实需求往往需要"运行时可变":计费系统的费率规则每周调整、风控系统的阈值随环境变化、报表引擎的口径不断演进。硬编码意味着每次变更都要经历编译、测试、发布的完整周期。脚本化集成把答案交还给"可变性":Java 提供稳定的基础设施,Groovy 脚本承载易变的业务规则。
这种分工的精妙在于:Java 侧保证性能与类型安全,脚本侧提供灵活与快速迭代。两者通过 Groovy 的运行时桥接——Java 宿主创建脚本引擎、绑定上下文、执行脚本、获取结果。Groovy 不取代 Java,而是让 Java 应用获得了"自我更新"的通道。
二、核心原理:嵌入机制与执行模型
GroovyShell:宿主与脚本的通信桥
GroovyShell 是 Java 应用调用 Groovy 代码的编程接口。核心是 Binding 类——维护"变量名 → 对象引用"的映射表,把 Java 对象绑定到脚本上下文:
def binding = new Binding() binding.order = new Order(id: 'A001', amount: 1500) binding.taxRate = 0.06 def shell = new GroovyShell(binding) def result = shell.evaluate(""" def tax = order.amount * taxRate "含税金额: \${order.amount + tax}" """) println result
Binding 让脚本直接操作宿主对象,脚本里定义的闭包也能回调 Java 方法——双向深度集成。这种模式让规则外置成为可能:费率规则提取为外部脚本,系统运行时动态加载执行,规则变更不需要重启服务。
脚本执行链路
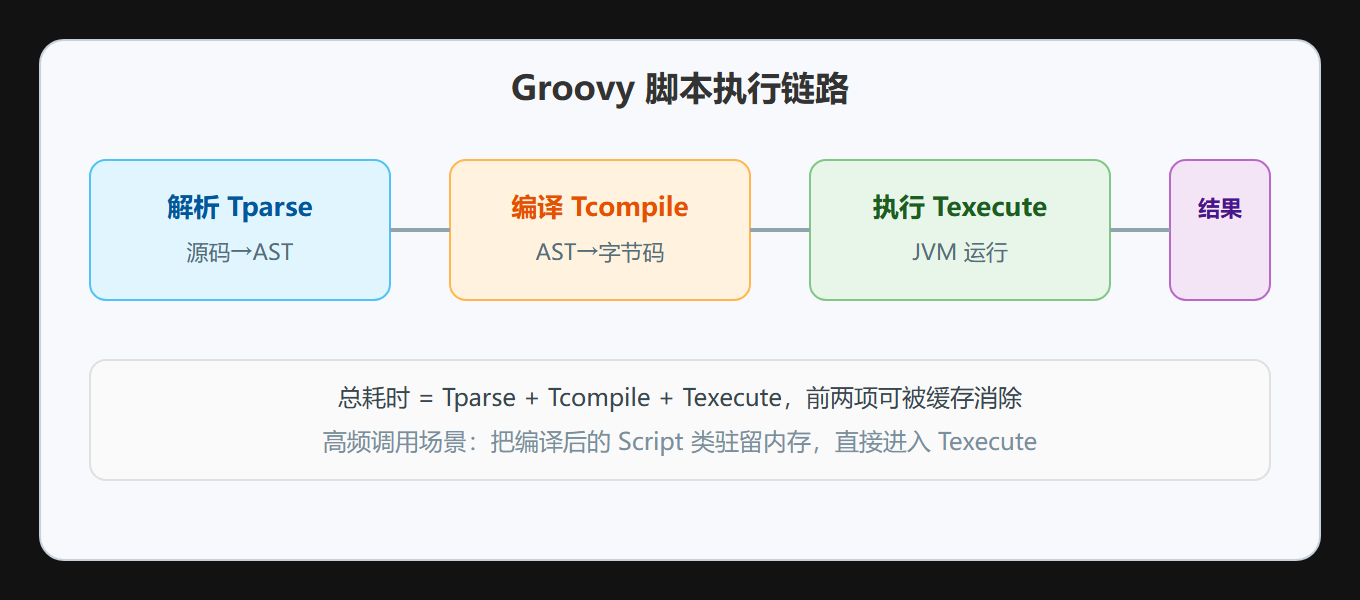
脚本执行的总耗时由三部分组成:解析、编译、执行。高频调用时,解析与编译的累积会成为瓶颈。解法是脚本缓存:把编译后的 Script 类对象驻留内存,后续调用直接进入执行阶段,逼近原生 Java 的效率。这是脚本化集成性能优化的第一课。
GroovyClassLoader:动态类加载与隔离
GroovyClassLoader 让系统在运行时动态定义类、修改字节码行为,绕开磁盘类文件依赖。JVM 的双亲委派模型确保核心库安全,但脚本化应用往往需要打破常规——实现类热替换与隔离加载。在多租户场景,不同租户执行自定义脚本,若共享 ClassLoader 会类名冲突、相互污染。正确做法是每租户独立 ClassLoader,租户终止时丢弃,GC 自动清理类元数据。这把故障域限制在最小范围。
三、工程实践要点:沙箱、性能与纪律
| 关注点 | 风险 | 应对手段 |
|---|---|---|
| 注入攻击 | 用户输入拼进脚本 | 参数绑定,绝不拼接 |
| 资源滥用 | 死循环、大内存 | 循环限制 + 超时 + 资源上限 |
| 敏感访问 | 脚本读写文件/网络 | 白名单 API + 类限制 |
| 性能劣化 | 无缓存重复编译 | 编译缓存 + 热点静态化 |
| 版本失控 | 脚本改了没人知道 | 纳入版本控制 + 灰度发布 |
安全:脚本是"不可信输入"
嵌入脚本意味着"代码可以在运行时被修改",这是注入攻击的可能入口。安全纪律三条:绝不把用户输入直接拼进脚本字符串执行,用参数绑定传值;限制脚本可访问的类与方法——禁止 Socket、File 等敏感资源;设置资源消耗上限(CPU、内存、循环深度)。Groovy 提供 SecureASTCustomizer 与编译配置来实现这些限制。
⚠️ 常见坑:图省事把用户输入拼进
shell.evaluate("...${input}...")。这等于把代码执行权交给了输入者,是脚本注入的教科书式漏洞。正确做法是 input 通过 Binding 传参,脚本内部引用变量。
💡 关键直觉:把脚本想成"外来访客"——给他明确的活动范围(白名单 API)、限制他的权限(资源上限)、记录他的行为(日志)。所有安全边界要默认拒绝、显式放行,而不是默认放行、事后补救。
Jenkins Pipeline:沙箱与 CPS
Jenkins Pipeline 是脚本化集成在 CI/CD 领域的标杆。它把流水线定义为代码(Pipeline as Code),Jenkinsfile 就是 Groovy 脚本。Jenkins 在控制节点的沙箱中执行脚本,默认只允许调用白名单批准的方法,未批准调用会被阻断并申请管理员审批——这是基于能力的访问控制模型。
Jenkins 的 CPS(Continuation Passing Style)转换是 Groovy 元编程的杰作:流水线执行可能跨越数小时甚至数天,涉及节点重启,传统线程阻塞模型不适用。Jenkins 利用 AST 转换把同步脚本代码自动转换为异步状态机——脚本执行到等待点,当前状态序列化到磁盘,线程释放;外部事件触发时恢复状态,脚本从断点继续。对脚本开发者透明,底层却是异步非阻塞调度。
性能与版本管理
脚本缓存放第一位;其次对性能敏感的脚本片段可用 @CompileStatic。版本管理上,脚本应纳入版本控制系统、支持回滚,并具备灰度发布能力——新脚本先应用到少量流量,验证后全量。多版本共存需要脚本加载器按路由规则分发版本实例。这套精细控制把脚本集成从"玩具"升级为"企业级特性"。
四、深入:脚本缓存的完整实现
前面提到"把编译后的 Script 类驻留内存",这里给出完整实现思路,这是脚本化集成性能优化的核心工程。
class ScriptCache { private final Map<String, Class> cache = new ConcurrentHashMap<>() Class getOrCompile(String scriptText) { cache.computeIfAbsent(scriptText.hashCode().toString()) { key -> new GroovyClassLoader().parseClass(scriptText) } } Object run(String scriptText, Binding binding) { def scriptClass = getOrCompile(scriptText) def script = scriptClass.newInstance() script.binding = binding script.run() } }
关键点:缓存的是编译后的 Class,不是执行结果——这样每次执行仍是独立实例、可绑定不同上下文,但省掉了解析与编译的开销。配合 ConcurrentHashMap 保证并发安全。如果脚本来自文件,还可以按文件的 lastModified 判断是否需要重新编译,实现"改文件即生效"的热更新。
脚本热更新的架构模式
热更新的本质是"把变化隔离在可替换的单元里"。推荐的分层:最外层是脚本加载器(负责缓存与版本管理),中间是脚本接口(Java 定义、Groovy 实现),最内层是业务逻辑(稳定)。脚本更新时,加载器创建新 ClassLoader 编译新脚本,切换引用,旧 ClassLoader 交给 GC。这个模式把"动态变化"关在了一个可控的小盒子里,其余部分保持稳定。
安全边界的具体配置
Groovy 的 SecureASTCustomizer 能做细粒度限制:类白名单(只能 import 指定包)、禁止的操作(如 System.exit)、循环深度上限、方法调用限制。加上编译配置的 compilation customizers,还能限制脚本可访问的类加载器层次。一套完整的安全配置应该做到:脚本只能做"被允许的事",其余一律拒绝,且拒绝时给出清晰错误。安全配置本身要纳入版本管理,因为它是基础设施的一部分。
五、常见问题
脚本性能和 Java 差距有多大?
取决于场景。有缓存的脚本,重复调用接近 Java 性能(省掉解析编译后,执行路径差异不大);无缓存的脚本,每次解析编译的开销可能让性能差一个数量级。所以"脚本慢"的常见答案不是"Groovy 慢",而是"没做缓存"。加上 @CompileStatic,脚本性能可以进一步逼近 Java。
多租户脚本隔离怎么做?
每租户独立 GroovyClassLoader + 独立脚本缓存 + 独立沙箱配置。租户 A 的类与租户 B 的类互不可见,一个租户的脚本错误不会污染另一个。租户终止时丢弃 ClassLoader,GC 回收类元数据。这是多租户 SaaS 的标配做法,也是脚本化集成的进阶能力。
怎么防止脚本死循环?
两个层面:编译期用 SecureASTCustomizer 限制循环结构(或限制循环深度);运行期给执行加超时或线程中断机制。单靠编译期限制不够,因为合法的长任务也可能失控。生产环境建议两者结合,且给脚本执行设置明确的时间与资源预算。
六、从脚本到产品:一个完整的集成案例
用一个案例把 6.4 的所有知识点串起来:给一个计费系统嵌入可热更新的费率规则。
需求:费率规则按地区、品类、会员等级组合计算,运营要能自己改规则而不发版。
设计:Java 侧定义费率接口与调用入口;规则写成 Groovy 脚本文件,用独立 ClassLoader 按版本加载;运营改文件后系统自动检测变更、重新编译、热切换;规则执行有沙箱(禁止网络与文件访问)与超时控制;所有规则变更记录版本日志。
实现要点:脚本缓存类(按文件 lastModified 判断重编译)、规则接口(Java 定义)、规则脚本(Groovy 实现)、加载器(独立 ClassLoader 隔离)、沙箱配置(SecureASTCustomizer 白名单)、执行预算(超时与资源限制)。
这个案例的价值在于展示:脚本化集成不是"把代码塞进字符串执行"那么简单,而是一套包含接口、缓存、隔离、沙箱、监控的完整工程。每一步都有明确的目的——接口保证稳定、缓存保证性能、隔离保证安全、沙箱保证边界、监控保证可观测。当你能为"一个脚本"设计出这套体系时,脚本化集成就从技巧升级成了架构能力。
常见故障与排查
脚本化系统最常见的三类故障:脚本编译失败(语法或引用错误)、脚本运行时异常(类型不匹配、方法缺失)、性能劣化(缓存失效、死循环)。排查顺序:先看日志里脚本执行的错误上下文,再用本地 Groovy 环境复现脚本,最后检查缓存是否命中、沙箱配置是否误伤。给脚本加执行前后的日志与耗时统计,是定位问题的最快路径——脚本是黑盒,日志就是它的窗户。
七、小结:脚本化集成的完整图景
把 6.4 收束成一张图景:脚本化集成的本质,是"把可变化的部分从代码里剥离出来,用脚本承载,并配齐安全、性能、管理设施"。Java 提供稳定与能力,Groovy 提供灵活与效率,两者通过接口、缓存、沙箱、日志连接。这套模式在规则引擎、报表系统、CI/CD、运维自动化里反复出现——掌握它,等于掌握了一套可复用的"可演化系统"设计范式。下一节(6.5)我们把这个范式放进更完整的 Java 与 Groovy 混合项目里。
四、常见问题
脚本化集成最大的风险是什么?
安全与性能。安全上,不可信脚本可能执行恶意代码;性能上,动态加载与执行有开销。两者都要在设计期解决:安全用沙箱 + 白名单 + 参数绑定,性能用缓存 + 静态编译。忽视任何一方,脚本化都会变成生产事故源。
GroovyShell 和 GroovyClassLoader 什么关系?
GroovyShell 是高层入口,内部使用 GroovyClassLoader 完成类加载。GroovyShell 适合"执行脚本片段",GroovyClassLoader 适合"加载完整类并复用"。实际项目中,需要热替换的类用 ClassLoader 管理,一次性脚本用 Shell 执行。
Jenkins 沙箱里能做什么、不能做什么?
能:白名单内的 Pipeline 方法(stage、step、sh、echo)、经过审批的库方法。不能:默认情况下访问文件系统、网络、反射调用未审批方法。规则是"默认拒绝,审批放行"。这个模型在保持 Groovy 表达力的同时,构建了运维安全围栏。
核心回顾
- GroovyShell:Binding 绑定宿主对象,脚本内执行规则、外置逻辑。
- 执行链路:解析 + 编译 + 执行,前两阶段可缓存消除。
- GroovyClassLoader:动态类加载、热替换,多租户用独立 ClassLoader 隔离。
- 安全纪律:参数绑定传值、白名单限制、资源上限,默认拒绝。
- Jenkins Pipeline:Pipeline as Code + 沙箱白名单 + 审批机制。
- CPS 转换:同步代码转异步状态机,支持跨重启的长时间流水线。
- 企业化:脚本纳入版本控制、支持回滚与灰度发布。
单独用 Java 或单独用脚本都有局限,混合才是常态。下一节用完整实战演示 Java 与 Groovy 混合项目的互操作。