6.5 实战:Java 与 Groovy 混合项目的互操作
6.5 实战:Java 与 Groovy 混合项目的互操作
本节摘要:把本章能力落进真实工程——在一个既有 Java 项目里渐进引入 Groovy,处理混合编译、互操作边界、类加载与依赖隔离。本节用完整案例演示从零配置到平稳运行的路径,并列出混合项目最常见的坑与解法。
先说结论
阅读完本节,你应当能够:
- 配置 Gradle 支持 Java 与 Groovy 混合编译。
- 设计 Java 与 Groovy 的互操作边界(接口稳定、实现灵活)。
- 理解混合编译的顺序问题与规避方式。
- 识别混合项目中的类加载器与依赖冲突陷阱。
- 为混合项目制定测试策略与规范约束。
一、问题与直觉:渐进式引入,而不是推倒重来
假设你有一个运行多年的 Java 订单系统。业务方提了个新需求:规则要能热更新、报表脚本要让运营自己改。全盘重写不现实,直接上 Groovy 又担心风险。正确的路线是"绞杀者模式"——在不推翻现有架构的前提下,从边缘场景逐步引入 Groovy:先用它写测试(Spock)、写构建脚本(Gradle 本来就是)、处理规则与报表,验证价值后再决定是否扩大。
混合项目的核心收益是"按场景选工具":Java 管核心逻辑(类型安全、性能),Groovy 管易变逻辑(规则、配置、测试、脚本)。但混合也带来新的复杂度:编译顺序、类加载器、依赖隔离。本实战的目标,是把这些复杂度变成可控的工程决策。
二、配置:让 Gradle 认识两种语言
Gradle 原生支持混合编译,核心是引入 groovy 插件,让构建同时编译 Java 与 Groovy 源码:
plugins { id 'groovy' id 'java' } dependencies { implementation 'org.codehaus.groovy:groovy:3.0.19' testImplementation platform('org.spockframework:spock-bom:2.3-groovy-3.0') testImplementation 'org.spockframework:spock-core' testImplementation 'org.junit.jupiter:junit-jupiter' }
关键约定:Java 源码放 src/main/java,Groovy 源码放 src/main/groovy,测试同理。Groovy 编译器能理解 Java 代码,所以 Groovy 类可以引用 Java 类;但 Java 编译器不理解 Groovy 的动态特性。因此混合编译的顺序很关键——构建工具会先编译 Groovy(它依赖的 Java 类也已就绪),保证两边互调正常。
混合编译的双向依赖
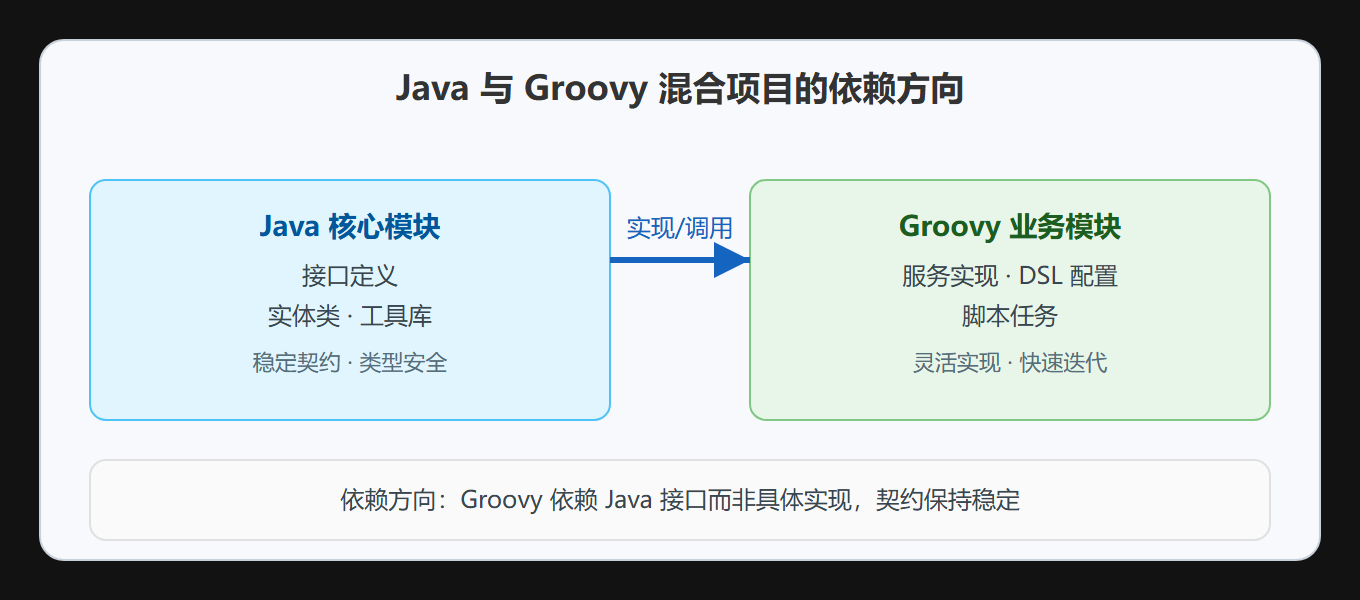
核心设计原则:Groovy 模块依赖 Java 的接口与契约,而不是反过来。Java 侧定义稳定的接口(跨模块边界、对外 API),Groovy 侧提供灵活的实现。这样 Java 核心保持稳定,Groovy 的灵活性被约束在边界内,不会反向污染。
三、实现:互操作边界的三个层次
边界一:契约层用 Java
接口、DTO、枚举、异常类型放 Java。原因:契约要被多个模块、甚至外部系统引用,需要严格的类型与序列化稳定性。Groovy 的动态类型在这里是劣势。
public interface TaxCalculator { BigDecimal calculate(Order order); }
边界二:实现层用 Groovy
规则、策略、转换逻辑的实现放 Groovy。它们变化频繁,动态特性收益大,且通过 Java 接口被调用方无感:
class DynamicTaxCalculator implements TaxCalculator { BigDecimal calculate(Order order) { def rate = order.region == '华东' ? 0.06 : 0.03 order.amount * rate } }
Java 侧调用 TaxCalculator 接口,完全不知道背后是 Groovy 实现——这就是边界设计的价值。
边界三:脚本层独立 ClassLoader
若规则要运行时热更新,把它做成外部脚本,用独立的 GroovyClassLoader 加载。每套规则一个 ClassLoader,更新时替换,旧的交给 GC。这样"热更新"与"类型稳定"各得其所:接口稳定、实现动态、脚本可换。
四、工程实践要点:混合项目的五个坑
坑一:编译顺序
Groovy 类引用 Java 类没问题,Java 类引用 Groovy 类时要小心——Java 编译器看不到 Groovy 源码。规避:契约层用 Java(Groovy 引用 Java 总是安全),业务实现用 Groovy(Java 侧只依赖接口,不直接依赖 Groovy 实现类)。
坑二:类加载器隔离
Groovy 的元编程(Mixin、Category)如果全局污染了 Java 核心类,Java 模块运行时会出诡异异常。纪律:元编程限制在 DSL 领域或脚本上下文,严禁全局修改 Java 标准库与核心业务类。
坑三:依赖传递冲突
Groovy 运行时库版本与项目第三方依赖可能冲突。解法:精心设计依赖树,必要时用阴影打包(Shadow Jar)或重定位隔离 Groovy 运行时依赖,防止其泄露给纯 Java 消费者模块。
坑四:跨语言类型边界
Groovy 动态方法返回 Object,Java 侧拿到的是 Object 而非具体类型。跨语言边界处,Groovy 侧显式声明返回类型,避免 Java 被迫做强制转换。
坑五:测试与文档脱节
动态特性在静态分析里不可见,测试是唯一保障。用 Spock 写集成测试验证 Groovy 实现行为,用契约测试验证接口合规;动态注入的方法在文档中明确标注来源。
| 风险 | 解法 |
|---|---|
| 编译顺序 | 契约 Java、实现 Groovy |
| 类加载污染 | 元编程限域,不碰 Java 核心 |
| 依赖冲突 | 依赖树设计 + Shadow Jar 隔离 |
| 类型边界 | Groovy 侧显式声明返回类型 |
| 测试盲区 | Spock 集成测试 + 契约测试 |
⚠️ 常见坑:把混合项目当成"Java 项目里随便塞 Groovy 文件"。没有边界设计,Groovy 的动态性会像藤蔓一样爬满整个代码库,最终谁都说不清哪个行为来自哪里。边界是混合项目的第一设计对象。
💡 关键直觉:混合项目的目标是"把 Groovy 的灵活性关进笼子里"——用 Java 接口做笼子的栅栏,用 Groovy 实现做笼子里的灵活零件,用 ClassLoader 隔离做分区。笼子不是为了限制,而是为了让人放心地释放灵活性。
五、验证与演进
混合项目上线前,做三层验证:构建验证(Gradle 干净构建通过,确认编译顺序无误)、测试验证(Spock 覆盖 Groovy 实现行为 + 契约测试覆盖边界)、灰度验证(新规则先应用到少量流量)。上线后持续观察两个指标:规则变更的平均迭代周期是否缩短、因动态特性导致的线上问题是否可控。
演进路径:第一步,引入 Spock 写测试;第二步,把规则/报表逻辑迁移到 Groovy;第三步,需要热更新的脚本用独立 ClassLoader;第四步,评估是否扩大 Groovy 使用面。每一步都是局部改动、可回滚——这就是渐进式引入的节奏,也是混合项目能长期健康运行的关键。
六、一个完整的迁移示例
用一个可操作的小例子走完"Java 代码 → Groovy 实现"的迁移,让你对"接口稳定、实现灵活"有体感。
迁移前,Java 代码里有一堆 if-else 计算运费:
public BigDecimal shippingFee(Order order) { if (order.amount > 500) return BigDecimal.ZERO; if (order.weight > 10) return new BigDecimal("25"); return new BigDecimal("10"); }
第一步:定义 Java 接口,作为契约层:
public interface ShippingPolicy { BigDecimal fee(Order order); }
第二步:用 Groovy 实现策略,放在易变层:
class SimpleShippingPolicy implements ShippingPolicy { BigDecimal fee(Order order) { order.amount > 500 ? 0G : (order.weight > 10 ? 25G : 10G) } }
第三步:调用方只依赖接口:
ShippingPolicy policy = policyFactory.get(); // 实现可以是 Groovy BigDecimal fee = policy.fee(order);
第四步(可选):把策略做成外部脚本,运行时热更新。这一步用 GroovyShell 或独立 ClassLoader 加载,接口不变,规则可改。
这个迁移的价值:运费规则是典型的"频繁变化"逻辑,把它移到 Groovy 后,改规则不再需要改 Java 代码、重新编译发布。而接口层的稳定保证了整个系统的其余部分无感。这就是混合项目"渐进式引入"的最小闭环——从一个小策略开始,验证流程,再扩大范围。
迁移过程中的回归保障
任何迁移都怕"改了规则,行为悄悄变了"。三个保障手段:迁移前后用同一批测试数据跑对比(Java 版 vs Groovy 版的输出必须一致);用 Spock 给新实现写行为测试,把规则固化下来;灰度发布,先小流量验证。尤其是"输出一致性"这一步,它能捕捉到"if-else 顺序不同导致分支判断差异"这类隐蔽 bug。
七、常见问题
混合项目会不会让代码库变乱?
取决于边界设计。没有边界,Groovy 会散落各处,代码库确实会乱;有清晰边界(契约 Java、实现 Groovy、脚本隔离),反而每个模块都更清晰。所以问题的关键不是"要不要混合",而是"混合的边界在哪"。把边界写进编码规范,比靠自觉可靠。
Java 项目引入 Groovy 的成本有多大?
成本分三块:构建配置(加插件与依赖,几乎为零)、团队学习(Groovy 语法上手快,Java 开发者一两天能写)、维护纪律(边界设计、规范约束)。收益是易变逻辑的迭代速度大幅提升。多数团队的判断是:小成本、大收益,前提是纪律到位。
什么时候该停止扩大 Groovy 使用面?
当出现这些信号时:动态特性导致的问题开始频繁出现在核心路径;团队无法说清某个行为来自哪段代码;测试无法覆盖动态行为。此时应该收口——把核心路径静态化(@CompileStatic),把 Groovy 局限在规则、脚本、测试这些"变化快、边界清"的区域。知道何时停止,比知道何时开始更重要。
八、混合项目的规范模板
最后给一份可以直接套用的"混合项目编码规范"清单,作为团队约定的起点。
边界约定:Java 负责接口、DTO、实体、核心算法、对外 API;Groovy 负责服务实现、规则策略、配置 DSL、测试、脚本。跨模块边界一律通过 Java 接口通信,禁止直接依赖 Groovy 实现类。
类型约定:Groovy 在契约边界处显式声明返回类型,核心路径用 @CompileStatic;动态特性限制在脚本、配置、测试区域。禁止在核心业务逻辑里使用全局元编程修改。
依赖约定:Groovy 运行时依赖用 Shadow Jar 隔离,不泄露给纯 Java 模块;版本统一管理;升级 Groovy 版本要有兼容性测试。
测试约定:Groovy 实现必须有 Spock 测试覆盖;跨语言接口有契约测试;动态注入的行为有专门测试与文档登记。
这份清单不是教条,而是"经验沉淀"。每个团队可以根据自己的项目调整条款,但"边界、类型、依赖、测试"四个维度不能缺——它们是混合项目不发生混乱的底线。把清单写进 README,比每个人各自摸索要可靠得多。
最后补一个易踩的坑
混合项目最隐蔽的坑之一:Groovy 脚本里调用了 Java 方法,但参数类型不匹配——Groovy 动态传参不会像 Java 那样在编译期报错,运行时会抛类型异常或产生错误结果。规避:跨语言调用处,Groovy 侧显式转换参数类型(toBigDecimal、toString 等),别依赖隐式转换。这个坑通常在你"用得很顺手"的时候出现,所以要有意识地在边界处收紧类型。
九、本节小结
混合项目不是"Java 和 Groovy 放在一个项目里"这么简单,而是一套关于边界、依赖、类型的系统工程。核心要点回顾:渐进引入(别推倒重来)、契约 Java 实现 Groovy、编译顺序有讲究、类加载要隔离、依赖要防冲突、测试要覆盖动态、规范要固化底线。把这七条做到位,混合项目就是"取两者之长";做不到位,就是"集两者之乱"。带着这套框架去实践,你的下一个 Groovy 项目会稳得多。
本节速览
- 渐进引入:绞杀者模式,从测试、规则等边缘场景开始。
- 构建配置:groovy 插件 + 源码目录分离,Gradle 自动混合编译。
- 边界设计:契约 Java、实现 Groovy、脚本独立 ClassLoader。
- 编译顺序:Groovy 引用 Java 安全,Java 侧只依赖接口。
- 类加载纪律:元编程限域,禁止全局污染 Java 核心类。
- 依赖隔离:Shadow Jar 重定位,防止 Groovy 运行时泄露。
- 验证闭环:构建 + 测试 + 灰度三层验证,小步演进。
混合项目把"写应用"的能力补齐了,但"跑得快"还需要理解底层。下一章进入性能与并发的深水区——Groovy 的动态性到底付出了什么代价,又怎么把它降到最低。