4.1 分层架构与客户端三件套
4.1 分层架构与客户端三件套
本节摘要:gRPC 客户端的分层从上到下是业务代码、Stub 存根、拦截器链、Channel 通道、HTTP/2 传输。本节拆解各层职责,重点讲 Channel、Stub、Call 三件套的生命周期与线程安全边界,并给出 Channel 的工程管理规范——共享复用、目标寻址格式、优雅关闭,这些直接决定客户端侧的资源健康度。
学习目标
阅读完本节,你应当能够:
- 画出客户端五层结构并说出每层"管什么、不管什么";
- 说明 Channel、Stub、Call 的创建成本与共享边界;
- 使用三种目标寻址格式(固定地址、DNS、自定义解析器);
- 解释负载均衡在 Channel 内的位置与默认行为;
- 在应用启动与退出时正确管理 Channel 生命周期。
一、分层全景:一次调用穿过的五层
第 1 章的导览图给过全景,现在把客户端侧放大。以一次一元调用为例,从业务代码出发向下穿过五层:
第一层,业务代码。你写的调用逻辑,拿到的只是一个像本地函数的存根方法。
第二层,Stub 存根。由 proto 编译器生成,把"包名.服务名"翻译成强类型的方法集合。Stub 是薄层——它不做连接管理、不做重试,只负责把方法调用与参数对象交给下一层。
第三层,拦截器链。横切逻辑的挂载点:日志、鉴权、链路追踪、自定义重试都住在这一层。客户端拦截器在调用前后介入,可以改写元数据、观察状态、甚至短路调用。第 5 章的主角。
第四层,Channel 通道。重量级容器:管理 HTTP/2 连接(建立、复用、健康检查、断线重连)、承载负载均衡策略、维护解析器与配置。Channel 是框架在客户端的核心资产。
第五层,HTTP/2 传输。3.1 节与 3.2 节的全部内容:帧、流、头部压缩、消息封装。
分层架构透视
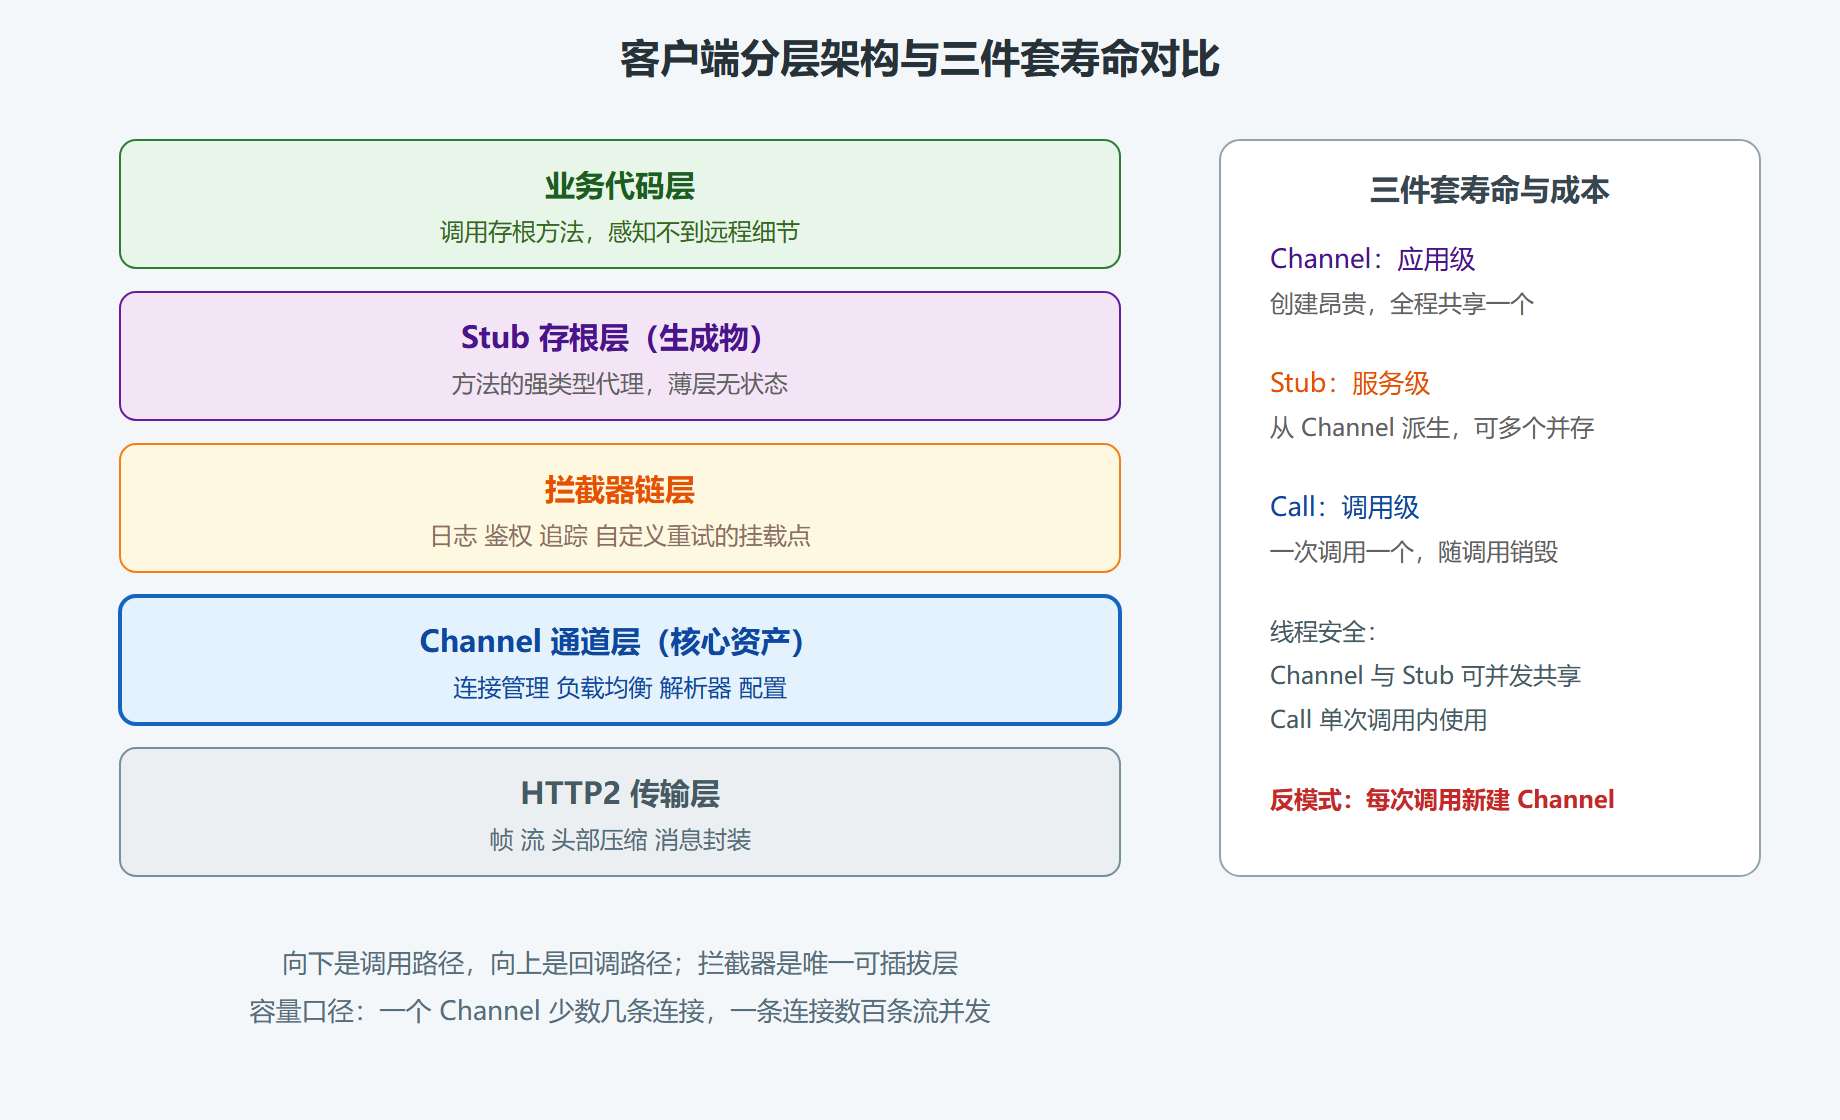
这个分层最重要的实践含义是问题的定位层级:调用报错先看拦截器层有没有人短路(自定义鉴权失败常在这里);连接层面的诡异问题(断连、握手失败)在 Channel 层;报文与协议问题(3.2 节的悬案类型)在传输层。层次不清时,排障会在错误的层面空转。
二、Channel:贵重资产的管理学
Channel 的创建成本高:要解析目标地址、建立 TCP 与 HTTP/2 连接、初始化 HPACK 状态、准备负载均衡器。正确的用法是应用生命周期内共享一个 Channel(同一目标服务),所有调用走它的多路复用能力。
三个管理规范:
**规范一,一个目标一个 Channel,别按请求建。**每次调用新建 Channel 等于每次调用重新握手、重建 HPACK 状态,高并发下连接数与端口消耗失控。这是从 HTTP/1.1 客户端思维带过来的最大反模式(3.2 节的坑位提醒再次适用)。
**规范二,理解目标寻址的三种形态。**Channel 的目标字符串有语法:固定地址列表(如 静态地址:端口,地址:端口 形式)、DNS 名字(解析出地址池,配合轮询等策略)、以及 dns:///名字、ipv4:///地址 这类带 scheme 的显式形式。自定义 scheme 还能挂接自定义解析器——第 5 章服务发现就靠这个机制把 Consul、Kubernetes 等注册中心接进来。
**规范三,优雅关闭。**应用退出时调用 Channel 的关闭方法:等待在途调用完成、发送 GOAWAY、释放连接。粗暴退出会导致下游服务在窗口期内报连接错误,滚动发布场景下这类噪音会污染告警。
负载均衡在 Channel 里的位置要有个认知:Channel 内部有解析器(名字变地址)与负载均衡器(地址里挑一个)两个组件。默认行为各语言不同——多数实现默认在解析出的地址间轮询(朴素的客户端负载均衡),更精细的策略(加权、亲和、按后端负载)在第 5 章展开。这里先记住结构性事实:客户端负载均衡是 gRPC 的一等公民,不需要外部 LB 也能工作。
💡 关键直觉:把 Channel 当数据库连接池理解——贵、可共享、要配置上限、要优雅关闭。两者连反模式都一样:按请求建连接。
三、Stub:生成物的薄层哲学
Stub 由 protoc 生成,绑定在一个 Channel 上,提供该服务的全部方法。它有多形态的用法层次:同步阻塞调用(简单直接,占用调用线程)、异步调用(回调或 future 形态,高并发友好)、以及流式方法返回的流句柄。
Stub 的选择是并发模型的预选。同步 Stub 在高并发下每调用占一个执行流,代码直观但扩展性受限;异步 Stub 把等待从线程中剥离,吞吐上限更高但代码复杂度上升。工程建议:低并发内部工具用同步足矣;核心链路高并发场景用异步或语言原生的协程封装。
一个常被忽略的细节:Stub 上可以叠加配置派生子 Stub——设置调用超时、认证令牌、压缩开关的"定制版存根"。共享同一个 Channel 的前提下,不同配置的调用各自用各自的 Stub 变体。这比"全局配置一刀切"灵活,也比"每个调用手工传参"干净。
四、Call:一次调用的状态容器
Call 是三件套里寿命最短的:一次方法调用从发起到 trailers 回来,Call 对象承载全程状态——流的编号、超时预算的剩余、取消标志、元数据快照。
理解 Call 的价值在于调用级控制 API 的存在感:
- 取消:对未完成的 Call 发起取消,流被重置,服务端收到信号(3.3 节讲过的传播机制);
- 双端元数据:初始元数据(随请求头部走)与尾部元数据(trailers 里回来)都可异步获取;
- 调用信息:对端安全信息、压缩情况等诊断接口。
日常业务代码很少直接操作 Call——超时在 Stub 层配置、取消由上下文传播。但在两处会真实接触它:一是实现通用中间件时(拦截器里拿 Call 上下文做文章),二是排障时(从 Call 状态读出"到底超时在哪一跳")。
五、把三件套用到工程里:一份容量与纪律清单
容量口径:一个 Channel 通常维持到目标服务的少数几条连接(健康时可能就一条主连接),一条 HTTP/2 连接承载数百条并发流。推算:目标服务 10 个实例、每实例预期 200 并发调用,客户端侧一个 Channel 加客户端负载均衡即可覆盖,无需多 Channel。真正的上限来自服务端并发模型(4.2 节)与单连接吞吐(第 6 章调优)。
换个角度理解这个口径的宽裕度:连接层的容量瓶颈在 HTTP/1.1 时代是"连接数 × 每连接并发 1",在 gRPC 时代变成"连接数 × 每连接数百流"——放大了两个数量级。所以多数业务的连接层永远不会成为瓶颈,真正先到顶的是服务端执行流(第 4.2 节的线程账本)或下游依赖(数据库连接池)。把调优精力按这个顺序排,别一上来就折腾连接参数。
纪律清单:
| 场景 | 正确做法 | 错误做法 |
|---|---|---|
| 应用启动 | 创建共享 Channel,注册拦截器 | 在每个请求处理函数里建 Channel |
| 多目标服务 | 每目标一个 Channel,集中管理 | 全局一个大 Channel 换目标(不支持) |
| 配置差异 | 派生不同配置的 Stub | 复制 Channel 来改配置 |
| 应用退出 | 优雅关闭,等待在途调用 | 直接杀进程留一堆半开连接 |
| 单元测试 | 用进程内服务器或假实现 | 测试里连生产地址 |
⚠️ 常见坑:把 Channel 存进按请求创建的对象里(比如每次 Web 请求 handler 里 new 一个客户端对象包着 Channel)。Web 框架的请求对象寿命是毫秒级,Channel 跟着它生灭,等于回到了"按请求建连接"的老路。正确姿势是客户端对象全局单例,依赖注入传递。
常见问题
问:Channel 会不会成为单点瓶颈?
单 Channel 单目标的多路复用在绝大多数场景足够。确实成为瓶颈时(单连接吞吐打满),部分实现支持配置连接数或自动扩展连接,属于第 6 章调优话题。
问:怎么确认我的 Channel 管理是健康的?
三个健康信号:连接数稳定(不随流量峰谷大幅波动)、没有频繁的连接重建日志(握手风暴的征兆)、优雅停机时在途调用正常排空。反过来,任一信号异常,先查"有没有人在按请求建 Channel"——这个反模式的能见度最低、发生率最高。
问:多个不同服务可以共用一个 Channel 吗?
不行也不必。Channel 绑定目标(一个名字解析出一组地址),不同目标各建各的。Channel 数量等于依赖服务数量,仍然远小于连接池时代的连接数。
问:Channel 数量等于依赖服务数,几十个依赖岂不是要几十个 Channel?
是的,但这是健康状态——几十个 Channel 各自维持一两条连接,总量仍是几十条连接,比连接池时代"每服务每实例一条"的笛卡尔积少了量级。真正要警惕的是"每个请求处理上下文里建 Channel"这种动态创建模式,静态可数的 Channel 集合才是可运维的。
问:Stub 能动态换目标地址吗?
能,但走的是 Channel 的解析器刷新机制(DNS 重新解析、自定义解析器推送新地址),而不是改 Channel 目标。服务发现场景下地址变更是常态,第 5 章详细讲。
本节速览
- 客户端五层:业务代码、Stub、拦截器链、Channel、HTTP/2 传输;层次感直接决定排障效率。
- 三件套寿命从长到短:Channel 应用级、Stub 服务级、Call 调用级;前两者线程安全可共享。
- Channel 是贵重资产:一个目标一个、全程共享、优雅关闭,管理与数据库连接池同构。
- 负载均衡内置于 Channel:解析器加均衡器两个组件,客户端 LB 不需要外部设施。
- Stub 的形态是并发模型预选:同步直观、异步高吞吐;配置差异用派生 Stub 表达。
- Call 承载调用级控制:取消、元数据、诊断信息,中间件与排障时的抓手。
客户端讲完,下一节到对端:服务端的组件栈、方法分发机制,以及最容易被问住的"一个 gRPC 服务端到底能扛多少并发"——答案藏在同步模型与流式模型的线程账本里。