5.2 服务发现与负载均衡
5.2 服务发现与负载均衡
本节摘要:gRPC 的流量调度由 Channel 内的名字解析器与负载均衡器协作完成:解析器把服务名翻译成地址集,均衡器按策略挑地址。本节讲这两种组件的协作机制、DNS 与注册中心与 Kubernetes 三类地址来源的接入方式、健康检查如何剔除坏实例,以及客户端负载均衡与代理负载均衡两条路线的对比选型(含代理无关 LB 标准对这条之争的调和)。
先说结论
阅读完本节,你应当能够:
- 解释解析器、均衡器、健康检查三组件在 Channel 内的协作闭环;
- 说出 pick first 与 round robin 两种内置策略的行为差异;
- 接入 DNS、注册中心、Kubernetes 三类地址来源并知道各自的刷新特性;
- 在客户端 LB 与代理 LB 两条路线间做有依据的选型;
- 避开"HTTP/1.1 思维迁移"造成的经典负载均衡事故。
一、先讲一个事故:LB 后面的单热点
一个常见的事故形态值得作为入口。团队从 REST 迁移到 gRPC,负载均衡架构原样保留:客户端连 LVS 或 Nginx,代理分发到后端。上线后监控发现流量全打在一个后端实例,其他实例闲着,单实例被打爆。
原因藏在 HTTP/2 的长连接特性里:传统代理的负载均衡粒度是连接——每条新连接分给一个后端。REST 时代连接短命,按连接分配近似等于按请求分配,天下太平。gRPC 的 Channel 是长连接(4.1 节),一条连接上跑成千上万次调用,按连接分配就退化成"一个后端独享一个客户端的全部流量"。客户端数量少于后端数量时,必然出现空转实例与热点实例。
这个事故说明:gRPC 的负载均衡要按请求(准确说是按流)粒度调度,而这需要重新设计架构。gRPC 生态给出了两条路线。
二、路线一:客户端负载均衡
机制。4.1 节提过 Channel 内置了解析器与均衡器,现在展开它们的闭环:
- 解析器把目标名字翻译成地址集(看后文的地址来源),并持续监听变化;
- 均衡器拿到地址集,按策略为每个调用挑选地址(子通道);
- 健康检查(连接层面的连通性探测加上可选的标准健康协议)标记地址的可用状态;
- 地址集变化或健康状态翻转时,均衡器更新挑选集合——这一切对业务代码透明,Channel 照常接收调用。
内置策略两个要分清:pick first(默认)——顺序尝试地址列表,用第一个能连通的,之后的调用都走它;round robin——在所有健康地址间轮流分配。pick first 适合"目标本身是个高可用入口"(如一个域名指向一个虚拟 IP),round robin 适合"地址集就是后端实例列表"。忘配 round robin 是新手高频坑:默认 pick first 下,多实例后端被当成"主备"用,流量不均。
地址来源三类:
| 来源 | 接入方式 | 刷新特性 | 适用 |
|---|---|---|---|
| 静态地址表 | 目标串直接列地址 | 不刷新 | 测试、固定小集群 |
| DNS | 目标串写域名 | 按 TTL 或配置周期重解析 | Kubernetes Service、云内网域名 |
| 注册中心 | 自定义 scheme 挂解析器(Consul、etcd 等) | 订阅推送,秒级感知 | 自建注册中心的微服务体系 |
Kubernetes 场景值得单独说:Service 域名解析出的是集群虚拟 IP(kube-proxy 转发),流量仍按连接粒度调度——又要踩第一节的热点坑。两种解法:无头服务(headless service)让 DNS 直接返回 Pod IP 列表,客户端 round robin 到每个 Pod;或走代理路线(下节)交给网格或专用代理。生产上后者更常见,因为客户端 LB 有它自己的账要算。
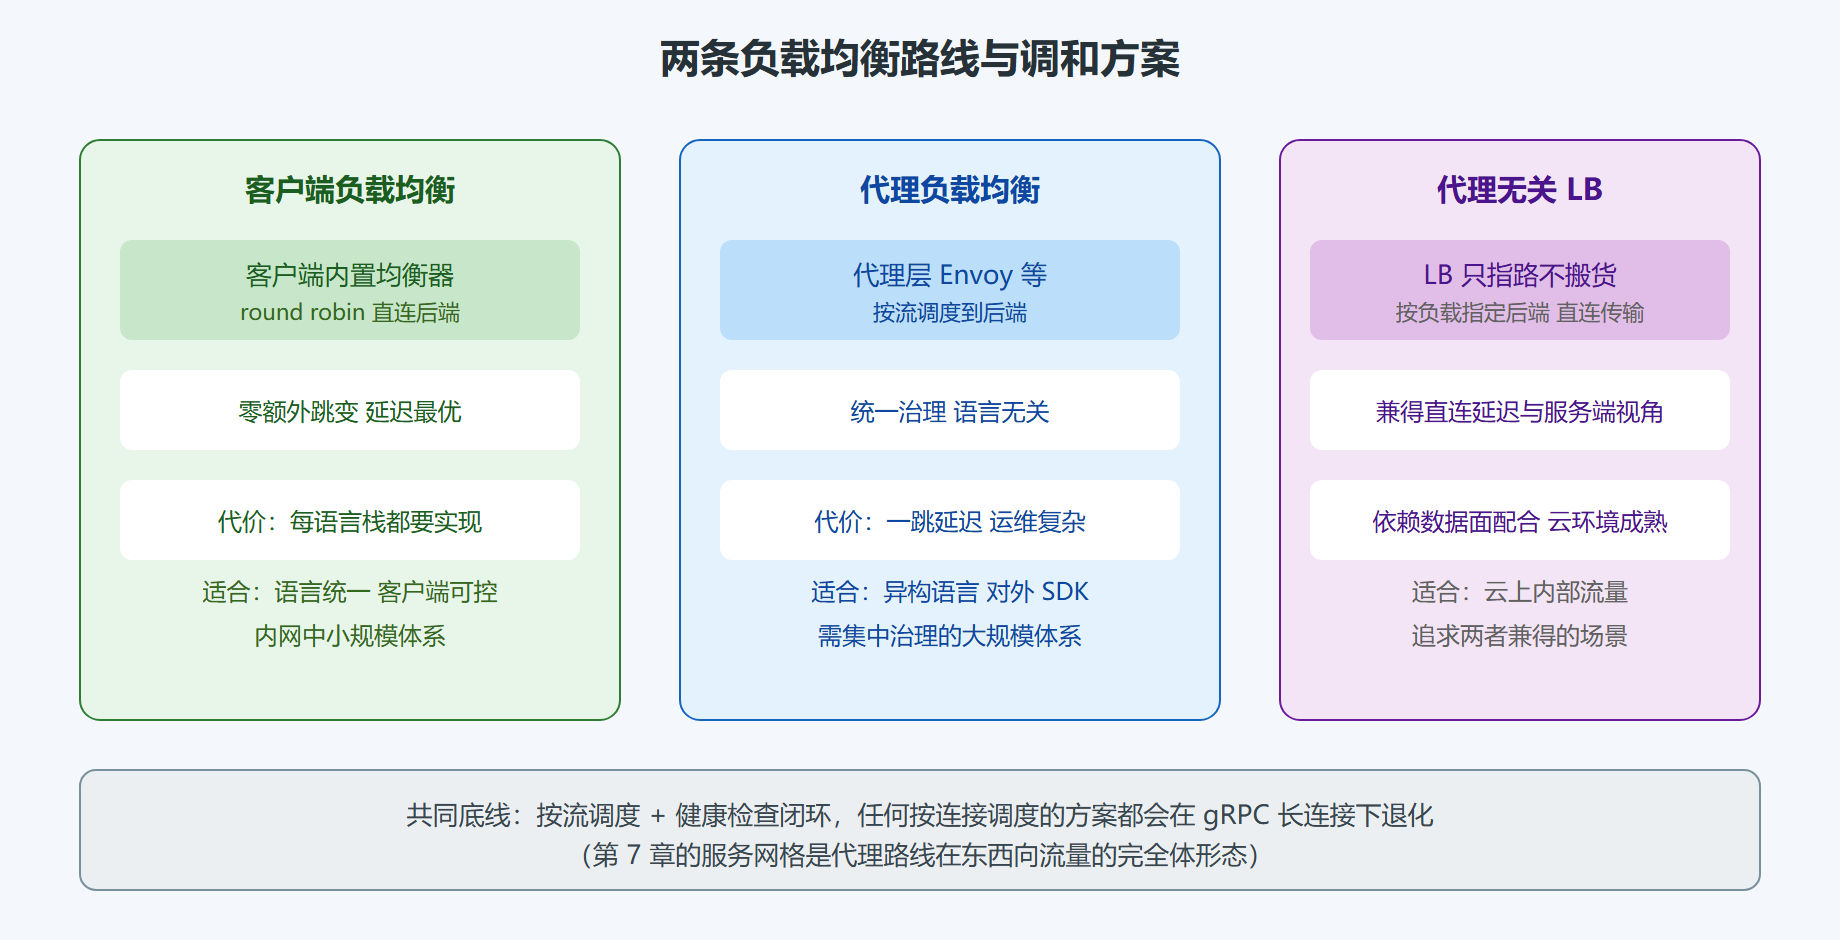
客户端路线的代价:策略逻辑进了每个客户端的运行时——异构语言意味着每个语言栈都要有成熟的均衡实现;策略升级(比如从轮询改加权)要推动所有客户端发版;故障排查时"流量为什么去那台"的答案散落在各客户端版本里。小规模、语言统一的体系里客户端路线简单直接;规模与异构度上去后,代理路线登场。
三、路线二:代理负载均衡
架构:客户端连代理,代理维护到全部后端的连接池,按请求粒度(gRPC 代理按流调度)分发。代理成为独立的容量与治理层:连接收敛(南向连接数 = 客户端数 + 后端数,远小于客户端 × 后端的网格全连接)、统一治理(限流、熔断、灰度都在代理做)、语言无关(客户端只要会连一个地址)。
代价同样清晰:一跳延迟、代理自身的容量与高可用设计、运维复杂度上升。选择判据是规模与异构度:语言三种以上、客户端团队不可控(对外提供 SDK 的场景)、需要在服务端统一治理的,代理路线的收益开始超过成本。
代理的选型上,Envoy 是事实标准之一(gRPC 原生支持、xDS 动态配置),专用 gRPC 代理与负载均衡器(含各云厂商的 gRPC LB)也都是成熟选项。选型时确认一个硬指标:支持 HTTP/2 后端与按流调度,只会按连接调度的传统代理会把热点坑原样奉还。
四、调和者:代理无关负载均衡标准
两条路线之争在近年出现调和方案:代理无关 LB(最初称内部 LB)。思路是把代理的"服务端视角"与客户端的"零延迟"结合——负载均衡器不转发流量,而是参与客户端的地址挑选:客户端按约定携带负载均衡地址的元数据,LB 依据后端负载与健康状况指定本次调用的目标后端,客户端直连该后端。
五、健康检查的闭环细节
无论哪条路线,"判断实例可用"都是闭环的关键一环。gRPC 定义了标准健康检查协议:服务端实现它、报告自身与各服务的健康状态(服务名粒度,不只是进程粒度——"进程活着但依赖的数据库挂了"可以报告特定服务不健康),客户端或代理定期查询。
工程要点三条:
- 健康状态要反映真实服务能力。健康检查实现里检查关键依赖(下游连通、缓存可用),别只返回常量真——一个"假活"实例会持续接流量然后持续失败。
- 优雅停机与健康下线联动。4.2 节的优雅停机序列里,第一步就该把健康状态置为不健康,等 LB 与客户端的均衡器把它们摘除,再开始排空。顺序反了,摘除延迟期内新流量还在进。
- 检查频率与超时要匹配故障感知窗口。秒级检查、亚秒超时是常见配置;太松故障感知慢,太紧网络抖动会造成误摘与流量震荡。
⚠️ 常见坑:round robin 策略下某个后端持续失败,均衡器会把它移出轮询,但恢复检测依赖健康检查的周期——如果健康检查没配置或间隔过长,这个实例会被"雪藏"很久,扩容后实际承载流量的实例数比预期少。上线后核对"在轮询集合中的实例数"与"实际部署实例数"是否一致。
💡 关键直觉:gRPC 负载均衡的全部复杂性,都源自"长连接 + 多路复用"把传统"按连接调度"的地基抽走了。理解了这一点,两种路线、无头服务、代理无关 LB 的设计动机都不再需要背。
常见问题
问:客户端 LB 和服务端重试同时开着,会不会放大流量?
会,这正是 5.3 节的主题。均衡器换地址的"重试"与显式重试策略要统一设计,避免一次失败被多层各重试一遍。
问:无头服务直连 Pod,滚动发布时怎么保证不打到正在退出的 Pod?
靠优雅停机的配合:Pod 收到退出信号先置不健康(健康协议或端点摘除),客户端解析器刷新或健康检查感知后停止发新流量,Pod 再排空在途调用。DNS 的刷新延迟是这个方案的弱点,追求秒级感知就上代理路线或注册中心推送。
问:代理层会不会成为新的单点?
会,所以代理自身要冗余(多实例加前置虚拟 IP 或客户端侧代理列表)。代理的高可用设计是引入这条路线时必须一并支付的工程成本。
问:怎么验证我的负载均衡真的在工作?
看两个数据:服务端各实例的 QPS 分布(5.2 节的热点问题在指标上一目了然——各实例 QPS 方差大就是没均衡);客户端侧"在轮询集合中的实例数"与"实际部署实例数"是否一致。把这两个检查做成上线后的固定动作,能拦住绝大多数均衡配置问题。
问:客户端版本参差,有的还没配 round robin,怎么办?
这正是代理路线存在的理由之一——客户端行为不可控时,把均衡逻辑收到服务端可控的代理层。改造不了的老客户端,让它们连代理入口而不是直连后端地址,由代理保证按流调度。
温故知新
- 热点事故的根源:长连接让"按连接调度"退化为单后端独享流量,gRPC 的均衡必须按流粒度。
- 客户端 LB 是 Channel 内置能力:解析器给地址集、均衡器挑地址、健康检查守状态,闭环对业务透明。
- 默认 pick first 不是负载均衡:多实例后端要显式配 round robin,这是新手第一坑。
- 地址来源三档:静态表不刷新、DNS 按 TTL、注册中心秒级推送,按感知需求选。
- 代理路线换取统一治理与语言无关:代价是一跳延迟与代理自身的运维,规模与异构度是判据。
- 代理无关 LB 调和两条路线:LB 指路不搬货,云上内部流量的新选项。
- 健康检查要"真活":检查关键依赖、与优雅停机联动、频率匹配感知窗口。
地址与流量的问题解决后,下一节面对"实例就是失败了"的世界:超时预算怎么定、哪些错误值得重试、重试怎么不演变成风暴、以及什么时候应该干脆地失败。