5.3 超时重试与弹性容错
5.3 超时重试与弹性容错
本节摘要:分布式系统的故障不是意外而是常态,弹性设计的目标是把故障控制在局部。本节讲三件武器:deadline 超时预算(及其跨服务传播的语义)、重试策略(按状态码分类、指数退避、预算控制)、快速失败与"有限重试"的智慧——以及那个最重要的问题:什么时候不该重试。
核心问题
阅读完本节,你应当能够:
- 设计带传播语义的超时预算体系并解释预算递减机制;
- 按状态码分类设计重试策略并识别不可重试错误;
- 用指数退避加抖动与重试预算防止重试风暴;
- 在重试、快速失败、熔断之间做出场景化选择;
- 排查"超时了但不知道超在哪"类故障。
一、从一个雪崩现场说起
一个经典的事故链:网关调用订单服务设了 10 秒超时,订单服务调用库存服务设了 10 秒超时,库存数据库慢查询。库存服务的方法在数据库上等 9.8 秒返回;订单服务拿到结果再处理,自己已经耗尽预算,网关侧超时放弃。但订单与库存两侧的执行流都被白白占了近 10 秒——每个失败的用户请求都在系统里留下了两个僵尸任务。流量一高峰,线程池(4.2 节的容量账本)被僵尸任务占满,健康的请求也进不来,服务整体假死。故障从一个慢查询放大成了整条链路的瘫痪。
雪崩的每一环都可以被剪断:每一跳设置递减的超时预算(上游 10 秒,下游最多 8 秒),下游超时快速失败释放执行流;下游过载时上游主动降低压力而不是加重。这就是本节三件武器的用武之地。
二、deadline:会传播的超时预算
gRPC 的超时不是每跳独立计时,而是贯穿调用链的预算。3.2 节讲过机制:客户端发出调用时在 grpc-timeout 头部写入预算(如 5S),每经一跳,中间服务读取剩余时间再向下传递。上游的耐心精确地约束着整条链路。
预算递减是关键设计。调用链 A → B → C,A 给总预算 3 秒:A 调 B 时声明 3 秒;B 处理自己的逻辑花了 0.5 秒后调 C,此时剩余 2.5 秒,B 调 C 的预算就是 2.5 秒。C 永远不可能"超掉 A 的耐心",因为它的预算是 A 的剩余量。对比"每跳独立超时"的设计(预算不传播),后者会出现下节雪崩案例的僵尸任务:上游已放弃,下游还在自顾自地跑。
预算怎么定是工程判断题。三个锚点:业务耐心(用户能等多久,交互接口 1 秒级、后台任务分钟级)、正常耗时的分布(P99 耗时加余量,别拍脑袋)、下游预算的加总(你的预算要覆盖你对下游的等待加自己的处理)。三者取最小可行值。
超时的状态语义:预算耗尽时,发起方收到 DEADLINE_EXCEEDED。这里有个高频困惑——"到底是谁超时了"。区分方法看传播:客户端超时预算耗尽,客户端侧取消传播到服务端,服务端的调用上下文也会以取消告终。第 6 章观测体系里,把每跳的"预算剩余量"打进日志,这个问题就有了数据答案。
三、重试:第二件武器,也是最锋利的一件
超时解决"失败得快",重试解决"失败得少"。但重试是双刃剑:对端过载时的重试是往火里浇油。
第一问:哪些错误值得重试。用 3.2 节的状态码做分类判据:
| 状态码 | 重试价值 | 原因 |
|---|---|---|
| UNAVAILABLE | 高 | 典型的瞬时不可达:连接断、实例下线、瞬时抖动 |
| DEADLINE_EXCEEDED | 谨慎 | 只在预算充裕且明确是瞬时抖动时;否则是浪费 |
| RESOURCE_EXHAUSTED | 谨慎 | 限流拒绝:带退避重试或直接降速,看语义 |
| UNAUTHENTICATED | 无 | 令牌问题,重试不变结果 |
| INVALID_ARGUMENT | 无 | 参数错误,一万次重试也不会对 |
| NOT_FOUND | 视语义 | 资源确实不存在则无价值;主从延迟场景可小成本重试 |
幂等性是重试的前置条件。非幂等的写操作(创建订单、扣款)盲目重试会造成重复副作用。规范做法:写接口带幂等键(客户端生成唯一标识,服务端识别重放),或把非幂等调用排除在自动重试之外。
第二问:重试几次、隔多久。指数退避是标配:首次重试等 50 毫秒,翻倍到 100、200、400 毫秒,两三次后放弃。必须加抖动(随机偏移)——否则同一时刻失败的一批调用会在同一时刻集体重试,形成同步脉冲。
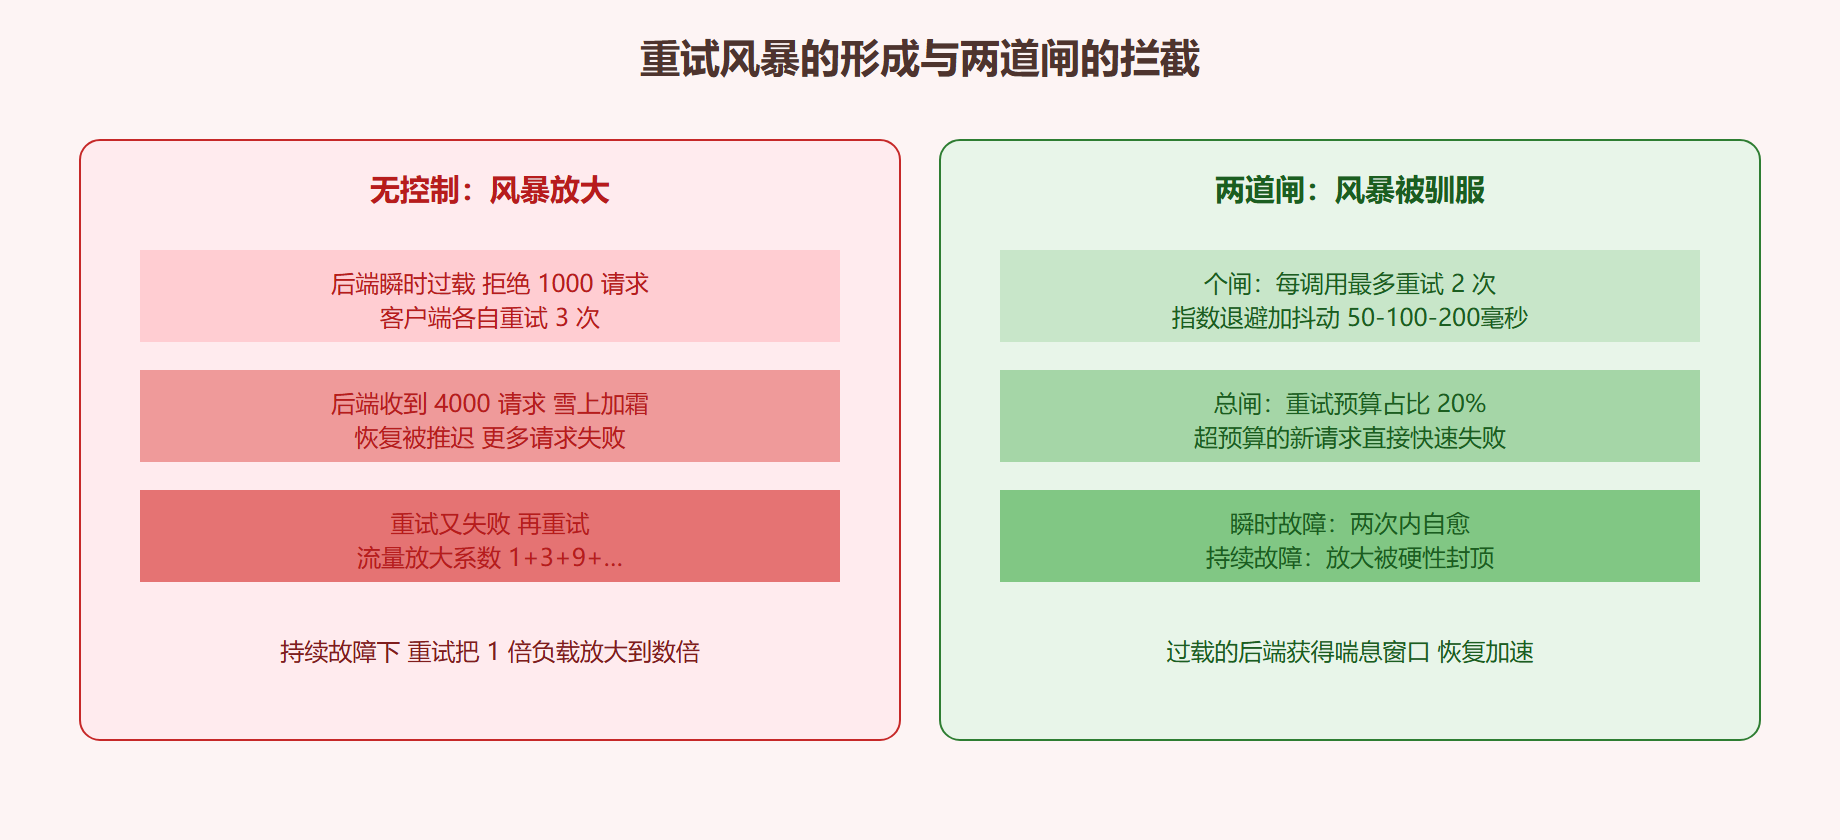
第三问:谁来控制总量。这是重试设计的灵魂,也是"重试风暴"的解药。两个机制:重试预算——服务端视角的总闸:设定"重试流量占比上限"(如 20%),超过则新请求不再自动重试,直接快速失败;每调用重试上限——客户端视角的个闸:默认 1 到 2 次,绝不超过。两道闸配合,瞬时故障能自愈、持续故障不放大。
四、第三件武器:快速失败与"主动熔断"
重试对付瞬时抖动,快速失败对付持续故障。当上游已判定下游"这会儿别指望了",正确的动作是本地直接拒绝,不再消耗网络与下游的接客成本。形态有两级:
按次快速失败:负载均衡器发现某地址连续失败(4.2 与 5.2 节的健康状态),把它摘出挑选集合——对该地址的失败就此止步。
熔断器:对"服务"而非"地址"的保护。统计滑动窗口内的失败率,超过阈值(如 50% 且样本量足够)则打开熔断:一段时间内对该服务的调用直接本地失败,不再发网络请求;间歇放行少量探测请求,成功率高了再闭合。熔断的价值是在下游病重时给它病床——所有流量都停下来,让它专注于恢复,而不是被无效流量继续压垮。
熔断的配置要有克制:窗口太短会被几个偶发失败触发,太长则保护滞后;半开探测的流量要小(一两个请求足够)。熔断打开时的用户侧表现要提前设计——降级到缓存数据、排队稍后通知、还是明确报错,这是产品决策不是技术决策。
三者协作的分工表:
| 手段 | 对付什么 | 作用位置 | 失控形态 |
|---|---|---|---|
| deadline 预算 | 慢(拖垮上游的等待) | 每次调用的元数据 | 预算过松僵尸任务堆积 |
| 重试(带退避与预算) | 瞬时抖动 | 客户端策略 | 无退避无预算则风暴 |
| 熔断 | 持续故障 | 客户端或代理层 | 参数过敏则误熔断 |
⚠️ 常见坑:多层各自配置重试——客户端 SDK 重试一层、内部代理重试一层、下游语言客户端又一层。一次失败被放大成八次十六次请求。治理原则:整条链路只有一个层面持有重试权(通常是最贴近用户的入口层),其余层只做快速失败与熔断。
💡 关键直觉:弹性设计的中心思想是"失败要快、要局部、要有限"。deadline 保证快,熔断保证局部,重试预算保证有限——三者共同把"故障的爆炸半径"圈在最小范围。
常见问题
问:重试会不会破坏消息顺序或造成重复副作用?
一元调用没有顺序问题;重复副作用靠幂等键防御。流式调用不走协议层自动重试(3.3 节的结论),靠应用层断点续传。
问:deadline 设了 3 秒,方法里还写了忙等循环检查剩余时间,有必要吗?
有必要且推荐。框架的取消是协作式的:预算耗尽后框架标记取消,但你的代码不检查就继续跑。长任务里周期性检查调用上下文的取消状态(3.3 节的纪律),才能让"快失败"真正落地。
问:怎么区分"我超时"还是"下游超时"?
看收到 DEADLINE_EXCEEDED 时预算的归属方:你在自己预算内等到失败,是下游报的超时;你自己预算先耗尽,是你取消的传播。第 6 章会把每跳预算剩余量打进追踪,定位就自动化了。
问:重试预算这个"总闸"在客户端怎么实现?
常用形态是滑动窗口内的尝试总量统计:窗口内(如 10 秒)的总尝试次数超过总请求数乘以预算比例(如 1.2 倍)时,新的重试请求直接放弃、按普通失败处理。部分语言的 gRPC 实现已内置该机制(服务配置里声明),没有内置的用拦截器实现一个共享的计数器即可——关键是计数器要跨调用共享(进程级单例),而不是每次调用各算各的。
问:熔断打开后,那些被本地拒绝的请求怎么办?
这正是 5.3 节开头说的"产品决策":查询类可以降级读缓存或返回兜底数据,写类只能明确报错并引导稍后重试。切忌静默返回假成功——熔断的目的是保护系统,不是掩盖故障。
要点速记
- 雪崩的链条是僵尸任务占满容量:每跳独立超时 + 无快速失败 = 故障放大器;剪断点在递减预算与快速释放。
- deadline 是贯穿链路的预算:每跳传递剩余量,下游永远超不过上游的耐心;预算取业务耐心、P99 加余量、下游加总三者的最小可行值。
- 重试前置两问:错误可重试吗(状态码分类)、操作幂等吗(幂等键兜底)。
- 重试的标配是指数退避加抖动,灵魂是两道闸——每调用上限个闸、重试预算占比总闸。
- 熔断给病重的下游病床:失败率触发、半开探测恢复;打开时的用户侧表现要提前设计。
- 整条链路只有一个层面持有重试权,多层各重试是事故配置。
- 重试总闸是进程级共享计数:滑动窗口内尝试总量超限即放弃重试,单例计数器跨调用共享才有效。
- 中心思想:失败要快、要局部、要有限——deadline、熔断、预算分别对应三个性质。
最后一节进入信任问题:链路上的字节要加密(TLS 与 mTLS),调用双方要验明正身(令牌认证),服务之间还要讲权限的最小化——安全是治理的收口。