4.2 漏洞分析:从扫描到验证
4.2 漏洞分析:从扫描到验证
本节摘要:漏洞扫描器是"假设生成器"而不是"结论生成器"。本节讲扫描器的工作机理(识别 → 比对 → 报告)、误报与漏报的来源、把扫描结果加工成三态清单(已确认 / 待验证 / 误报)的验证闭环,以及扫描节奏与授权约束的关系。
承接 4.1 的漏斗:侦察域产出的是"资产画像 + 风险假设"。本节的漏洞分析域接过假设,负责把它们加工成可写进报告的"已确认风险"。
扫描器到底在做什么
把扫描器拆开看,核心是三步循环:识别(这是 4.1 做的事——确认目标运行什么服务、什么版本、什么配置)、比对(把识别结果与漏洞特征库做匹配)、报告(把匹配命中输出为"发现")。理解这三步,扫描器的两类固有缺陷就自然浮现:
误报(报了但不存在):比对依据是版本号或特征,而版本号可能被改过、补丁可能已经回移(发行版常把修复打进旧版本号)。于是"这个版本有漏洞"的推断可能不成立。
漏报(存在但没报):特征库没覆盖、识别环节没认出服务、或目标在网络层过滤了探针。扫描器的清洁输出从来不等于目标干净。
结论:扫描器生成的是假设,验证才产生结论。这个定位决定了它在流程里的正确用法——批量生成候选,人工逐条确认。
验证闭环:把假设加工成结论
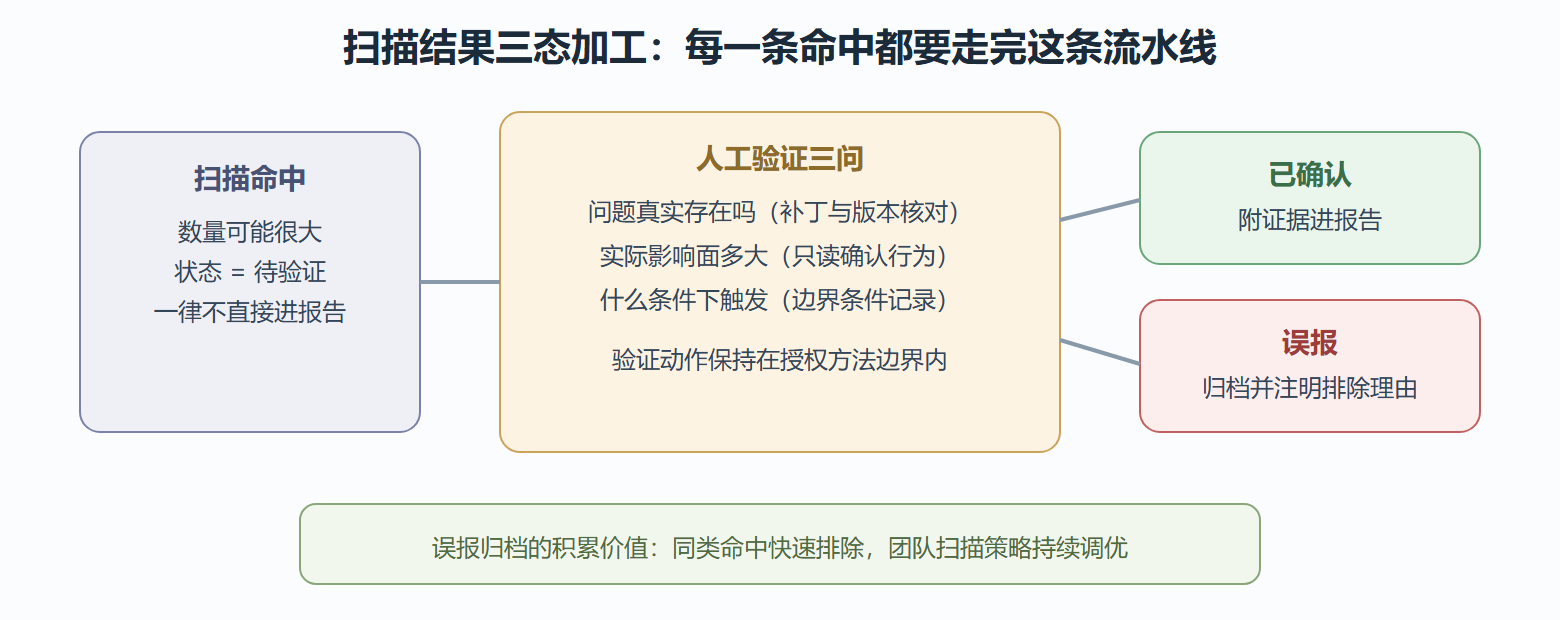
验证不等于"把利用跑一遍"。在授权测试的语境里,验证要回答的是三个问题:问题真实存在吗、实际影响面多大、什么条件下触发。以下用靶场演示这条闭环。
背景:对 Metasploitable 靶机扫描后,扫描器报告某服务存在已知弱点。
操作:第一步核对原始证据——回到 4.1 落盘的扫描输出,确认这条发现的判定依据(版本号还是特征响应)。第二步核对补丁状态——查该发行版的安全公告,确认这个版本是否已回移修复。第三步最小代价验证——在靶机上用只读方式确认问题行为(比如该服务是否允许匿名访问、是否暴露了不该暴露的接口),不做任何超出"确认存在性"的动作。
结果:三步走完,这条发现被确认为真实存在,影响面是"未授权用户可读取共享资源"。
解读:报告条目从此可以这样写——风险描述、判定依据、验证方法、影响面、修复建议(关闭匿名访问并升级版本)、复测方式。每个字段都来自验证环节的记录,而不是扫描器的原始输出。
变式:若第二步发现补丁已回移,这条就是误报——但它值得归档而不是删除,备注"版本回移导致误报,复核日期",下次扫描再遇到同类命中时可以快速排除。误报归档积累起来,就是团队的扫描器调优手册。
# 靶场上的验证类操作示例(只读确认,不做破坏动作) nmap --script=vuln 192.168.56.102 -oN vuln-scan.txt # 输出片段: # PORT STATE SERVICE # 21/tcp open ftp # | vulners: ... 版本比对类命中,全部进入待验证清单 # 人工核对:直接查询服务行为而不是依赖脚本结论 curl -sI ftp://192.168.56.102/ 2>&1 | head -5 # 确认匿名访问策略——这是"影响面"字段的事实来源
图 扫描结果的三态加工
扫描节奏:技术问题也是合同问题
扫描强度不只是技术参数。一次全端口、全脚本、并发放开的扫描,对老旧设备可能是实质性的压力测试——这就是授权书里"速率约束"条款存在的原因。实践上有三条节奏经验:
其一,分级扫描。 先低强度摸清资产分布,再对重点资产做深度识别,最后只对明确目标做脚本级核查。粗筛到精查,每级之间留出结果分析时间。
其二,避开业务窗口。 时间条款通常已约定窗口;额外要避开的是目标自身的批处理高峰、备份时段——这些时刻扫描引发的异常最难归因。
其三,全程留痕。 每次扫描的命令、时间、范围落盘。第五章复盘时会看到,这些记录既是报告的证据链,也是出现争议时的自证材料。
💡 一个值得养成的习惯:给扫描输出建一个固定的目录结构(按日期与资产分目录),命名带上扫描类型。第 5 章写报告时你会感谢现在的自己——"证据在哪"的检索成本,决定了报告写作的痛苦程度。
误报分析:三类来源与对策
把误报当作一个独立的认知对象来研究,是漏洞分析域进阶的标志。实战里的误报有三类典型来源,对策各不相同。
来源一:版本回移。 发行版把安全修复移植回旧版本号(保持兼容),扫描器的特征库只认"旧版本号等于有漏洞"。对策:查目标发行版的安全公告,确认补丁状态;这也是为什么 5.1 要求情报阶段收集目标的环境信息——知道发行版,才知道去哪里查回移记录。来源二:指纹误判。 服务横幅被自定义过、或探针响应被中间设备改写,识别出的版本本就错误,比对自然失真。对策:人工复核识别环节——直接与目标交互确认真实版本,再重跑比对。来源三:环境差异。 组件存在但未启用、路径不可达、依赖缺失——特征命中了"存在性",没验证"可达性"。对策:验证环节本来就该回答这个问题,影响面确认(4.2 的第二问)天然覆盖它。
三类来源对应三个不同环节的修正(情报、识别、验证),这个分布本身就是流程设计的辩护词:误报不能靠更贵的扫描器消灭,只能靠流程的环节分工消化。
一个误报归档的实战价值
讲一个归档发挥作用的场景。某团队连续三次测试都在同类资产上遇到同一批误报——某个中间件组件的版本号命中十余条已知问题,但逐一验证均为"已回移修复"。第四次测试时,新人面对同样的四十七条命中准备逐条验证,老人翻出归档记录:同类资产、同版本、同结论。四十七条瞬间压缩为"已归档排除模式",验证工作量从一天降到十分钟。
这个案例的方法论沉淀是一条组织规则:同一环境特征下的重复误报,验证一次、归档模式、复用结论。归档不是垃圾场,是团队的记忆——前提是归档时写清楚排除理由与适用条件(哪类环境、哪个版本区间),否则复用就变成了危险的经验主义。
归档之外还有一层组织收益值得点明:误报归档记录了"扫描器在这类环境里会怎么说谎",这是调优扫描策略的依据——比如对已知回移频繁的组件族降低自动比对的置信权重、把验证资源集中到高噪声区域。一个团队扫描策略的成熟度,很大程度上就体现在这些"知道哪里会骗人"的配置细节上。初学者的扫描器是出厂设置,熟手的扫描器带着本组织的伤疤记忆。
本节要点回顾
- 扫描器定位:假设生成器,误报与漏报是机理固有的,不是工具缺陷;
- 验证三问:真实存在吗、影响面多大、什么条件触发——回答它们才算结论;
- 三态清单:已确认进报告、待验证继续加工、误报归档注明理由;
- 节奏即合规:分级扫描、避开窗口、全程留痕,速率约束是合同条款;
- 验证姿势:只读确认存在性与影响面,不做超出授权的动作;
- 下一节接力:系统层的确认方法之外,应用层有自己的验证语言——Web 评估域的代理与重放。