4.1 信息收集与OSINT的守界用法
4.1 信息收集与OSINT的守界用法
本节摘要:信息收集是授权测试里贯穿全程的智力活动,分被动(不触碰目标)与主动(与目标交互)两层。本节讲分层递进的侦察模型、OSINT 的合规用法(只查自有与授权资产、只用公开数据源)、主动侦察的工具读法,以及"单一探测结论存疑"的交叉验证原则。
第四章的第一个功能域。它在流程里的位置最靠前,但作用贯穿始终——后续每个功能域的输入,都来自侦察阶段形成的资产画像。
一个反例开篇:侦察不是"先跑一遍 nmap"
不少初学者把信息收集等同于"对着目标跑一次扫描"。复盘这个误解的两个问题:其一,顺序错了——未经过被动侦察就主动扫描,等于在没看地图的情况下开车进陌生城市,扫描范围、强度、重点全靠猜;其二,姿势错了——主动扫描会在目标日志里留下记录,授权测试里这既是合规负担也是噪音,应该被动优先、主动精准。正确的开局动作是:先用公开数据源把目标的资产边界画出来,再让每一次主动探测都有明确目的。
还有第三层问题最容易被忽略:信息收集本身也需要边界意识。查公开数据不等于可以查任何数据——OSINT 的守界用法是"对授权范围内的资产,使用公开合法的数据源"。对个人社交媒体的挖掘、对员工的画像分析,即便技术上全是公开信息,也必须在合同明确允许的范围内进行,且数据要脱敏留存。第一章的六要素在这里直接生效。
分层递进的侦察模型
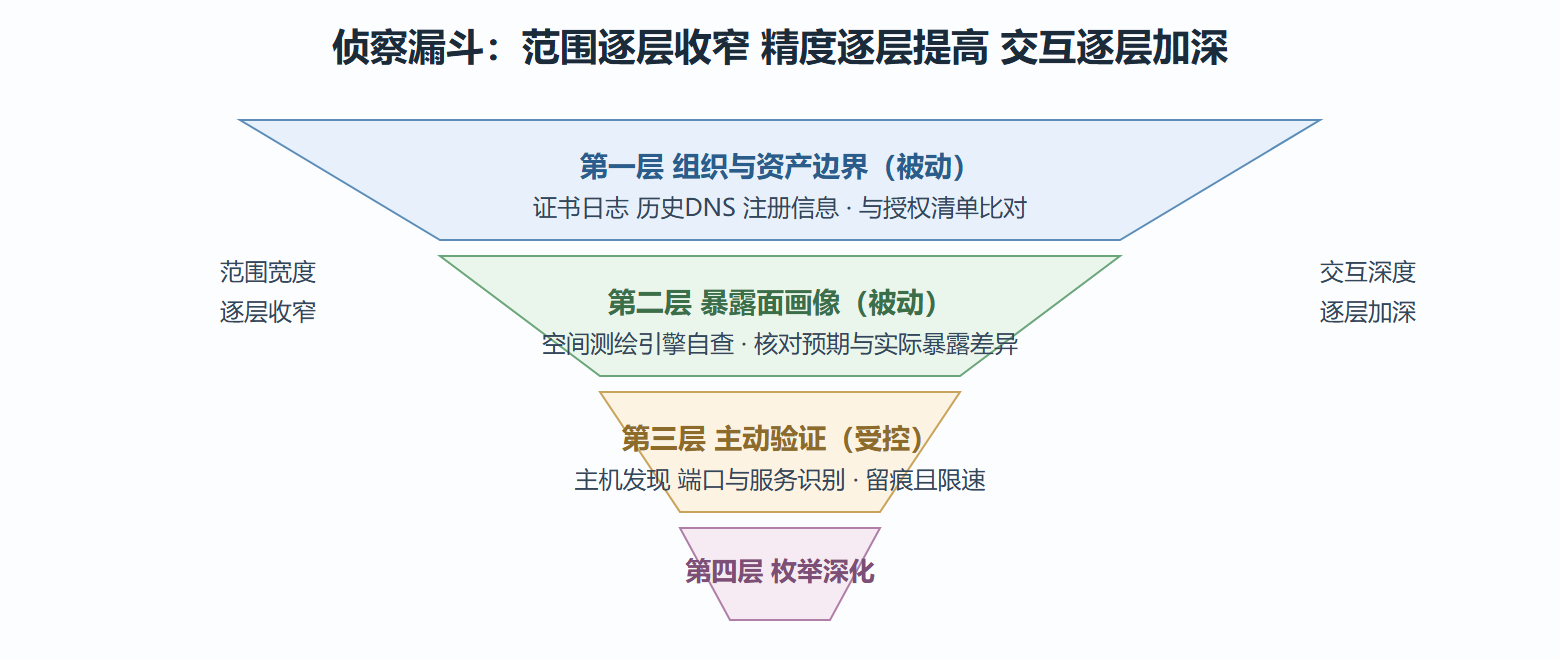
信息收集是一个"漏斗逐层收窄、精度逐层提高"的过程,可以拆成四层:
第一层:组织与资产边界(被动)。 用公开渠道确认目标组织的资产范围——注册信息、证书透明度日志里的子域名、历史 DNS 记录。这一层的产出是"哪些资产可能属于授权范围",用来与合同清单比对,发现清单外资产走第一章的变更流程。
第二层:暴露面画像(被动)。 网络空间测绘类引擎(如 Shodan、Censys 这类公开服务)收录了互联网设备的开放端口与服务横幅。对自有资产,用它核对"我们认为暴露的"与"实际暴露的"是否一致——这是防御方也高频使用的自查手段,也是 OSINT 守界用法的典型:查自己,用公开数据。
第三层:主动验证(受控交互)。 在授权与时间窗口内,对清单资产做主机发现、端口与服务识别。工具读法见下一小节。
第四层:枚举深化(受控交互)。 对识别出的服务做针对性枚举——DNS 记录、共享资源、用户名单示。这一层与目标的交互最深,也最需要在合同的方法边界内进行。
图 侦察漏斗与每层的验证义务
主动侦察的工具读法
以最常用的服务识别工具为例,在第三章的靶场上演示"参数背后的选择"。下面的命令都指向自建靶机。
# 主机发现:先确认靶场里谁在线(仅主机网段) nmap -sn 192.168.56.0/24 # 输出片段: # Nmap scan report for 192.168.56.102 # Host is up (0.00042s latency). ← 存活判定 # MAC Address: 08:00:27:xx:xx:xx (Oracle VirtualBox) # 服务与版本识别:从"端口开着"到"运行什么" nmap -sV 192.168.56.102 # 输出片段: # 21/tcp open ftp vsftpd 2.3.4 # 23/tcp open telnet Linux telnetd # 139/tcp open netbios-ssn Samba smbd 3.X - 4.X # 脚本扫描:默认脚本集做轻量核查(注意输出要逐条验证,脚本结论是假设不是事实) nmap -sV -sC 192.168.56.102 -oN lab-scan.txt # -oN 把结果存成可检索的文本,报告引用时直接取用
读这三段输出的要点:主机发现层注意存活判定的依据(ICMP 被过滤时要用其他证据交叉确认,第 3.3 节的教训);服务识别层注意版本号是"从横幅与探针推断的",存在伪装与误判可能;脚本扫描层的结论一律当假设,进入第 4.2 节的验证闭环。输出文件用 -oN 落盘,是"证据意识"的起点——报告里的每个结论都应能追溯到一份原始输出。
OSINT 侧的演示给一个自查向的例子:对自有域名做子域名梳理,用证书透明度日志或 DNS 枚举工具找出"还挂在线上但已被遗忘"的主机。这类"影子资产"是真实事件里最常见的入侵起点,也是防御方最欢迎的测试发现之一。
| 侦察产出 | 交叉验证手段 | 常见误判 |
|---|---|---|
| 主机存活 | 多种探测方式比对 | ICMP 被过滤误判为离线 |
| 服务版本 | 指纹库比对与人工确认 | 横幅伪造或版本推断过时 |
| 子域名归属 | 证书与解析记录双重确认 | 历史记录里的过期条目 |
| 空间测绘结果 | 与资产台账比对 | 数据滞后或 IP 复用 |
⚠️ 侦察阶段最常见的越界形态是"顺手多扫一段"。防御手段在 1.2 节已经给过:范围核对脚本。每次主动探测前过一道闸,让授权清单成为肌肉记忆的一部分。
侦察问答:四个实战疑问
问:被动侦察做到什么程度算够? 判据是"能否支撑假设"。当你已经能给目标画出资产边界、说出技术栈构成、列出与授权清单的比对结论,主动验证就有了精确目标——这时就该进入下一层。反过来,"再多查一点"的冲动如果答不出"查它验证什么假设",就是囤积(5.1 的纪律前移)。
问:侦察结果怎么组织成可用的资产清单? 最小可行结构是三列:资产标识、归属判定(范围内、清单外、待确认)、证据指针(哪次查询得出的)。第三列最常被省略,也最关键——两天后客户质疑"这台机器你们为什么测",你要能翻出当时的判定依据。
问:空间测绘引擎的数据准吗? 有滞后但仍有独特价值——它能看到"从外部视角"的暴露面,这恰好是防御方自查时最容易缺失的视角。使用姿势是"线索源"而不是"事实源":引擎给出的条目要与当前的实际解析交叉验证后才进清单。
问:侦察会暴露自己吗? 主动层会——目标侧的日志会记录交互。所以侦察计划要包含"留痕预算":哪些交互是必要的、强度多大、在什么时间窗内。这不是隐藏技巧,而是合同与信任层面的问题:测试方对留痕的可解释性,本身就是专业性的证明。
OSINT 的产出物:一份暴露面画像长什么样
给被动侦察一个具体的产出模板,避免"查了很多、留下很少"的空转。一份合格的暴露面画像包含四段:资产段(域名、子域、网段的清单与归属判定)、技术段(可见的技术栈构成与版本线索)、人员段(仅在合同允许时——与目标相关的公开角色信息,如技术岗位的招聘要求透露的技术栈)、异常段(与预期不符的发现:未被台账收录的主机、意外暴露的服务)。每段都注明数据来源与采集日期——画像是有保质期的,评估"这个画像还新鲜吗"要看日期而不是感觉。
异常段往往最有价值。"影子资产"——上线后被遗忘的测试机、离职员工留下的服务——是真实事件里最常见的突破口,而它恰好是被动侦察最容易的收获:不需要触碰目标,只需要比对"台账说的"与"公开可见的"之间的差集。
本节要点回顾
- 侦察不等于扫描:被动优先、主动精准,开局动作是画资产边界而不是跑工具;
- OSINT 守界:公开数据源 + 自有或授权资产 + 脱敏留存,三条缺一不可;
- 四层漏斗:边界、暴露面、主动验证、枚举深化,交互逐层加深;
- 输出即证据材料:
-oN落盘、可追溯、可引用,这是报告链的起点; - 单一结论存疑:主机存活、服务版本、子域名归属都需要交叉验证;
- 下一节接力:本节产出的"风险假设列表",交给漏洞分析域加工成已确认风险。