1.2 设计哲学:向顺序写入妥协的艺术
1.2 设计哲学:向顺序写入妥协的艺术
本节摘要:LevelDB 的设计哲学可以浓缩成一句话:向磁盘的顺序 I/O 特性妥协,把"数据时刻有序"的执念放到后台去解决。本节拆解四根支柱——写优化优先、延迟合并、有序键空间、嵌入式克制,并解释它们如何共同构成一个自洽的系统。理解这套哲学,你就拿到了理解后面所有章节的钥匙:每个参数、每个组件都是在为这些信念买单。
你能学到什么
阅读完本节,你应当能够:
- 解释 LSM-Tree 为什么放弃就地更新,改用"追加写 + 后台合并"
- 说清 WAL 与延迟合并在可靠性上各自承担什么职责
- 讲明"有序键空间"为什么是范围查询高效的基石
- 用顺序 I/O 这条物理法则解释 LevelDB 的写入路径设计
一、问题与直觉
先做一个思想实验。假设你有一块机械硬盘,现在要持续写入海量随机键值对。传统 B+树的做法是"就地更新":找到数据所在的页,改掉,写回。听起来合理,但每一次随机写都要让磁头跳到对应位置——寻道时间毫秒级,几百次随机写就能让吞吐崩到惨不忍睹。
那反过来想:如果我不在乎数据在磁盘上是不是"时刻有序"呢? 我把每次写入都当成一条新记录,追加到一个文件末尾,先不整理。这样每次写入都是顺序追加,快得离谱。代价是:数据会越来越乱,同一个键可能有多份记录,读取时得四处找。
这就是 LSM-Tree 的核心取舍,也是 LevelDB 全部设计的出发点:用"允许暂时的乱"换取"写入的极致快",再用后台的整理把"乱"慢慢收拾干净。
二、核心原理
支柱一:写优化优先——瀑布式写入
LevelDB 把写入路径设计成一条单行瀑布:
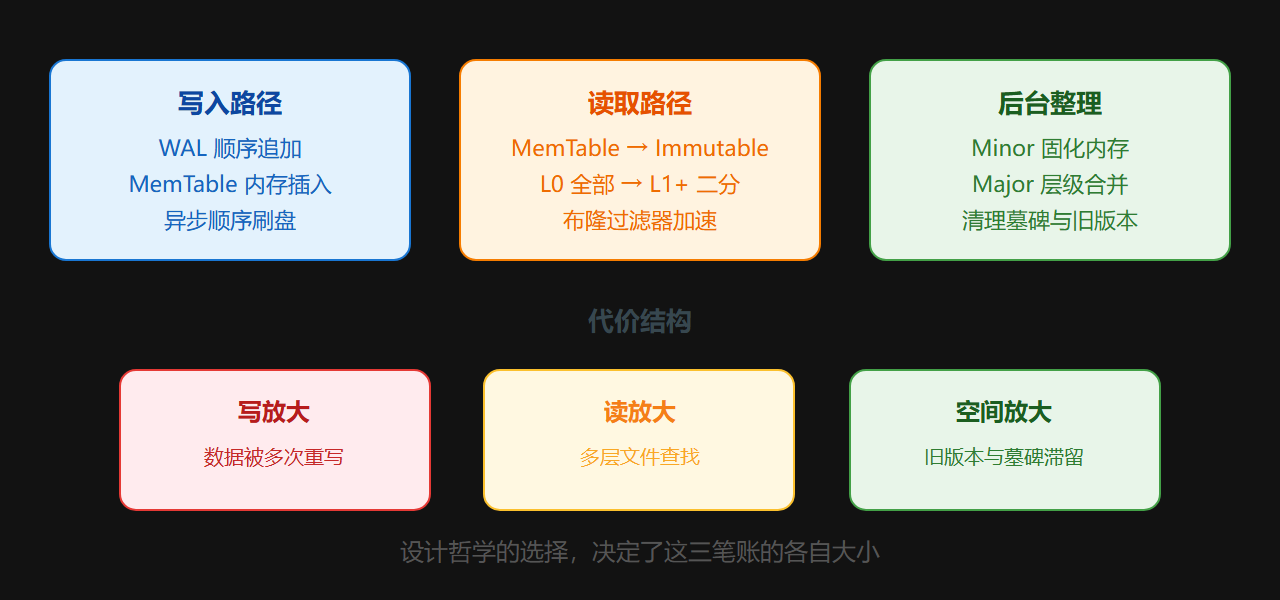
- 写入请求到达,先追加到 WAL(Write-Ahead Log),确保持久性——这是顺序写。
- 再插入内存里的 MemTable(跳表实现),也是纯内存操作,纳秒级。
- MemTable 写满,冻结成 Immutable MemTable,后台线程把它整体顺序刷成磁盘上的 SSTable(Level-0 文件)。
关键在第三步:刷盘是"整个有序结构一次性顺序写",不是零散写。用户的随机写请求,在内存里被缓冲、排序,最后变成一条顺序 I/O 流落盘。
支柱二:延迟合并——把整理甩给后台
"只追加"带来一个问题:同一个键的多个版本会散落在多个 SSTable 里,读要翻好多文件,删除的数据也占着空间。LevelDB 的解法是 Compaction(压实/合并)——一个持续在后台跑的进程,把多个小 SSTable 多路归并成更大的有序文件,顺带清掉旧版本和删除标记。
这里有一个容易被忽略的哲学点:整理的成本被刻意推迟、分摊,而不是在写入瞬间结清。 如果每次刷新内存都立即全量合并,写入吞吐会被周期性的停顿撕碎。LevelDB 选择让后台慢慢收拾,用 CPU 和 I/O 换取前端延迟的稳定。
💡 关键直觉:把 Compaction 想成整理衣柜。你可以选择每放进一件衣服就整理一次(太慢),也可以选择先堆着,等周末统一归置(LevelDB 的做法)。短期衣柜是乱的,但每周一次的整理成本是可控的、可预测的。
支柱三:有序键空间——范围查询的根基
与哈希型键值存储不同,LevelDB 保证所有数据按键的字典序排列。这个选择直接服务于一个高级抽象需求:高效的范围查询。
有序存储让 Iterator 的实现变得高效——它可以像归并多个有序链表一样,把 MemTable 和多层 SSTable 的数据流按序合并返回。这使得 LevelDB 超越了"键值缓存",成为很多需要复杂查询模式系统的底层支撑。设计者想得很远:存储引擎不应只服务单点查询,还要提供符合数据内在关联性的访问原语。
支柱四:嵌入式克制——作为库而非服务
LevelDB 被设计成一个库,而不是一个独立进程或服务。没有网络服务器、没有查询语言、没有客户端协议。好处直接:极低的访问延迟(无进程间通信)、简化的部署(不用管理独立服务)、对数据生命周期的完全控制。
这种"做少"反而是它强大的来源。因为它足够简单聚焦,其他系统才能毫无负担地把它嵌进去,在上面盖分布式层、事务层、SQL 解析层。LevelDB 扮演的是"坚实地基"的角色,鼓励"组合优于继承"的架构风格。
三、工程实践要点
顺序 I/O:不容辩驳的物理法则
| 介质 | 顺序 vs 随机 | 对 LSM 的意义 |
|---|---|---|
| 机械硬盘 | 顺序带宽可达数百 MB/s,随机仅几十到几百次 IOPS | LSM 避开寻道,直接吃到带宽红利 |
| SSD | 随机延迟低,但随机写加剧 FTL 垃圾回收 | 顺序写减少写放大,延长闪存寿命 |
这条物理法则是 LevelDB 一切设计的最终仲裁者:WAL 是顺序追加,刷盘是顺序写,Compaction 是顺序的多路归并。读取虽然可能涉及多个文件,但单个 SSTable 的扫描也是顺序的。
哲学的统一性:一以贯之的权衡
| 决策 | 信念 | 直接代价 |
|---|---|---|
| 追加写替代就地更新 | 顺序 I/O 优先 | 读放大、空间放大 |
| 后台 Compaction | 延迟整理换取稳定 | 写放大 |
| 有序键空间 | 范围查询优先 | 插入位置影响 Compaction 局部性 |
| 单写者嵌入式 | 简单优先 | 跨进程/多写者场景受限 |
⚠️ 常见坑:不要指望一个参数同时解决所有放大问题。写放大、读放大、空间放大是一个三角,调小 write_buffer_size 能降内存,但可能让 L0 文件激增、读放大上升。后面第 6 章会给出调优方法论,这里先记住:任何调优都是在三角里选位置。
SOURCE 独有事实
LevelDB 的写入性能可以抽象表达为:写入性能近似等于内存 O(log n) 操作加一次 O(1) 的顺序磁盘追加;而读取性能在最坏情况下等于 O(log n) 加各层布隆过滤器未命中代价的累加。这个表达式直接揭示了它的本质:以可能更高的读取代价,换取写入吞吐的极致与范围查询的优秀空间局部性。另外值得注意的是,LevelDB 会通过 Write Stall 机制在系统压力过大(如 L0 文件过多)时主动降低写入速度——这个细节说明它追求的从来不是"无脑快",而是"可预测的快"。
四、深入展开:把哲学放进显微镜
图:三条路径的代价对比
为什么"延迟合并"能成立
初看"把整理推迟到后台"有点反直觉——难道不是越快整理越好吗?这里的关键在于两个前提:
第一,整理是昂贵的。一次 Compaction 要读多个文件、做多路归并、写新文件,是典型的 I/O 密集任务。如果每次 MemTable 刷盘都立即触发全量合并,写入吞吐会被周期性停顿撕成锯齿。
第二,前端请求对延迟是敏感的。用户感知的是单次 Put/Get 的延迟,而不是后台完成了多少工作量。把整理成本从"关键路径"剥离到"后台路径",换来的是前端延迟的稳定与可预测——这是"延迟合并"成立的根本理由。
但"延迟"不是"无限拖延"。LevelDB 用两个机制兜底:一是 L0 文件数阈值,超过 level0_slowdown_writes_trigger 就主动降速,超过 level0_stop_writes_trigger 就完全停写,防止读放大失控;二是容量金字塔,每层数据量约 10 倍增长,给后台整理一个明确的目标。所以"延迟"是策略性的,有明确的触发与回归机制。
顺序 I/O 法则的边界在哪
顺序 I/O 优于随机 I/O 是机械硬盘时代的铁律,在 SSD 时代依然成立,但程度变了——SSD 的随机读延迟已经低到接近顺序读,随机写则因 FTL 垃圾回收仍有代价。这个变化带来的推论是:
- 对读路径,SSD 上读放大的绝对代价比 HDD 小得多,LevelDB 读路径的劣势被硬件进步部分抹平
- 对写路径,顺序写仍是 SSD 的福音,因为它让 FTL 的磨损均衡与垃圾回收更高效,减少写放大,延长寿命
所以"顺序 I/O 优先"这条法则本身没有过时,只是它的权重在不同硬件上发生了变化。理解这一点,你就知道为什么有人会在 SSD 上讨论"是不是该用 B+树替代 LSM"——这正是硬件变化驱动设计反思的典型例子。
哲学的统一性:从信念到代码的映射
把四条支柱串起来看,会发现它们不是孤立的,而是互相支撑的闭环:写优化优先决定了必须用追加写,追加写带来数据冗余,冗余需要延迟合并来收拾,合并要想高效就需要键有序,而嵌入式定位保证了这一切可以在单进程内低成本实现。反过来,嵌入式定位又限制了并发模型的复杂度,让单写者模型成为可能。
这个闭环还回答了另一个问题:为什么 LevelDB 的代码量能保持那么小?因为它把复杂度集中在几个关键机制里(WAL、Compaction、版本管理),其余部分都尽量保持"薄"。做减法不只是工程洁癖,而是为了让这四条支柱能被清晰地实现和验证。一个试图面面俱到的引擎,很难保持这种信念的一致性和代码的简洁。
常见问题
问:既然顺序写这么好,为什么不是所有数据库都用 LSM? 因为顺序写的收益集中在"写入密集 + 数据量大"的场景。读多写少的业务,B+树的就地更新让读路径更稳定,写放大也更低。LSM 用读放大和写放大换写入吞吐,这笔账只有写入占比够高时才划算。第 1.4 节会专门展开这个选型问题。
问:Write Stall 是不是说明 LevelDB 设计有缺陷? 不是,恰恰相反。如果系统没有背压机制,写入会无限快于后台整理,L0 文件无限堆积,读放大雪崩式恶化,最终整个系统彻底不可用。Write Stall 是"用暂时的慢换取长期的可预测",这是成熟系统的标志,而不是缺陷。
问:嵌入式定位现在还有优势吗?云原生不是都在搞存算分离? 有,而且是两种不同的抽象。存算分离解决的是"存储容量和计算资源弹性伸缩"的问题;嵌入式引擎解决的是"数据离计算最近"的问题。流处理引擎的状态后端(如 Flink 用 RocksDB)、边缘设备、嵌入式系统,都需要这种"库级"的存储。两者不是替代关系,而是服务于不同的部署形态。
核心回顾
- 要点一:LSM-Tree 放弃就地更新,用"内存缓冲 + 顺序刷盘 + 后台合并"把随机写变成顺序写。
- 要点二:WAL 是持久性承诺,先写日志后写内存,保证崩溃后数据不丢。
- 要点三:Compaction 把昂贵的整理推迟到后台,换取前端延迟稳定,代价是写放大。
- 要点四:有序键空间是范围查询与高效 Iterator 的根基,这是 LevelDB 与哈希型 KV 的关键区别。
- 要点五:嵌入式定位让 LevelDB 成为可被自由组合的地基组件,代价是牺牲多写者与跨进程能力。
- 要点六:写/读/空间"三放大"构成一个三角,一切调优都是在三角里选平衡点。
下一节我们把哲学放回地面,看看这些信念最终长成了哪些特性、又背上了哪些局限——高写吞吐的另一面,往往就是读放大的开始。