- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读
一句话定位:这是一份用"对比驱动"方式讲解 LevelDB 的体系化教程——从"为什么存储引擎要把随机写变成顺序写"这个根本问题出发,把 LSM-Tree 的每一个设计决策讲透,让你读完不仅能调好 LevelDB,更能看懂它之后所有 LSM 系引擎(RocksDB、TiKV、HBase)的设计逻辑。
这个教程解决什么问题
先泼一盆冷水:市面上讲 LevelDB 的资料,绝大多数只给你看两张图——一张 MemTable 到 SSTable 的流转图,一张 Compaction 的示意图,然后就开始报参数。你照着背完,遇到真问题还是懵:为什么我的写入延迟会周期性抖动?为什么数据量一大,范围查询就慢得离谱?为什么我调大了 write_buffer_size,吞吐反而降了?
这套教程的假设很简单:一个存储引擎的每个参数、每个组件、每行核心代码,都是在为某个权衡买单。你只有先看懂这笔账,才能做出对的选择。 所以全书的主线不是"LevelDB 有什么",而是"LevelDB 为什么这么做"——为什么选跳表不选红黑树、为什么写日志要先于写内存、为什么宁可多写几遍磁盘也要把读取路径捋顺、为什么单写者模型在多数场景下反而是优势。
LevelDB 的价值也正在于此:它是 LSM-Tree 最干净、最克制的一份实现。Google 的 Jeff Dean 和 Sanjay Ghemawat 把它从 Bigtable 里抽出来的时候,刻意保持了极小的代码量和极清晰的边界。相比它之后那些"长胖"的衍生品(RocksDB 有几百个配置项),LevelDB 适合做教材——你不需要在无数特例里找主线,主线就在那,一行行写得明明白白。
适合谁读
- 正在选型存储引擎的工程师:想知道 LevelDB、RocksDB、Redis 各自边界在哪,读完第 1 章和第 7 章就能建立判断框架。
- 做后端/中间件开发的程序员:想搞懂数据库底层到底在忙什么,为什么 LSM 引擎写入快、读放大又是什么代价。
- 准备啃源码的进阶读者:第 8 章给了一条从 util 到 db 的阅读路线,并解释了为什么测试用例是最佳的"逆向教学材料"。
- 面试准备者:LSM-Tree、WAL、布隆过滤器、写放大,这些高频考点在这套教程里不是孤立名词,而是同一套权衡逻辑下的产物。
不需要你懂 C++。代码在文中只以概念性片段出现,重点是思路。
学完你能做什么
- 用自己的话解释 LSM-Tree 为什么能把随机写变成顺序写,以及代价在哪
- 面对"读写混合、数据量大"的负载,能独立完成 LevelDB 的参数选型与调优
- 能设计出对 LSM 引擎友好的键值结构(顺序性设计),避免踩"随机写放大"的坑
- 读懂 LevelDB 源码目录结构,知道改哪里能改什么行为
- 能讲清楚 LevelDB 与 RocksDB、B+树引擎(如 InnoDB)的适用边界
- 看懂监控指标(写停顿、读写放大、缓存命中率),能据此定位性能瓶颈
学习路线
第 1、2 章是地基,建立"分层存储 + 后台整理"的心智模型;第 3 章把写入、读取、压缩三条路径走一遍,这是理解一切性能现象的关键;第 4 章补上跳表、布隆过滤器这些具体武器;第 5 章讲并发与一致性,这是最容易读晕、但面试最常考的部分;第 6 章落地到调优;第 7 章回到选型,用对比收尾;第 8 章给愿意深入源码的人一张地图。
图:LevelDB 的"三层架构"分层透视
下图把 LevelDB 的运行结构画成分层透视:上层是引擎对外暴露的能力,中层是三大组件域,下层是物理存储与硬件。读这套教程时,可以反复回到这张图确认"当前讲的机制落在哪个层面"。
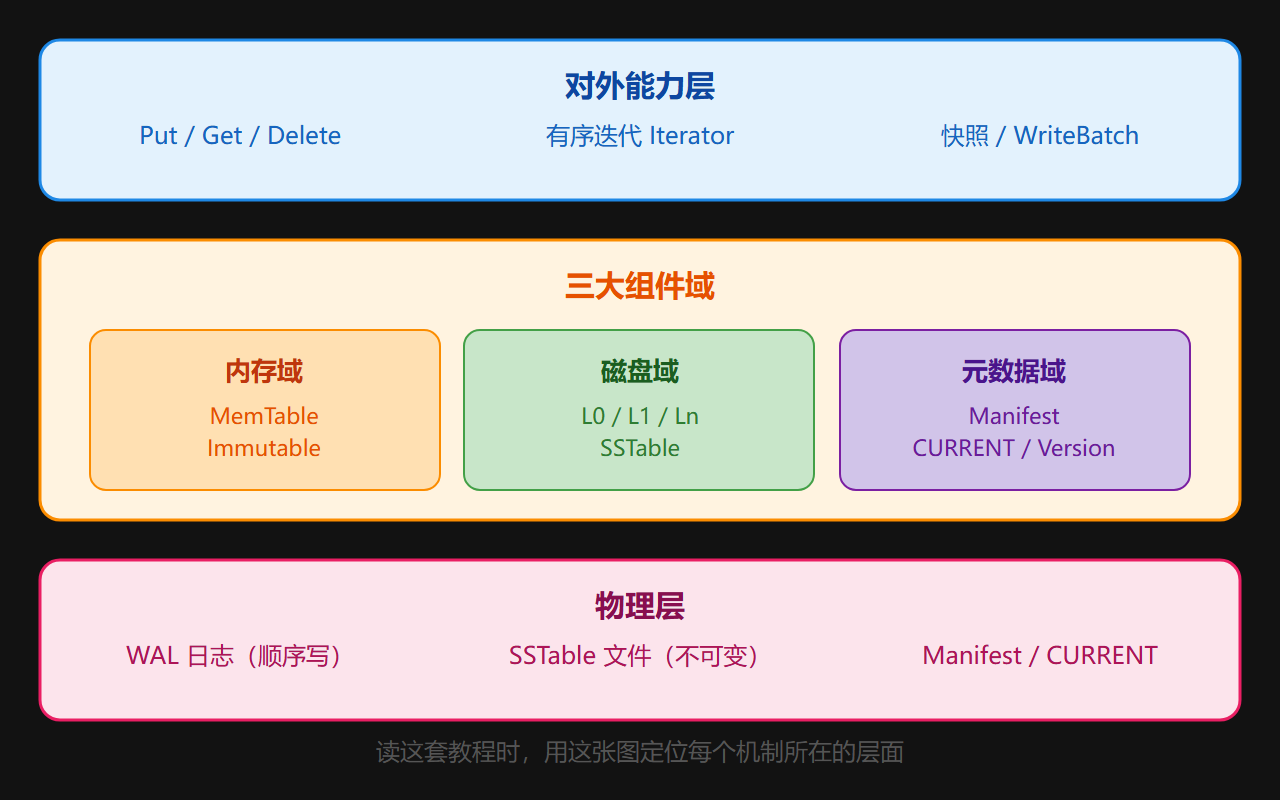
提示:图中三层自上而下是"能力 → 组件 → 物理",本教程第 2 章正好按这个顺序展开。
常见误区(先排雷)
学习过程中你会反复撞上三个坑,提前说清:
误区一:把 LevelDB 当 Redis 用。 两者形态完全不同——Redis 是网络服务,LevelDB 是库;LevelDB 没有跨进程协议,同一数据库文件同一时刻只允许一个进程写。想清楚你的场景要的是"中间件"还是"组件",再动手。
误区二:以为"写入快"就是"什么都快"。 LevelDB 的写路径经过 WAL、内存缓冲、后台合并三道工序才换来高吞吐,代价是读放大与写放大。教程第 3 章会专门用一节讲"三放大",因为它是理解一切性能现象的语言。
误区三:把"默认参数"当"最佳参数"。 默认配置只是"能跑",不是"跑得好"。日志型负载和点查型负载需要完全不同的参数组合,第 6 章会带你走一遍实战调优。
三个高频问题的速答
| 问题 | 一句话答案 | 详细见 |
|---|---|---|
| LevelDB 和 Redis 的区别 | 前者是嵌入式库,后者是网络服务 | 第 1.1 节 |
| 为什么 LevelDB 写入快 | 把随机写变成顺序写,整理交给后台 | 第 1.2 节 |
| 选 LevelDB 还是 RocksDB | 看业务复杂度与团队能力,没有绝对答案 | 第 7.1 节 |
⚠️ 提醒:这套教程的核心主张是"理解比记忆更重要"。请勿跳过"为什么"直接背结论——那样遇到新问题仍然不会。
💡 学习技巧:每章末尾的"要点回顾"先看一遍,作为本章的预习清单,读完全章再回来自测。
怎么用这个教程
建议顺序阅读,但有两个例外:如果你只关心"怎么用",第 4、5 章可以快速跳过;如果你只想快速建立选型框架,第 1 章 + 第 7 章就够了。每章末尾的"要点回顾"建议先看,作为本章的自测清单。文中穿插了大量对比表格和示意图,遇到"为什么会这样"的追问,先别急着往下翻,自己想想答案再对照。
动手环境:Linux 或 macOS 上安装 LevelDB 最省事;Windows 上建议用 WSL。只需要一个能编译 C++ 的环境即可,绝大多数结论(写放大、顺序写、快照语义)都是引擎层面的行为,与语言无关。
一句话总结:这套教程不是教你"背 LevelDB 的参数表",而是带你建立"存储引擎的成本模型"——明白了每笔开销花在哪,你就再也不会被任何 LSM 系引擎的营销话术带偏。
再补一句定位:如果你只想带走一个概念,那就是"顺序写"三个字。LevelDB 的一切——WAL、MemTable、SSTable、Compaction、写放大——都是围绕"让磁盘顺序写"这一物理事实展开的。抓住这条线,全书的知识点会自动串成一张网,而不是一堆孤立名词。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...