2.3 磁盘组件:SSTable 文件解剖
2.3 磁盘组件:SSTable 文件解剖
本节摘要:SSTable 是 LevelDB 在磁盘上的唯一数据文件格式,也是一套融合了数据结构、存储格式与访问策略的完整框架。本节解剖它的内部构造:数据块、索引块、布隆过滤器块、Footer 各自扮演什么角色,为什么分块、为什么不可变。看完你就能回答"一个键在 SSTable 里是怎么被找到的"以及"为什么不能原地改一个键"。
本节导读
阅读完本节,你应当能够:
- 画出 SSTable 文件的逻辑结构(数据块 -> 元数据 -> 索引 -> Footer)
- 解释分块存储对 I/O 粒度、缓存友好性、Compaction 的三重好处
- 说清索引块如何让点查最多只触发一次磁盘 I/O
- 说明布隆过滤器在 SSTable 中如何拦截"键不存在"的查询
一、问题与直觉
先想一个矛盾:SSTable 内部按键排序,但文件可能有几百 MB。如果查找时把整个文件读进内存做二分,内存会爆;如果每次都从磁盘读,又太慢。
LevelDB 的解法是"分块 + 索引":把文件切成固定大小的数据块(典型 4KB),文件尾部存一张索引表,记录每个块的起始键和偏移。查找时,先在内存里的索引块做二分,定位到目标数据块,只读那一块。一次查询,最多一次磁盘 I/O。
这就像一本厚字典:你不会每次查词都从第一页翻起,而是先看目录(索引块),找到对应页(数据块),只翻那一页。
二、核心原理
结构解剖:五层布局
一个完整的 SSTable 文件从前往后是:
数据块(Data Block):存键值对,块内有序,用前缀压缩减空间。它是 I/O 的基本单元,也是 Block Cache 的缓存粒度。
索引块(Index Block):每个条目记录一个数据块的"分隔键"(通常是该块最后一个键)以及该块在文件中的偏移量和大写。缓存在内存中,查询键时对它做二分,定位数据块。
元数据块(Filter Block):存布隆过滤器。查询时先问它"这个键可能在这个文件里吗"——答案是"绝对不存在"就跳过整个文件,是应对"键不存在"查询的利器。
Footer:固定长度的文件尾部,存着索引块和元数据块的指针。它是读取 SSTable 的入口,相当于书的目录页。
分块的三重收益
- I/O 粒度控制:只读目标块,不读整个文件。
- 缓存友好:块是 Block Cache 的天然缓存单元,热点块驻留内存。
- Compaction 灵活:合并时可逐块处理,支持并行。
不可变性:设计的灵魂
SSTable 一旦创建就不可修改。更新或删除不会改原文件,而是以新条目出现在后续 SSTable 里。这个"不可变"带来三个好处:
- 并发控制简化:无需对磁盘文件加写锁
- 写入优化:纯粹的顺序写入
- Compaction 高效:合并时只需读旧文件、写新文件
布隆过滤器的位置
布隆过滤器通常作为 Filter Block 存在 SSTable 里。查询顺序是:先查内存里的过滤器,返回"绝对不存在"则跳过;返回"可能存在"才读索引、定位数据块。它的误判率 p 与位数组大小 m、元素数量 n、哈希函数数 k 的关系近似为 p ≈ (1 - e^(-kn/m))^k。误判只浪费一次 I/O,绝不丢数据。
三、工程实践要点
L0 与更深层级的差异
| 层级 | 文件间键范围 | 点查代价 | 来源 |
|---|---|---|---|
| Level-0 | 可能重叠 | 需查多个文件 | MemTable 直接刷盘 |
| Level-1+ | 不重叠、有序 | 二分定位一个文件 | Compaction 生成 |
这个差异是读路径性能的关键。L0 文件越多,读放大越严重——这就是为什么 LevelDB 要设 L0 文件数阈值来触发 Compaction。
布隆过滤器参数的权衡
| 每键比特数 | 误判率量级 | 内存开销 | 适用 |
|---|---|---|---|
| 10 | 约 1% | 低 | 默认均衡 |
| 20 | 远低于 1% | 中 | 点查密集 |
| 0(关闭) | 无过滤 | 零 | 顺序扫描为主 |
⚠️ 常见坑:布隆过滤器只对点查有意义,对范围扫描(Iterator)无效。如果你的业务全是范围扫描,给布隆过滤器加内存就是浪费。
💡 关键直觉:把 SSTable 想成"不可变的字典分册"。字典一旦印刷就不能改,要修订就出新的分册。查询时要靠目录(索引)和检查站(布隆过滤器)快速定位,这就是 LevelDB 磁盘文件的设计逻辑。
SOURCE 独有事实
SSTable 的文件尾 Footer 是读取的起点——系统先读文件末尾固定长度的 Footer,再按其中的指针加载索引和过滤器。此外,数据块采用前缀压缩(相邻键只存差异部分)减少空间,这是 LevelDB 针对"有序键"做的定制优化,与通用压缩算法是两套机制(后者在第 4.4 节详述)。
四、深入展开:把 SSTable 读透
图:SSTable 文件结构布局
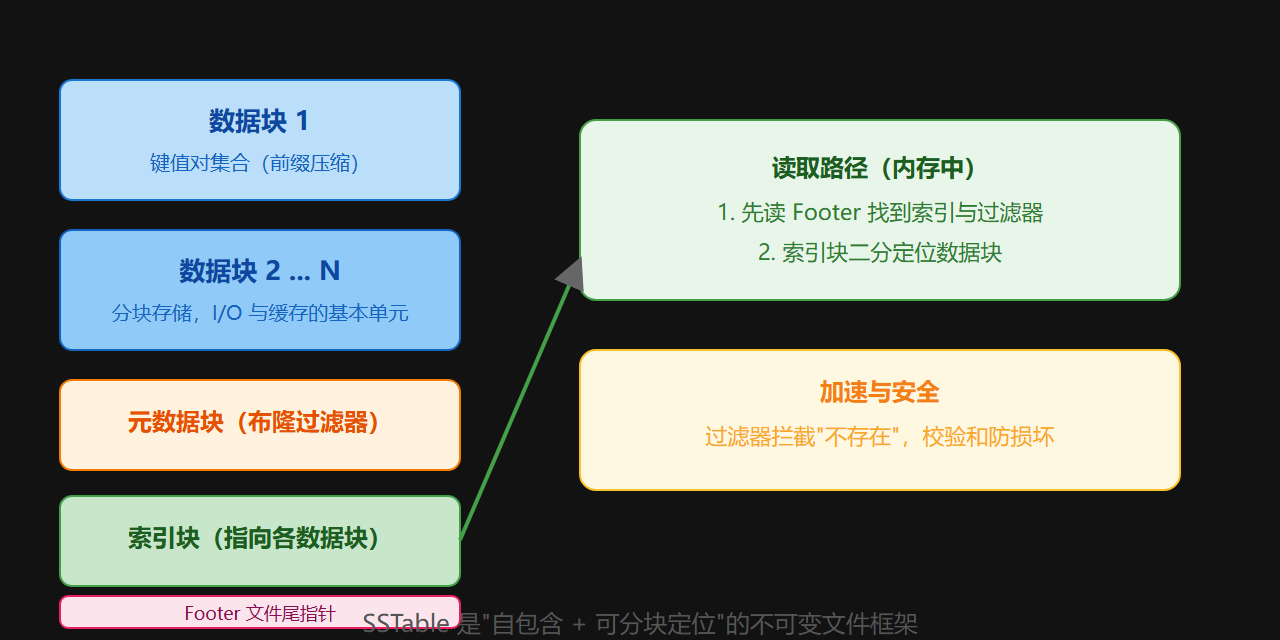
为什么文件尾放 Footer 而不是文件头
一个有趣的工程细节:SSTable 的 Footer 放在文件末尾,而不是开头。为什么?因为 SSTable 是按追加方式生成的——写入数据块、过滤器块、索引块,最后才写 Footer。文件头在生成时已经"定型"了,而 Footer 是最后落笔的"签名"。
这个设计对读取的影响是:打开文件要先读尾部固定长度的 Footer,再根据其中的指针跳转到索引块和过滤器块。对顺序追加的写入友好,对随机读取也只需要多一次尾部读——一个位置的选择,同时服务了两种访问模式。这类"小细节定大局"的工程决策,正是读源码时值得留意的。
数据块的内部结构:前缀压缩与重启点
数据块内部并不只是简单的键值对排列。LevelDB 采用前缀压缩:相邻键共享的前缀只存一次,后续条目只存"与前键共享的长度 + 独有后缀"。更妙的是"重启点"(Restart Point)机制——每隔一段键就存一个完整键作为"重启点",重启点之间用前缀压缩。这样做的目的是支持二分查找:二分需要能随机定位到某个键的完整形式,重启点提供了这种定位能力。
这意味着数据块的查找不是简单的线性扫描,而是"先在重启点数组上二分定位区块,再在区块内顺序比对"。空间与时间的平衡、压缩与寻址的折中,全部浓缩在这一个块结构里。第 4.4 节会从压缩角度再次展开。
不可变性带来的连锁反应
SSTable 不可变是贯穿 LevelDB 的设计基石,它带来的连锁反应值得逐条理清:
- 并发控制简化:磁盘文件无需写锁,读者拿着旧版本引用随便读
- 崩溃恢复变简单:文件要么完整存在、要么不存在,没有"写到一半"的中间态要处理
- Compaction 可以安全进行:合并时旧文件还被读者引用,等引用归零才删除
- 压缩更高效:数据不变,块压缩结果可缓存复用
但这个设计也有代价:更新和删除永远产生"新文件 + 旧文件并存",空间放大由此而来。不可变性是"用空间换简单和可靠"的又一例证——你需要在理解它的同时,也理解它欠下的账。
一个动手实验:用文件大小反推内容
如果你想直观感受 SSTable 结构,可以做一个实验:写一批键值后查看生成的 .ldb 文件,对比"原始数据大小"与"文件实际大小"。你会发现实际大小比原始数据小——这就是块压缩和前缀压缩的效果。再换一批键前缀高度重复的数据写入,文件会更小,因为前缀压缩吃到了红利。
反过来,如果你写入大量随机键,压缩率会明显下降——前缀压缩依赖有序键的高重复前缀,随机键没有这个优势。这个实验能让你直观理解:为什么键设计(第 6.2 节)会影响磁盘占用,而不只是查询速度。
一个值得留意的实现细节:块校验
每个数据块在写入时还会附带一个校验和(Checksum)。读取时先校验再使用,一旦发现校验不通过,说明块数据损坏(磁盘坏道、写坏等),系统可以拒绝使用或触发恢复流程。这个细节在"高可靠性"场景尤其重要——静默的数据损坏比明确的报错危险得多,因为应用可能在不知情的情况下读到错误数据。
校验和的开销几乎可以忽略(现代 CPU 有硬件加速),却为整个磁盘层加了一道可靠性的保险。它与 WAL 记录里的校验和(第 5.1 节)思路一脉相承:用很小的成本,换取"数据损坏可被察觉"的能力。读源码时你会看到校验逻辑遍布数据块、索引块、过滤器块——这不是重复劳动,而是"每一条数据路径都要能自我验证"的设计原则。
常见问题
问:为什么读取时还要读 Footer?直接记住索引块位置不行吗? 打开文件是冷启动,Footer 是"重新认识这个文件"的入口。索引块位置不固定(取决于数据量),所以必须通过 Footer 找到它。只有缓存命中时(Table Cache 持有索引块),才能跳过 Footer 直接二分。
问:一个 SSTable 的键范围是怎么确定的? 由 Compaction 和刷盘的输入决定——MemTable 刷盘生成的文件覆盖该 MemTable 的全部键;Compaction 生成的文件覆盖输入文件的键范围合并。这个"键范围"信息被记录在元数据里(第 2.4 节),是读取定位和 Compaction 规划的依据。
问:SSTable 文件会无限增长吗? 单个文件大小受配置限制,超过后 Compaction 会把它合并进更大文件并删除原文件。所以文件的数量和大小都在动态平衡中,这正是"后台整理"职责的一部分。
从 SSTable 看 LSM 的核心矛盾
SSTable 是把 LSM 写入优化的"优势"与"代价"同时固化的产物:它让写入变成顺序追加(优势),也让读取必须面对多层文件(代价);它让文件不可变(简化并发),也让空间放大不可避免(代价);它让压缩高效(优势),也让删除延迟生效(代价)。
读懂 SSTable,就等于读懂了 LSM 的一半。剩下的一半在 Compaction(第 3.3 节)——因为单看一个文件是静态的,只有加上 Compaction 让它流转起来,才构成完整的 LSM。这也是为什么学习顺序很关键:先看懂文件,再看懂文件的生灭循环。
最后提醒一个值得重复的点:SSTable 的一切设计(分块、索引、不可变、校验)都在服务同一个目标——让"读一个有序大文件"这件事既快又安全。快靠分块与索引,安全靠不可变与校验。抓住这个目标,再看任何文件格式的细节,你都能自己推导出"为什么这样设计"。
要点速记
- 要点一:SSTable 结构 = 数据块 + 索引块 + 过滤器块 + Footer,内部按键有序。
- 要点二:索引块缓存于内存,点查最多触发一次磁盘 I/O。
- 要点三:不可变性带来并发简化、顺序写入、Compaction 高效三大好处。
- 要点四:布隆过滤器拦截"键不存在"查询,用误判率换 I/O 节省。
- 要点五:L0 文件键范围重叠、L1+ 不重叠,这是读放大差异的来源。
- 要点六:Footer 是文件读取入口,前缀压缩针对有序键定制。
数据文件躺在磁盘上了,但系统怎么记得"哪块石头在哪层、管哪些键"?下一节看元数据与版本控制。