5.2 快照:以序列号定格时间
5.2 快照:以序列号定格时间
本节摘要:快照不是物理拷贝,而是一个逻辑概念——数据库在某个序列号时刻的一致视图。创建快照只是"瞥一眼当前的序列号",O(1) 成本。本节讲清快照的读取过滤逻辑、与 Compaction 的博弈(活跃快照阻止旧版本被删除)、以及四个经典应用场景与最佳实践。
学习目标
阅读完本节,你应当能够:
- 解释快照为什么是"逻辑时间切片"而非物理拷贝
- 描述 internalKey 中序列号如何实现按序检索
- 说清快照如何影响 Compaction 的版本保留决策
- 列出快照的典型应用场景与生命周期管理要点
一、问题与直觉
高并发系统里有个永恒的挑战:数据一直在"变"(写入、更新、删除),而某些读取——尤其是耗时很长的分析查询——需要一个"不变"的视图。
如果视图不固定,你边查边有人改,得到的结果就是一团乱麻。如果视图靠物理拷贝实现,又慢又贵。
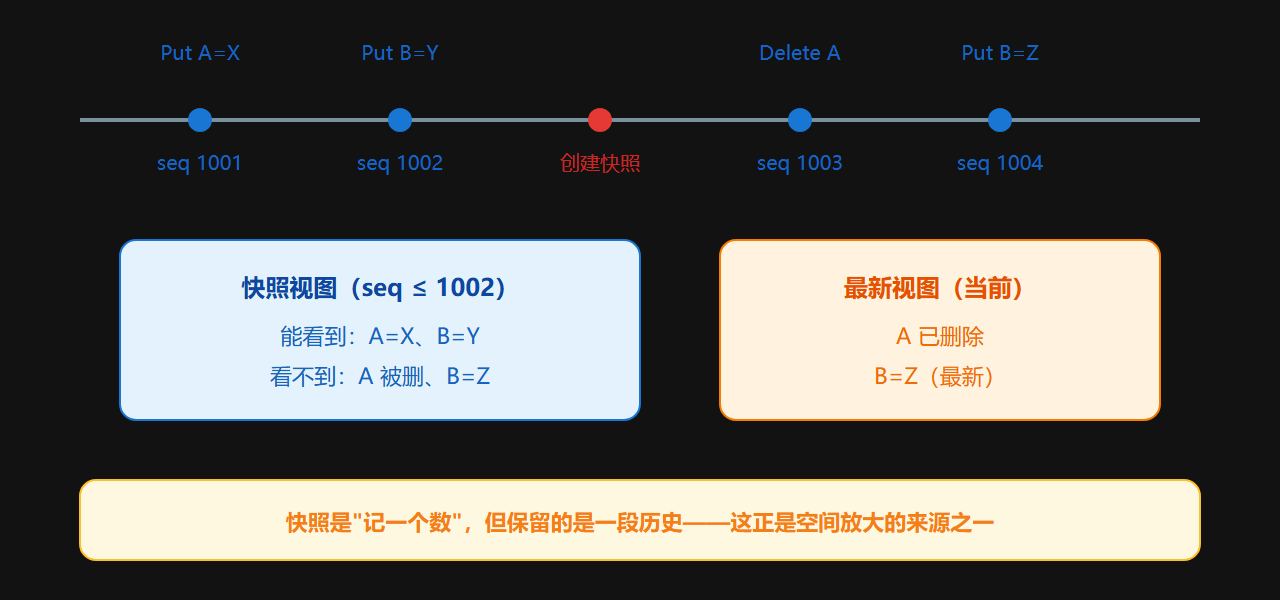
LevelDB 的答案很妙:把"不变"交给一个数字——序列号。快照创建时记下当前的序列号,之后所有基于该快照的读取,只认序列号小于等于它的记录。这像一个"时间切片",把数据库在那一刻的样子完整保留给读者,成本却只是记一个数。
二、核心原理
序列号:逻辑时钟与时间戳
LevelDB 为每个写入操作(Put/Delete)分配全局唯一、单调递增的序列号。每次写入都推动时钟前进。创建快照时,系统记下当前序列号 snapshot_seq——这就是快照的全部内涵:一个数字。
关键在数据存储方式:任何数据(新写入或删除标记)都不是孤立键值对,而是带"键、值、类型、序列号"的内部结构。磁盘上每条记录都自带时间戳。
读取时,查找逻辑加一个核心约束:只关心序列号小于等于 snapshot_seq 的最新记录。序列号更大的写入,对这次读取而言如同从未发生。
internalKey:序列号怎么排
MemTable 和 SSTable 中每条记录的 internalKey 格式:用户键 | 序列号 | 类型。序列号占高位,所以对相同用户键,更高序列号(更新写入)排得更靠前。这种排序是快照高效检索的基础——查找时用 Seek 定位到第一个小于等于目标键且序列号满足条件的记录。
快照的生命周期
- 创建:
GetSnapshot()获取当前序列号,包进 SnapshotImpl 对象,插入全局存活快照链表,返回指针。O(1),开销可忽略。 - 读取:
Get(ReadOptions, ...)中指定 snapshot,查找时以 snapshot_seq 为序列号上界。 - 释放:
ReleaseSnapshot()从链表移除并销毁。
快照与 Compaction 的博弈
Compaction 的职责之一是空间回收——旧版本在"最新快照不再需要"时成为垃圾。但判断"是否不再需要"要小心:可能还有活跃快照依赖它。
规则:Compaction 收集所有存活快照中的最小序列号 oldest_snapshot_seq。处理某键的旧记录 seq_k 时:
- 若
seq_k <= oldest_snapshot_seq,可能仍被某快照依赖,必须保留 - 只有超过最老快照的旧版本才可安全删除
结果:活跃快照会阻止其依赖的旧版本被物理删除,暂时增加磁盘占用。快照存活时间定义了历史数据保留的"时间窗口"。
三、工程实践要点
四个应用场景
| 场景 | 用法 | 说明 |
|---|---|---|
| 一致性读取 | 复杂耗时查询挂快照 | 实现可重复读/快照隔离 |
| 增量备份 | 记录快照序列号 | 只读之后变更的数据 |
| 时间点查询 | 外部保存关键序列号 | 配合数据保留策略 |
| 全量导出 | 快照 + 迭代器 | 遍历快照时刻的完整状态 |
最佳实践与陷阱
- 及时释放:用 RAII 或类似机制管理快照生命周期,用完备 ReleaseSnapshot
- 避免长生命周期快照:长期不释放会阻止空间回收
- 空间异常排查:磁盘增长超预期时,先查是否有陈旧快照未释放
⚠️ 常见坑:开了快照忘了释放。一个长期存活的快照等于给 Compaction 画了一条"不可回收线",让旧版本数据持续占着磁盘。排查空间问题时,第一件事就是检查活跃快照列表。
💡 关键直觉:把快照想成"拍照"。拍照(创建快照)瞬间按下快门(记下序列号),照片里是那一刻的所有人。之后有人进场(新写入)、有人离开(删除),照片里永远是拍下时的样子。洗照片不花钱(O(1)),但为了让照片里的人都能被认出来(快照依赖的旧版本),现场不能急着搬走他们站过的位置(Compaction 要留旧版本)。
SOURCE 独有事实
快照的存在直接改变了 Compaction 的"最老快照序列号"计算:只要快照 B(seq=150)存活,版本 1(seq=100)就必须保留;等快照 B 被释放,最老快照序列号变为 250,版本 1 在下次 Compaction 时才可能被安全回收。这个规则意味着快照的存活时间精确定义了历史数据的保留窗口——这是理解"为什么 LSM 引擎删除后空间回收有延迟"的深层原因之一。
四、深入展开:快照机制的工程实践
图:序列号时间线下的快照视图
快照 vs 迭代器:两种一致视图的取舍
LevelDB 里有两种"获取一致视图"的方式:快照(Snapshot)和迭代器(Iterator)。迭代器在创建时也会锁定一个视图(持有版本引用),保证遍历期间文件不被删除。两者的区别在于:
- 快照是显式、可重用的:你可以在多个 Get 调用间共享同一个快照,保证它们看到同一时刻
- 迭代器是隐式、单次的:它只保证这一次遍历的一致性,用完即弃
工程上怎么选?做"跨多次读取的一致性"用快照;做"单次范围扫描的一致性"用迭代器。把两者的能力边界搞清楚,能避免很多"为什么我读到不一致数据"的困惑——那往往不是 LevelDB 的问题,而是用错了工具。
快照的隐藏成本:历史保留
快照创建是 O(1),但它的隐藏成本在"存续期间"慢慢显现:它阻止旧版本被 Compaction 清理,等于"冻结了一段历史"。快照活得越久,冻结的历史越多,磁盘占用越高。这不是 bug,是实现"回到过去"必须付的账。
工程上的含义很实际:快照的数量和存活时间,必须像资源一样被管理。一个常见的错误是在长任务里创建快照后忘了释放,导致磁盘悄然膨胀。排查"磁盘为什么一直在涨"时,第一件事就是检查活跃快照列表。把"快照会阻止回收"这条规则刻在脑子里,能省下大量排查时间。
快照与删除的相互作用
快照与"删除后空间不回收"的常见抱怨直接相关。删除操作写入墓碑,墓碑要等 Compaction 才能物理清除;但如果此刻有活跃快照,且墓碑序列号在快照可及范围内,Compaction 还要谨慎——因为快照可能还需要看到"删除前"的数据。
这个交互说明:删除后的空间回收,不仅取决于 Compaction 的节奏,还取决于有没有快照在保护历史。想立刻回收空间,除了主动触发 Compaction,还要确认没有陈旧的快照在拦路。理解这条链路,你就掌握了"LSM 删除延迟回收"问题的完整答案:它由墓碑机制、Compaction 节奏、快照生命周期三方共同决定。
常见问题
问:快照能防止数据被修改吗? 不能。快照只保证"通过它读取时看到固定视图",不阻止其他写入者修改数据。它保护的是读者的视角,不是数据本身。
问:快照创建后写入的数据,快照能读到吗? 不能。快照锚定的序列号是创建时刻的,之后写入的序列号更大,对快照不可见。这正是"时间切片"的含义。
问:长时间运行的离线分析用快照合适吗? 合适但要注意成本。离线分析正是快照的典型用途——保证分析期间数据一致。但要预估分析时长:分析越久,冻结的历史越多,磁盘占用越高。方案是定期分批分析并释放旧快照。
快照机制带来的设计启示
快照是 LevelDB 里最"举重若轻"的设计之一:一个单调递增的数字,解决了"并发读一致性"这个在传统数据库里需要锁管理器、事务隔离级别等一大堆机制才能解决的问题。它的启示很深刻——面对复杂问题,先看看能不能用"时间"这个维度简化它。
把"并发"拆成"不同时刻的串行快照",把"一致性"拆成"每个快照内部的自洽",复杂度就从"并发协调"降到了"版本选择"。这就是 MVCC(多版本并发控制)思想的精髓,LevelDB 用最朴素的方式实现了它。当你以后设计任何需要并发一致性的系统,这个"用时间仲裁代替空间争用"的思路都会是宝贵的第一性原理。
快照在增量备份中的实际应用
快照在增量备份场景有直接应用:系统可以定期创建快照并记录其序列号,备份工具基于上一个同步点的快照序列号,只读取之后变更的数据(通过迭代器指定起始序列号),避免全量扫描。这个"序列号即进度标尺"的思路,让增量同步既高效又一致。
这个应用的巧妙之处在于:快照不只是"一致性视图",它还天然提供了"数据版本的分界点"。把业务逻辑建立在序列号上,很多"需要记录数据版本"的场景都能优雅解决——这是 LevelDB 数据结构设计(每条记录带序列号)直接释放的工程红利。理解了这一点,你会发现序列号不仅是内部机制,还是可以被上层业务利用的"版本语义"。
快照与普通读取的一致性差异
很多人混淆"快照读取"与"普通读取",其实它们的差异只有一处:锚定的序列号。普通读取锚定"当前最新序列号",快照读取锚定"创建时的序列号"。这个差异看似微小,带来的行为差别却很大——普通读取永远看到"此刻的最新",快照读取永远看到"某个过去的时刻"。
工程上这个差异决定了何时用哪个:需要"读多次保持一致"(比如先读再算再写的一致性流程)用快照;只需要"读一次拿到最新"(比如常规查询)用普通读取。一个常见误区是"为了稳妥,所有读取都挂快照"——这会让 Compaction 无法回收历史数据,白白增加空间占用。正确姿势是只在"确实需要跨操作一致性"时创建快照,用完及时释放。理解了普通读与快照读的等价性与差异,你就不会误用或滥用快照了。
要点串联
- 要点一:快照是逻辑时间切片,创建 O(1),成本可忽略。
- 要点二:每条记录带序列号,快照读取只看序列号小于等于快照号的最新记录。
- 要点三:internalKey 中序列号占高位,保证同键新版本排前面,检索高效。
- 要点四:Compaction 以最老快照序列号为界,决定哪些旧版本必须保留。
- 要点五:活跃快照阻止旧版本回收,是空间放大的一个来源。
- 要点六:快照管理要点是及时释放、避免长生命周期、空间异常先查快照。
快照是读者的保障。下一节看整体——单写多读与后台线程如何在一个系统里协作。