6.2 键值设计:顺序性是大写性能的圣杯
6.2 键值设计:顺序性是大写性能的圣杯
本节摘要:如果说参数调优是引擎的精细校准,键值设计就是赛车的底盘——拙劣的设计让一切优化事倍功半。本节讲两个支柱:键的顺序性(如何决定 Compaction 局部性与写放大)、值的尺寸(大 Value 的三种处理策略),再补充键长编码、前缀设计、时间序列等进阶考量,最后给出系统化设计流程。
先说结论
阅读完本节,你应当能够:
- 解释键顺序性为什么是写性能的"圣杯"
- 对比顺序写入与随机写入对 SSTable 布局的影响
- 说出大 Value 的三种处理策略及适用场景
- 按五步流程为一个业务场景设计键值结构
一、问题与直觉
先看一个真实对比。假设存用户操作日志,键是 timestamp_userid:
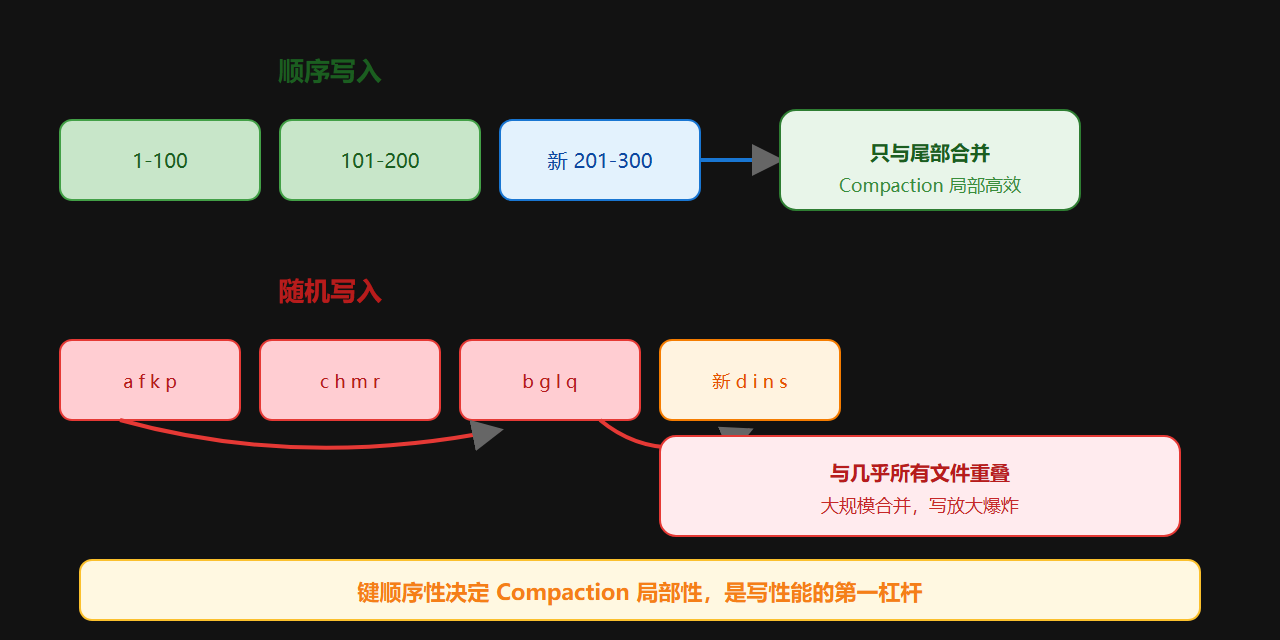
- 顺序写入:时间戳递增,新键总是接近当前最大键。MemTable 攒的键范围紧凑连续,刷盘高效,Compaction 只与尾部相邻文件合并,局部性好。
- 随机写入:键是哈希后的用户 ID,散布全键空间。MemTable 刷出的 SSTable 与大量既有文件键范围重叠,Compaction 被迫频繁做大范围合并,写放大爆炸。
同样的引擎,同样的数据量,只因键的设计不同,性能可以差一个数量级。这就是为什么说键值设计是性能的底盘——参数调优是在一辆好底盘上调校,坏底盘上怎么调都白搭。
二、核心原理
键的顺序性:与 Compaction 共舞
LSM-Tree 把随机写变成顺序写的"欺骗"是否有效,高度依赖新写入的键在全局有序序列中的位置:
- 键有序递增 → 新 SSTable 只与尾部少量文件重叠 → Compaction 局部、高效
- 键完全随机 → 每个新 SSTable 与大量既有文件重叠 → Compaction 大规模、频繁 → 读放大加剧、写放大爆炸
黄金法则:尽可能让写入顺序与键的字典序正相关。实践中通常把时间或序列属性放在键的前缀。
大 Value:三种策略
一个几 MB 的大 Value 会带来:写放大恶化(移动 1MB 与 1KB 差 1024 倍 I/O)、缓存污染(大值占满 Block 但只访问一小部分)、点查延迟波动。
策略一:指针化。把大值存到对象存储/文件系统,LevelDB 只存访问地址。优点:彻底消除大值对 Compaction 与缓存的影响;缺点:读变两次、需处理一致性。
策略二:内部碎片化。把有内部结构的大值(如 JSON)拆成多个关联键值对。优点:支持部分更新、缓存粒度细;缺点:应用层维护关联。
策略三:压缩与编码。存入前用 Snappy/LZ4 压缩或二进制编码(Protobuf/MessagePack)。优点:透明、减少磁盘与网络传输;缺点:CPU 编解码开销。
一个实用混合方案:小于 10KB 内联存储,更大的指针化存储。
三、工程实践要点
键值设计关键考量
| 维度 | 原则 | 示例 |
|---|---|---|
| 键顺序性 | 时间/序列属性放前缀 | {租户ID}{时间戳}{实体ID} |
| 键长度 | 尽可能短,整数用二进制 | uint64 8 字节优于十进制字符串 |
| 前缀设计 | 用字典序模拟索引 | tenant_id:table:pk 支持范围扫描 |
| 大值 | 分离存储思想 | 10KB 以下内联,以上指针化 |
时间序列的特殊处理
时间序列是 LevelDB 的"天作之合"——键设计成 metric:timestamp,写入天然顺序。但要警惕冷热数据:历史旧数据不再写入但仍参与 Compaction。考虑按时间范围分实例/列族,旧数据实例配置更激进压缩或更低压缩优先级。
⚠️ 常见坑:直接拿 UUID 或哈希值当主键。除非你接受随之而来的 Compaction 开销,否则应变通——例如用 {时间前缀}_{UUID} 保证基本顺序性。键的随机程度,与你为 Compaction 付的代价成正比。
💡 关键直觉:把键顺序性想成"超市进货"。如果货物(写入)按货架编号顺序补货(顺序键),理货员(Compaction)只需整理新到的几排;如果货品天南地北(随机键),理货员每次都要跑遍整个卖场。你给键设计排序规则,就是在决定理货员的工作量。
SOURCE 独有事实
键长度有一个量化例子:数字 123456789 的字符串形式占 9 字节,而二进制形式(uint64 小端序)仅 8 字节且比较速度更快。对大规模数据,这个"1 字节 + 更快比较"的差距会放大。另外,多租户 SaaS 场景用 tenant_id:table_name:primary_key 格式后,查询某个租户的所有订单只需构造一个从 5:order: 到 5:order: 加哨兵字节的范围迭代器,LevelDB 可高效遍历连续区间,避免全表扫描。
四、深入展开:键值设计的思维框架
图:顺序键与随机键的 Compaction 对比
键就是"数据在引擎里的命运"
很多人把键只当成"查找的依据",但在 LevelDB 里,键决定了数据的一切命运:排序位置(决定 Compaction 局部性)、范围查询能力(决定扫描效率)、压缩率(前缀压缩吃共享前缀)、甚至布隆过滤器的效用。设计键,等于给每一份数据"安排人生"。
这个视角要求你在设计键时想清楚几个问题:这个键会被怎么写入(顺序还是随机)、会被怎么查询(点查还是范围)、会和哪些键"做邻居"(前缀分组)。一个键设计得好的系统,后续的调优工作量会大幅减少;设计得差,再调参数也是事倍功半。把键值设计当成"性能的第一道工序",是 LSM 系引擎开发的常识。
顺序性设计的取舍:不要无脑加时间前缀
把时间放键前缀是经典套路,但不是万能解,它有取舍:加了时间前缀,同一时刻的写入会聚在一起(顺序性好),但"跨时间随机查询"就变难了——你必须知道时间范围才能高效扫描。如果你的业务需要"按任意用户 ID 随机查",时间前缀反而是阻碍。
正确的思路是"按主导访问模式设计键前缀":哪种查询最频繁、最敏感,就让它的维度成为前缀。日志系统主导是"按时间扫",所以时间在前;用户系统主导是"按用户点查",所以用户 ID 在前。没有"永远正确"的键格式,只有"匹配你主导访问模式"的键格式。这个"主导维度前置"的原则,比"无脑加时间"高明得多。
大 Value 决策的"10KB 经验法则"
大 Value 的处理有个实用的经验分界:小于 10KB 的值内联存储(直接放键值对),大于 10KB 的值考虑分离存储(指针化)。这个分界的逻辑是:小于 10KB 的值即使参与 Compaction 重写,代价也有限;而超过 10KB 后,写放大和缓存污染的代价开始显著。
当然这只是一个起点,具体分界要看你的硬件和负载:SSD 便宜、写放大不敏感,分界可以放宽;内存紧张、缓存珍贵,分界要收紧。但"10KB 经验法则"给了你一个可量化的决策起点——不用每次都从零推导。理解了"为什么大值要分离"(写放大 + 缓存污染),你就能自己调整这个分界,而不是机械照搬。
常见问题
问:键可以很长吗? 可以,但不推荐。长键增加存储开销(前缀压缩救不了随机长键)、比较成本(每次查找都要比字节)、布隆过滤器负担(哈希更长的键)。能用短键表达语义,就不要用长键。
问:值可以很大吗? 引擎本身不限制,但大值会带来写放大、缓存污染、点查延迟波动三重代价。方案是分离存储(第 6.2.3 节的指针化/碎片化)。
问:键排序是字节序还是字典序? 默认是字节序(按 Comparator 定义,默认字典序比较字节)。这也意味着你可以在键里利用字节序做"自然排序"——比如把时间戳编码成字节序可比较的格式。
时间序列的冷热分离设计
时间序列是 LevelDB 的"天作之合",但有个隐蔽的坑:旧数据不再写入,却仍参与 Compaction。想象一个时序系统,写入集中在最近一天,但历史三年的数据都还在库里——每次 Compaction 都要搬历史数据,写放大被历史数据拉高。
解法是冷热分离:把不同时间范围的数据分到不同的物理实例或"列族",对旧数据实例配置更激进的压缩或更低的 Compaction 优先级。这样热区保持高写入效率,冷区安静待着。这个思路背后是"按数据生命周期分层管理"的通用架构——存储系统里几乎所有"数据越写越慢"的问题,都可以用这个框架解决。
用"查询模式矩阵"设计键
设计键时,一个实用工具是"查询模式矩阵":列出业务所有查询(点查、范围、前缀扫描),标出各自的频率与敏感度,然后设计键让"最敏感最频繁"的查询变成"连续区间扫描"。
比如一个电商系统:查订单详情(点查)、查某用户某天的订单(复合范围)、查某商品近期的销量(前缀范围)。根据矩阵,键可以设计成"用户ID + 时间 + 订单ID"——把点查做成精确键、把"按用户看订单"做成连续区间、把"按商品看"交给反向索引。这个矩阵法把"键设计"从拍脑袋变成可推导的过程,也最容易在团队里沟通评审。
键值设计与后续调优的联动
设计良好的键值结构,会让第 6.1 节的参数调优事半功倍:有序键让 Compaction 局部化(写放大小)、让前缀压缩生效(空间省)、让布隆过滤器更准(读放小)。反过来,糟糕的键设计会让所有参数努力变成"在流沙上盖楼"。
所以一个负责任的调优流程应该是:先审数据模型(键值设计),再调引擎行为(参数配置),最后用监控验证(第 6.3 节)。把键值设计放在调优的第一位,不是因为它在技术上更高深,而是因为它的杠杆最大——改一个键格式的收益,可能抵得上调十个参数。
键值设计与"删除"的隐藏关系
键设计不仅影响读写,还影响删除的效率。还记得墓碑语义(第 3.3 节)吗?删除在 LSM 里是插入墓碑,物理清除要等 Compaction。如果待删除的数据在键空间里分散(随机键),墓碑会散布各处,Compaction 要跨大范围清理,效率低、延迟高;如果待删除数据天然聚在一段连续区间(比如"按租户前缀 + 时间"的键,某租户的旧数据都在连续范围),清理就局部高效。
这个隐藏关系告诉你:当业务有"批量过期清理"需求时(比如数据 TTL、定时归档),键设计要把"待清理的批次"设计成连续键区间。这样你可以用范围删除或针对性地触发 Compaction,让清理变成一次局部操作。很多"删除后空间迟迟不回收"的困惑,根子都在键设计没考虑删除的局部性——这个联动,是键值设计里最容易被忽视的价值点。
核心回顾
- 要点一:键顺序性直接决定 Compaction 局部性,是写性能的第一杠杆。
- 要点二:顺序写入让新 SSTable 只与尾部重叠,随机写入引爆大规模合并。
- 要点三:黄金法则是让写入顺序与键字典序正相关,时间/序列字段放前缀。
- 要点四:大 Value 三策略——指针化、内部碎片化、压缩编码,可混合使用。
- 要点五:整数键用二进制编码,节省空间且比较更快。
- 要点六:前缀设计用字典序模拟索引,支持高效范围扫描。
键值设计是从源头决定性能。但改完了怎么知道有没有效?下一节看监控指标,它是调优的"眼睛"。