7.1 衍生项目:RocksDB 与 HyperLevelDB 的分野
7.1 衍生项目:RocksDB 与 HyperLevelDB 的分野
本节摘要:围绕 LevelDB 的 LSM-Tree 范式,衍生项目沿着两条轴线展开:RocksDB 走"工业级横向扩展"(功能、策略、可配置性全面增强),HyperLevelDB 走"核心架构纵向深化"(对写路径并发做手术式优化)。本节用对比表讲清两条路线的目标、手段、复杂度与适用场景,并说明它们在生态中如何互补。
本节导读
阅读完本节,你应当能够:
- 说出 LSM-Tree 范式的五个攻坚方向
- 列举 RocksDB 的三大类关键增强
- 解释 HyperLevelDB 的写路径并发化改造思路
- 根据需求判断选"全面增强"还是"精准优化"
一、问题与直觉
LevelDB 本身是优雅而克制的,但互联网数据规模从 GB 飙到 TB,可用性要求升到"五个九",硬件从单核单盘演进到多核 NVMe——原教旨的 LevelDB 开始露怯:单线程 Compaction 是瓶颈,固定配置不够灵活,缺少事务等企业级功能。
于是衍生项目出现了。它们不是对 LevelDB 的否定,而是对 LSM-Tree 范式的深度发扬。关键问题变成:当一个范式被证明有效后,如何把它推向极致?答案分两条路:横向扩展(加功能、加策略)与纵向深化(对核心路径做手术)。
二、核心原理
攻坚方向:范式自带的问题清单
所有衍生项目都在对抗同一组问题:
- 写放大:数据后台合并被多次重写,缩短 SSD 寿命
- 读放大:一次点查要遍历多级文件
- 空间放大:旧版本未及时回收
- 并发与可预测性:Compaction 可能阻塞前台,造成延迟抖动
- 功能单一性:缺事务、分布式等高级特性支持
RocksDB:工业级增强之路
由 Facebook(现 Meta)开发,是影响力最大的衍生品。它的哲学是"给用户尽可能多的控制权",在 LevelDB 核心之上建了多层增强:
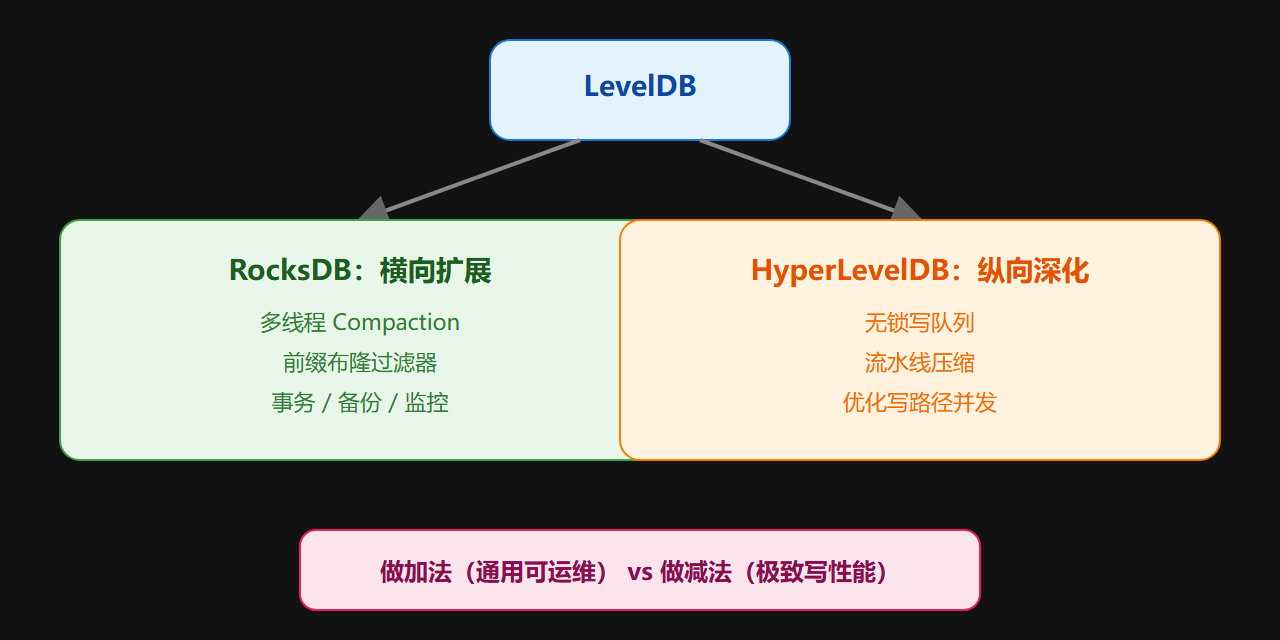
并发与控制极致化:多线程 Compaction(不同层甚至同层分区并行合并)、线程池隔离不同类型任务、可配置合并策略(Leveled/Universal/Tiered)、内存表多种实现可选、写入速率限制。
LSM 结构深度优化:前缀布隆过滤器(为键的共同前缀建过滤器,服务范围扫描预判)、L0 到 L1 的子压缩(Subcompaction)、范围删除(Range Deletion)用 Tombstone 高效处理大范围删除。
企业级功能集成:事务支持(WriteBatchWithIndex + 乐观并发控制)、备份与快照、InfoLog 与丰富 Statistics 输出。
HyperLevelDB:精准手术
由 HyperDex 团队开发,目标聚焦:解决 LevelDB 在高并发写入下的性能瓶颈和尾部延迟。它的诊断是:LevelDB 性能瓶颈根植于几个关键锁和单线程设计。
三项改造:
- 写流程并行化与锁优化:写入请求放入无锁队列,由专门写线程批量处理,把前端多线程的锁竞争转化为队列操作
- 流水线化后台合并:把合并任务分解为读取输入、排序合并、写入输出等阶段,让不同阶段并行处理不同数据块,I/O 与计算重叠
- 改进布隆过滤器与内存管理:更快哈希函数、更紧凑位图、更高效内存分配器
效果:高并发写密集负载下,吞吐更高更稳,写入延迟峰值显著降低。
三、工程实践要点
两条路线对比表
| 维度 | RocksDB | HyperLevelDB |
|---|---|---|
| 核心目标 | 工业级强度、功能丰富、可运维 | 极致高并发写入与低延迟 |
| 优化策略 | 横向扩展(做加法) | 纵向深化(做减法) |
| 架构复杂度 | 高 | 相对较低 |
| 适用场景 | 大型后端、分布式数据库底层 | 对写延迟极度敏感的专用中间件 |
⚠️ 常见坑:以为"RocksDB 是 LevelDB 的升级版,直接换就完事"。两者 API 与行为已逐渐分道扬镳,迁移需要大量调整;而且 RocksDB 数百个配置项是"复杂性的转移"——配置不当极易出生产事故。
💡 关键直觉:把两条路线想成"改造一辆车"。RocksDB 是把它改造成多功能房车(加装厨卫、太阳能、卫星电视),HyperLevelDB 是把它改造成纯赛道版(拆掉后排、改悬挂、轻量化)。房车适合全家出游(通用业务),赛道版适合跑圈速(极致写性能)。没有高下,只有用途。
SOURCE 独有事实
RocksDB 有两个来自工业界的细节值得记住:一是它用 WriteBatchWithIndex 提供跨键原子写并支持乐观并发控制(OCC)——这是 LevelDB 没有的事务能力;二是它的前缀布隆过滤器解决了 LevelDB 标准过滤器"只能判断键存在、无法预判范围扫描"的短板。这两个点恰好对应了"企业级功能"与"LSM 结构优化"两条增强线。
四、深入展开:读衍生项目的正确姿势
图:两条衍生路线谱系
衍生项目的核心价值是"对照学习"
很多人读 RocksDB 文档时迷失在几百个配置项里,问题出在"把衍生品当新引擎学"。正确的姿势是"对照 LevelDB 学":RocksDB 的每个增强,几乎都能在 LevelDB 里找到"它改了什么"的坐标。多线程压缩是改"单后台线程";前缀布隆过滤器是改"标准过滤器";Column Family 是改"单键空间"。
这个对照学习的价值在于:你不需要从头理解 RocksDB,只需要理解"LevelDB 骨架 + 每处增强解决了什么痛点"。当你看到一个 RocksDB 参数,先问"它对应 LevelDB 的什么、改了什么、为什么改",答案通常就藏在三放大的框架里。用这种方法,RocksDB 那几百个参数不再是负担,而是一张"LSM 优化路线图"。
横向扩展与纵向深化的更深区别
RocksDB 与 HyperLevelDB 的区别不只是"功能多 vs 功能少",而是两种不同的工程价值观:RocksDB 相信"给用户足够多的控制权,让用户为场景定制";HyperLevelDB 相信"把核心路径做到极致,别让用户操心"。前者把复杂度转给用户(换灵活性),后者把复杂度包在自己内部(换易用性)。
这个价值观差异决定了它们各自适合的团队:有专职 DBA/存储专家的大厂,RocksDB 的灵活性是资产;小团队追求"开箱即用、别出幺蛾子",HyperLevelDB 的克制更友好。选型时除了技术指标,还要考虑"团队能承担多少配置复杂度"——这往往是决定性因素。
为什么 RocksDB 成了事实标准
RocksDB 能成为互联网行业事实标准,不是因为"最快",而是因为"最可运维":多线程压缩缓解了写停顿、丰富的监控指标让问题可诊断、备份快照事务等企业级功能让生产可用性提升。它证明了一个道理——工业级引擎的竞争,赢在"可靠性、可观测性、可运维性"的综合分数,而不是单项性能。
这对你的启示是:评估存储引擎时,不要被基准测试的峰值数字迷惑。一个 P99 稳定、问题可诊断、运维有据可循的引擎,远比一个"纸面最快但出了事无从下手"的引擎有价值。这个"综合分数优先"的价值观,是 LevelDB 和 RocksDB 两代引擎都用实践教会我们的。
常见问题
问:RocksDB 能完全替代 LevelDB 吗? 在多数生产场景能,但引入 RocksDB 意味着更大的复杂度与配置负担。如果业务简单、不需要高级特性,LevelDB 依然够用且更轻。
问:为什么没有第三个"更完美的衍生品"? 因为 LSM-Tree 的核心矛盾(三放大三角)是结构性的,任何衍生品都只能在三角里换位置,无法同时消除所有代价。完美是不存在的,每个项目都是在为自己的目标负载做最优妥协。
问:HyperLevelDB 现在还在用吗? 它的核心价值更多在思想层面——证明了"对写路径做手术式并发优化"的可行性,影响了后来者。工程上它被更活跃的项目(如 RocksDB)的演进所吸收。
一张"衍生品地图"帮你记住生态
把 LevelDB 生态按"优化方向"分类,可以画一张便于记忆的地图:
- 性能极致化:RocksDB(多线程/性能)、PebblesDB(碎片优化)、TerarkDB(压缩算法)
- 功能扩展化:HyperLevelDB(事务尝试)、LevelDB with TTL(生命周期)、支持 SQL 层
- 环境特定化:LevelDB for Mobile(移动端)、LevelJS/LevelUP(浏览器环境)
- 架构融合化:作为分布式存储层(CockroachDB、TiKV)、流处理状态后端(Flink)、区块链数据引擎(比特币、以太坊)
这张地图的价值在于:它把"为什么会有这么多衍生品"的答案结构化——不同时代、不同硬件、不同业务需求,都在推动对 LSM 范式的"再设计"。当你遇到一个新的 LSM 系引擎,先看它在这张地图的哪个象限,就能快速定位它的核心诉求。
衍生品生态给我们的行业启示
LevelDB 生态的繁荣揭示了一个软件工程规律:一个设计良好的"范式实现"(而非"功能齐全的产品"),反而更容易催生生态。因为范式清晰、边界明确,后来者可以在上面做"加法"而不用担心动到核心逻辑。如果 LevelDB 一开始就堆满功能,反而会限制衍生——改一个功能都牵一发动全身。
这个启示对架构决策有直接意义:当你设计一个被多方复用的组件时,"边界清晰、内核克制"比"功能齐全"更能吸引生态。把核心范式做对、把接口做稳,把复杂语义留给上层去组合——这是 LevelDB 用十年生态证明的路径。理解了这一点,你就能欣赏"做少"背后的战略眼光,而不只是把它当成"功能简单"。
回到选型的落点
回到本章开头的问题:"选 LevelDB 还是 RocksDB?"答案如今清晰了:如果业务简单、追求轻量可靠、不想承担配置复杂度,选 LevelDB;如果业务复杂、需要企业级功能、团队有存储专家,选 RocksDB;如果追求极致的写性能且场景纯粹,参考 HyperLevelDB 的思路自研或选类似定位的引擎。没有"最好",只有"最匹配团队能力与业务需求"的选项。这个落点,也是全书"对比驱动"主线的最终归宿——理解每一条选择路径背后的权衡,你就不会再被任何"引擎推荐"带节奏。
衍生品选择的一个隐藏考量:升级路径
选衍生品还有一个容易被忽略的维度——升级路径。LevelDB 核心稳定、接口简单,向 RocksDB 迁移是"向上兼容但需评估"的路径;反过来从 RocksDB 退回 LevelDB 几乎不现实(功能落差太大)。所以很多团队的做法是"先用 LevelDB 跑起来,预留抽象层,数据规模需要时再换 RocksDB"。
这个"先轻后重"的渐进策略,比"一步到位上 RocksDB"更稳妥:它让你在早期避免配置复杂度,同时保留了升级的弹性。前提是应用层做好"引擎抽象"(不直接依赖 LevelDB 特有 API),这样将来替换时才不用重写业务代码。理解了这个隐藏考量,你会发现选型不只是"当下的选择",更是"为未来保留什么选项"的决策——这层思考,常常比技术指标本身更影响长期成败。
要点串联
- 要点一:衍生项目攻坚五大方向——写放大、读放大、空间放大、并发、功能单一性。
- 要点二:RocksDB 走横向扩展,三大类增强是并发控制、LSM 优化、企业级功能。
- 要点三:HyperLevelDB 走纵向深化,核心是无锁写队列 + 流水线压缩。
- 要点四:两条路线分别服务"通用可运维"与"极致写性能"两种需求。
- 要点五:RocksDB 与 LevelDB 已分道扬镳,迁移需评估兼容成本。
- 要点六:健康的生态是主流项目海纳百川、小众项目锐意创新的互补格局。
引擎谱系理清了,接下来看这些引擎如何被塞进完全不同的业务——Chrome、以太坊和消息队列的适配故事。