1.1 项目起源与哲学:从 whisper.cpp 到 llama.cpp
1.1 项目起源与哲学:从 whisper.cpp 到 llama.cpp
本节摘要:llama.cpp 不是一个凭空出现的项目,它是 Georgi Gerganov 在 whisper.cpp 上验证过的「极简 C 工程哲学」在大语言模型上的延续。理解这段起源,你才能理解它为什么坚持零依赖、为什么执着于 CPU、为什么后来一切都围绕量化展开。本节是全书的起点:先知道它是谁,再学怎么用它。
故事可以从保加利亚讲起。Georgi Gerganov 是一位习惯在音频算法层面抠性能的工程师,2022 年底他做了件在旁人看来吃力不讨好的事:把 OpenAI 刚发布的 Whisper 语音识别模型用纯 C 语言重写一遍,取名 whisper.cpp。重写的结果超出所有人预期——不依赖 PyTorch,不依赖显卡,一台普通 MacBook 的 CPU 就能实时转写语音。这件事证明了一个当时被主流忽视的判断:Transformer 推理的瓶颈不在「有没有 GPU」,而在「实现够不够贴近硬件」。
一、问题与直觉:2023 年春天的算力鸿沟
真正的引爆点在 2023 年 3 月。Meta 泄露的 LLaMA 权重在社区疯传,无数开发者第一次拿到能与 GPT-3.5 掰手腕的开源权重,随即撞上一堵墙:主流推理路径要装 PyTorch,要装 CUDA,动辄十几个 GB 的依赖;而当时 7B 模型以半精度加载需要约 13GB 内存,主流消费级显卡的 8GB 显存根本装不下。服务器上跑得起,普通开发者自己的电脑跑不动——这个鸿沟在当时的讨论区里随处可见。
Gerganov 的回应是反直觉的。别人在讨论「哪张卡能装下」,他在想「能不能把模型压进内存、只用 CPU 跑」。2023 年 3 月 10 日,llama.cpp 的第一个提交出现在代码仓库里。四周之后的演示视频里,一台 M1 MacBook 以可接受的速度生成了流畅文本, quantization——量化——这个词第一次以「本地推理标配」的姿态进入大众视野。原作者后来如此总结这套打法:把模型压到 4 比特,让内存带宽成为主要约束,再把每一个字节宽度的搬运都优化到极致。
二、极简哲学的三条支柱
回看 whisper.cpp 与 llama.cpp,两条产品线共享同一套工程哲学,可以拆成三条支柱。
支柱一:依赖越少,世界越大。 整个推理引擎只依赖 C/C++ 标准库与自带的 ggml 张量库。没有 Python 解释器、没有 CUDA 运行时、没有包管理器地狱。代价是开发效率低,收益是任何能编译 C 的平台都能跑它:x86 笔记本、ARM 手机、树莓派、任天堂掌机 mod 圈甚至有人拿它跑模型。对本书的实验志叙事来说,这条支柱直接决定了「旧笔记本复活」的可能性——2019 年的硬件驱动生态再老,也总能编译出一个 C 程序。
支柱二:量化不是可选项,是第一公民。 主流框架把量化当作训练后的「压缩附件」,llama.cpp 从设计之初就假定权重是 4 比特整数。ggml 的所有矩阵乘内核都是围绕分块量化布局写的:32 个权重打包成一个块,块内共享缩放因子,反量化与矩阵乘在一次循环里完成。这个设计让 4 比特模型的速度往往反超 16 比特——数据量小了四倍,内存带宽省了四倍,而现代 CPU 的向量指令单元对整数运算同样高效。
支柱三:单文件交付。 模型、词表、架构参数打包进一个 GGUF 文件(第 2 章细讲),程序编译出来是一个(或少数几个)可执行文件。部署动作被压缩到「拷文件、跑起来」两级。你后面会看到,第 7 章的服务化、第 8 章的多模态,都建立在这个交付形态上。
演化时间线
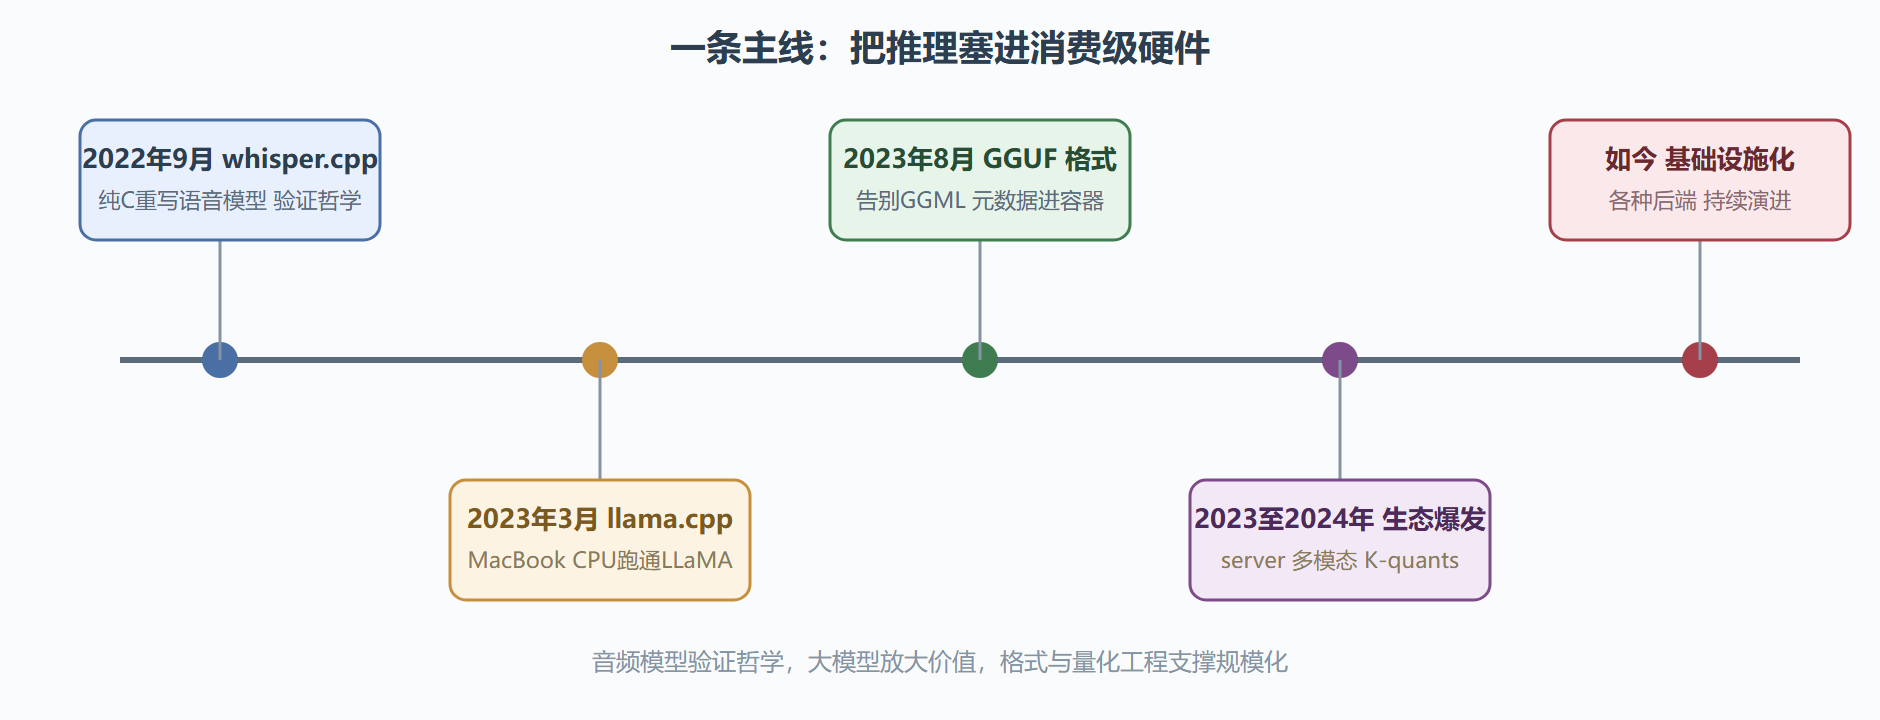
把 llama.cpp 的关键节点放在一条线上看,能发现它的每一步都在兑现上述哲学。
图 1-1 llama.cpp 关键演化节点:从音频玩具到推理基础设施
三、这与你有什么关系:三个直接推论
哲学落到使用层面,给出三条实用推论。
第一,优先自己编译或用官方发布产物,而不是第三方转手的二进制。零依赖意味着编译门槛极低(第 4 章全程演示),而第三方转手的包可能落后几个版本——llama.cpp 的性能修复几乎每周都在发生。
第二,日志是你的第一调试工具。没有框架层遮着,llama.cpp 把加载、分层、显存分配的每一步都打印在标准输出里。第 5 章的显存账本,就是从启动日志里逐行对账对出来的。
第三,别把它当训练工具。它的定位是推理。微调要靠别的前端完成,llama.cpp 只负责把微调产物(LoRA 适配器,第 8 章)合并或挂载后高效地跑起来。把它放对位置,期望才不会错位。
跑第一个模型之前,先看看一次典型的命令行长什么样,感受一下「单文件交付」的体验:
# 编译完成后,加载 4 比特量化模型并开始对话 llama-cli -m qwen2.5-7b-instruct-q4_k_m.gguf -c 4096 --temp 0.7 -p "用一句话解释什么是量化" # 典型输出片段(节选自那台 2060 小本的真实日志,数值因机器而异) # load_tensors: offloaded 29/29 layers to GPU # prompt processing time = 285 ms / 24 tokens # 量化是把高精度浮点权重映射成低比特整数的过程,用少量精度损失换取数倍的体积与带宽节省。
两行日志值得现在就记住:offloaded 29/29 layers 说明全部层进了显存(第 5 章会教你为什么常常只卸载一部分);prompt processing 与生成速度是两个分开计量的阶段(第 5.2 节的实验会拆开讲)。
三条支柱的再权衡
哲学不是教条,三条支柱各有代价,值得摆在桌面上。零依赖的代价是生态位窄:数据预处理、评估集管理、训练工具链都不在它的版图里,你得用别的工具补齐外围。量化优先的代价是精度敏感任务的适配成本:对数值误差极端苛刻的科学计算类需求,低比特路线需要谨慎评估甚至放弃。单文件交付的代价是更新频繁:主干每周合并大量改动,「哪个版本的行为是标准」需要你自己锚定(7.1 节的版本纪律就是为此准备的)。理解代价不是劝退,而是让你在别人吹捧或贬低这个项目时,能有自己的一杆秤。
常见问题
llama.cpp 与 ggml、GGUF 到底什么关系?
ggml 是底层张量运算库,负责矩阵乘与量化内核;GGUF 是模型文件的容器格式,规定权重与元数据怎么存;llama.cpp 是站在两者之上的推理引擎,负责加载、调度与生成。三者同宗同源但职责分明,混称是社区文章里最常见的概念搅浑。
它和原版 Meta 的推理代码是什么关系?
没有任何代码继承关系。llama.cpp 是对 LLaMA 架构的独立实现:作者按论文与参考实现重新写了前向计算,再用自己的张量库加速。这种独立实现让它不受原版技术栈约束,也解释了为什么它能跑得比参考实现轻得多。
现在入坑会不会太迟、项目会不会被取代?
从工程价值看,它解决的问题(消费级硬件上的高效推理)长期存在;从生态看,大量上层工具以它为引擎。被取代的前提是有人用更少的资源做同样的事——这个赛道上它仍是最激进的选手之一。真正会变的是具体参数与后端格局,这正是全书强调方法而非记参数的原因。
本节要点回顾
- 起源即答案:llama.cpp 是 whisper.cpp 验证过的「贴近硬件」哲学在大模型上的放大,2023 年 3 月立项,数周内跑通 MacBook;
- 三条支柱:零依赖换跨平台、量化是一等公民、单文件交付,后续每一章的实验设计都能追溯到这里;
- 它只管推理:训练、微调用其他工具,llama.cpp 负责把成果跑起来,别错放期望;
- 读日志的习惯从这里开始:offload 层数与两阶段耗时是启动日志里最有信息量的两行;
- 下一节预告:要读懂日志里的行话,你得先补齐术语底座——token、位宽、上下文窗口,这就是 1.2 的任务。