- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:把大模型搬回你自己的机器
先拆一个行话:offload。混过大模型社区的人多半见过这句炫技——「我把模型 offload 了三十三层,速度翻倍」。这句话背后藏着 llama.cpp 全部工程智慧的入口:所谓 offload,就是把模型的若干层权重从内存搬进显存,让 CPU 与 GPU 分工干活。搬几层、怎么搬、搬完之后每一 MB 显存花在哪儿,这些决策没有标准答案,只有针对你手上那台机器的实测答案。
这本教程要教的,正是拿到这份答案的方法。全书一切实验都围绕一台 2019 年的老笔记本展开:i7-9750H 六核处理器、16GB 内存、RTX 2060 显卡只有 6GB 显存——放在今天连中端都算不上。选它做主角是刻意的:llama.cpp 的价值恰恰在于,一台被主流 AI 叙事判了「死刑」的旧机器,依然能把 70 亿到 80 亿参数的模型跑得像模像样。你的机器多半比它强,书里的每个实验你都能直接复现并超过。
这本教程写给谁
三类读者会对路:手里机器普通、想验证「本地跑大模型」到底现实的个人开发者;需要在内网或离线环境交付推理能力的工程师;以及想真正理解推理引擎内部——格式、量化、显存、调度——而不是停留在封装壳使用层的学习者。前置要求很轻:会用命令行、知道一点 Python、对大模型有基本概念即可,其余全部从零讲起。
这本教程的主线
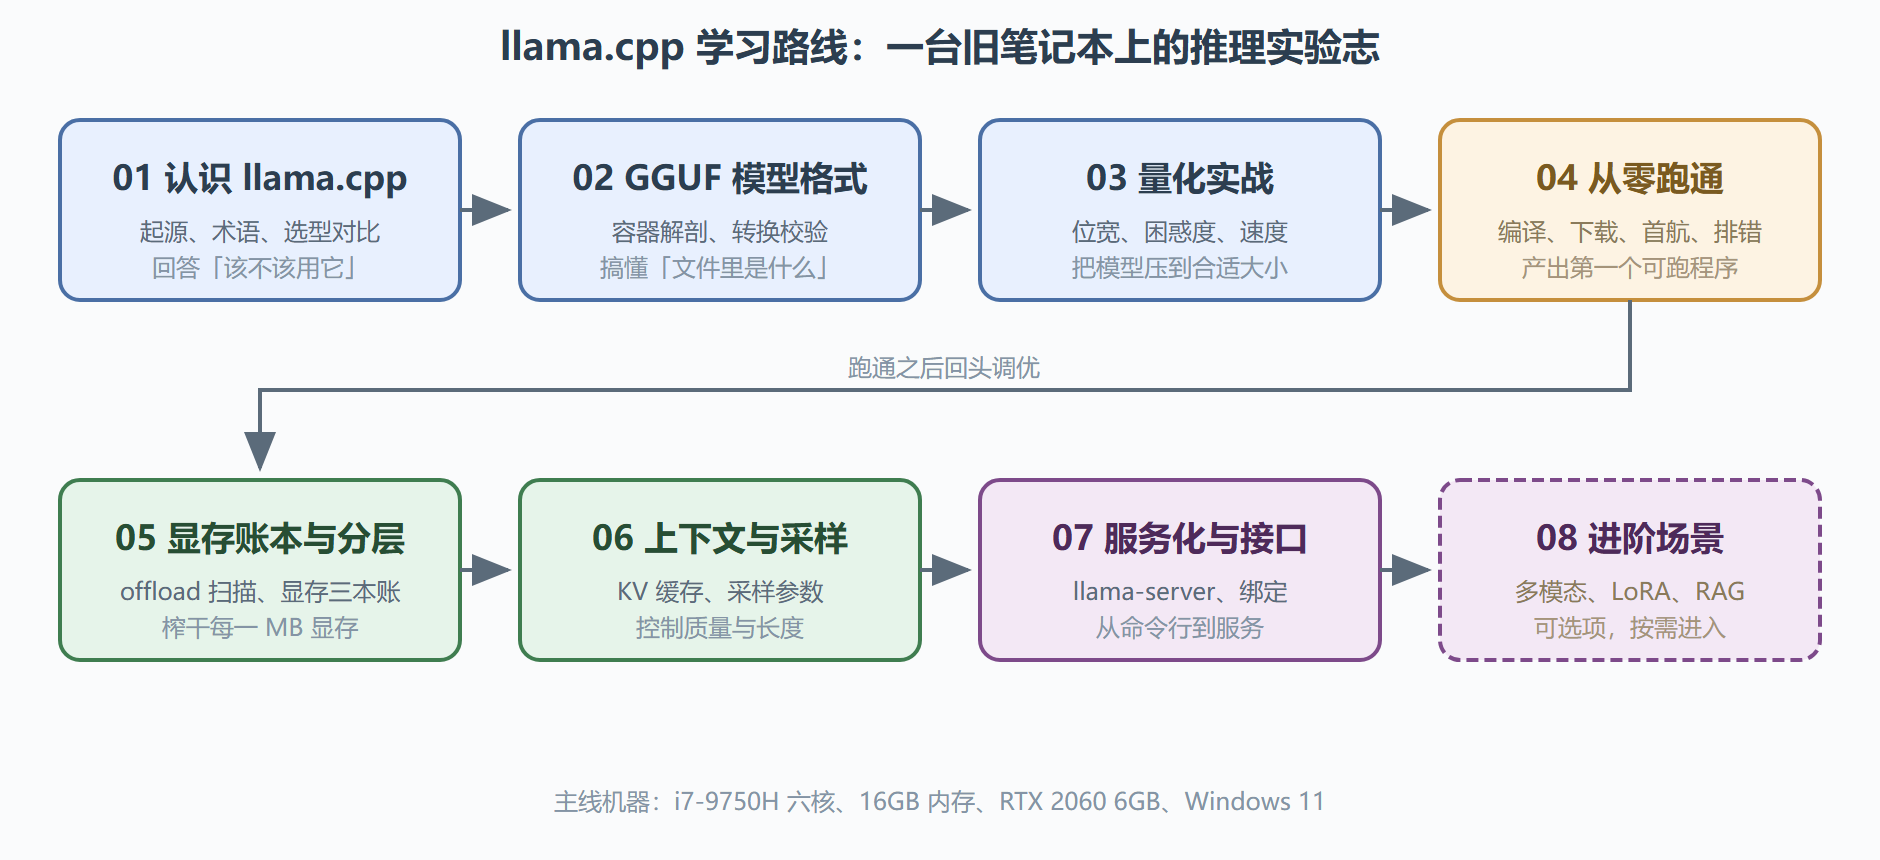
八个章节沿一条实验主线推进:先想清楚「该不该用 llama.cpp」,再搞明白「模型文件是什么」,然后「把模型压到合适大小」,接着「编译出第一个可执行文件并跑通」,进入「显存与加速的调参实验」,随后「控制上下文与采样质量」,最后「把命令行程序变成服务与产品」。每一章都从上一章遗留的问题出发,用实验给出答案,再把新的问题交给下一章。
全册知识地图
下图是八章的学习路径与依赖关系,虚线框是可选的进阶内容。
图 0-1 全册知识地图:八章的学习路径与依赖
读完这本教程你能做什么
把脑子里「本地跑大模型」这个模糊念头,换成一套可操作的手艺:会看 GGUF 文件名就懂得它的位宽与用途;会按显存预算挑选量化等级,而不是照抄别人的命令;会把 llama.cpp 从源码编译成适配自己硬件的可执行文件;会用分层卸载实验找到速度拐点,并算清权重、KV 缓存、计算缓冲三本显存账;会用上下文与采样参数把生成质量调到任务需要的档位;最终能把命令行玩具升级成兼容 OpenAI 接口的本地服务,再接上多模态、LoRA 与检索增强,搭出一个完全离线运行的知识库。
怎么读这本书
赶时间的读者走「最小路径」:第 1 章的选型对比、第 3 章的位宽实测、第 4 章的编译与首航、第 5 章的显存账本,四个点连起来就够你把模型跑起来。想以此为业的读者请按顺序通读:第 2 章的格式细节与第 6 章的采样实验,是你在排错与调优时最常回头翻的两章;第 7、8 章则是把玩具变成产品的桥梁。每章末尾的「下一章的接力」会告诉你主线走到了哪,不必担心迷路。
版本与约定
全书实验基于 2025 年内的主线版本完成,llama.cpp 迭代很快,个别参数名可能随版本微调,但机制层的知识——格式、量化、账本、调度——经年有效。行文约定也在此统一:「卸载」与 offload 同义,指把模型层放进显存;「窗口」即上下文窗口的简称;「档位」指量化位宽等级。所有命令行示例默认在 Git Bash 环境执行,PowerShell 用户只需替换续行符,其余无差。书中所有实验数据都注明了硬件与量级属性:数字因机器而异,趋势与方法是通用的——这正是这本实验志想交给你的东西。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...