2.2 GGUF 容器解剖:元数据、张量与对齐
2.2 GGUF 容器解剖:元数据、张量与对齐
本节摘要:GGUF 用「键值对元字典 + 按对齐排布的张量区」两段式结构,把上一节 GGML 的三大病灶逐一拆解:元数据变成可扩展的字典,词表与模板进文件,张量按对齐规则排布以适配 mmap。本节画出完整的文件布局图,并带你用几十行代码亲手读出文件头部——理解到字节级,后面的量化与排错才有根。
承接上节的病灶清单,GGUF 的结构可以概括为一句话:文件自己会说话。它不再是等着程序按偏移猜内容的哑数据,而是带着完整说明书的自描述容器。
一、整体布局:三段式
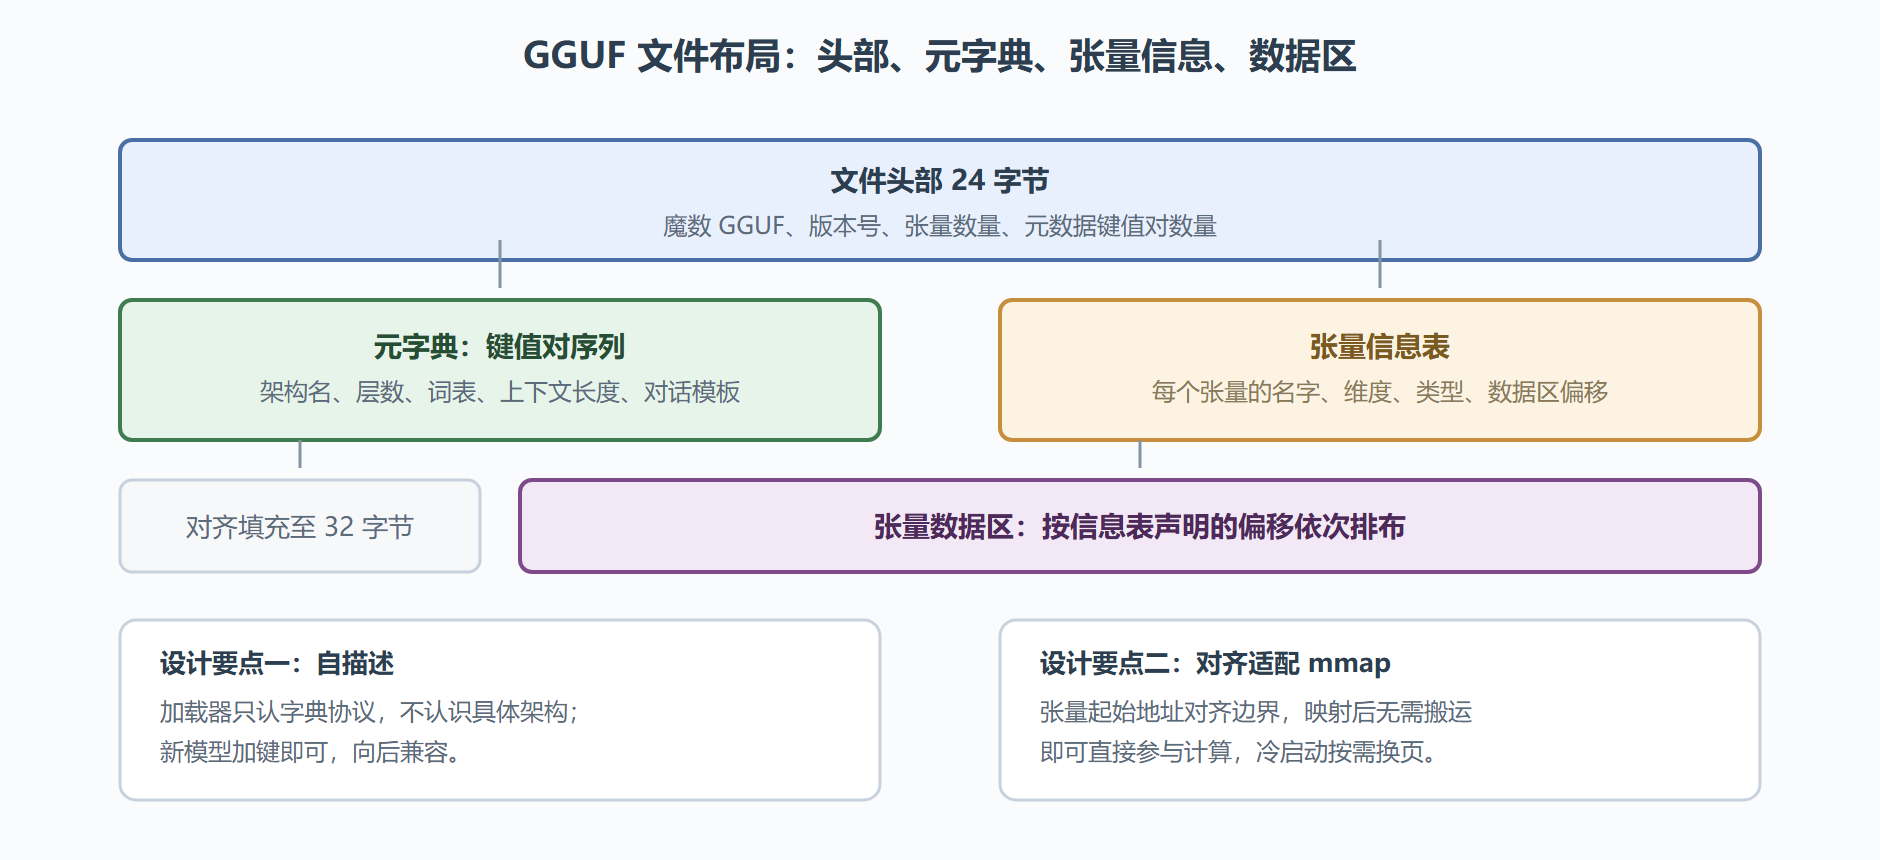
一个 GGUF 文件从前往后依次是:固定头部、元字典、张量信息表、对齐填充、张量数据区。头四个字节是魔数 GGUF 的 ASCII 编码,随后是版本号、张量数量、元数据键值对数量。下面这张标注图值得对照着多看两眼——第 4 章排查「文件加载失败」时,你会回到这里找原因。
图 2-1 GGUF 文件字节布局标注示意
二、元字典:模型的名片
元字典是一串键值对,键是字符串,值带类型标签:32 位整数、浮点数、字符串、布尔、数组,乃至嵌套。常见键包括 general.architecture(架构名)、llama.block_count(层数)、tokenizer.ggml.tokens(词表数组)、tokenizer.chat_template(对话模板)。对比 2.1 节的病灶:新架构要携带新参数,只需新增键值对,老版本加载器遇到不认识的键直接跳过——扩展不再破坏兼容。
对话模板也住在字典里,这件事的实用价值常被低估。聊天乱码问题的最大来源就是模板错配,模板内置后,只要文件来源可靠,加载器能自动套用正确的模板,第 7 章服务化时会再次受益于这个设计。
三、张量信息表与对齐
元字典之后是张量信息表:每个张量登记名字、维度、类型与数据区内的偏移。注意偏移是相对数据区起点的,而数据区起点必须对齐——默认对齐值 32 字节,由 general.alignment 键控制。对齐不是为了好看:mmap 映射后,张量数据要求在内存中可以直接按向量指令读取,不对齐就得先拷贝再算,白白多一次搬运。
张量类型字段直接采用 ggml 的类型编号:0 号是 32 位浮点,1 号 16 位浮点,后面的编号全是量化家族——2 号 4 位旧量化,若干号之后是 K 系、I 系量化。看到这里你该意识到:量化位宽是文件的内在属性,不是加载时的选项。加载一个 Q4_K_M 文件,内存里就是 4 比特布局;想要 8 比特,得换一个文件或自己转一个(第 3 章的位宽实测正是建立在这一点上)。
四、亲手读头部
规格读三遍不如代码跑一遍。下面这段 Python 不依赖任何第三方库,直接按规范解析文件头部并枚举前若干个元数据键:
import struct def peek_gguf_header(path, max_keys=12): with open(path, "rb") as f: magic = f.read(4) assert magic == b"GGUF", "不是 GGUF 文件" version, tensor_count, kv_count = struct.unpack("<IQI", f.read(16)) print(f"版本 v{version} | 张量 {tensor_count} 个 | 元数据 {kv_count} 条") # 键值对的完整解析需按类型递归读值,此处示意读取流程 # 完整实现可参考仓库自带转储脚本:python gguf-py 脚本 return version, tensor_count, kv_count peek_gguf_header("qwen2.5-7b-instruct-q4_k_m.gguf") # 典型输出(数值随模型而异): # 版本 v3 | 张量 489 个 | 元数据 38 条
配套的正式工具是仓库里的 GGUF 转储脚本,能把全部键值对与张量清单打成可读文本。第 3 章校验量化位宽、第 4 章排查下载损坏,都会用它。这里先埋个钩子:张量 489 个这个数字本身就有信息量——7B 级模型每层十几个张量、三十多层,再加输入输出层,量级正好对上;如果文件声称是 7B 却只有几十个张量,八成是坏文件或假文件。
五、版本小史
GGUF 发布至今有过 v1、v2、v3 三个版本:v1 是初版;v2 修正了计数与对齐相关的整数宽度问题,此后成为主流;v3 引入了大模型需要的若干扩展。日常使用无需纠结版本号——现行工具链产出的都是 v3,加载器向下兼容 v2。你只需要记住一点:从网上下到 v1 的老文件时,直接用当前工具重新转换一遍,比排查兼容性问题快得多。
元数据键速查
日常打交道的元数据键集中在四个族。身份族:general.architecture 声明架构(加载器据此选择计算图)、general.name 与 general.file_type(后者编码了量化档位信息)。形状族:各架构前缀的层数、嵌入维度、头数等键(如 llama.block_count),它们决定显存账本里权重与缓存的算法参数。词表族:tokenizer.ggml.tokens 与分数数组,词表本体住在文件里。模板族:tokenizer.chat_template,对话格式就绑在这一个键上——排查乱码时第一个检查它。查阅一个陌生模型时,按「身份、形状、词表、模板」四族的顺序过一遍键值,五分钟就能建立对它的完整画像,这个习惯在选型与排错两头的收益都极大。
常见问题
键值对的顺序有讲究吗?
元字典按写入顺序排列,但读取方按键名查找,顺序无关紧要。转换工具的输出顺序是稳定的,若两份文件的同名键值不一致,那不是顺序问题,是文件确实不同。
自己往文件里加自定义键可行吗?
规范上可行(键值对天生可扩展),工具链也提供编辑手段。但自定义键对推理毫无作用——加载器只认白名单键,额外键只是「躺着」的注记。做标注用,别指望它影响行为。
张量名有什么规律?
主流命名形如「层号.作用.类型」,例如blk.27.attn_q 表示第 28 块的注意力查询投影。第 8 章讲 LoRA 时会看到适配器张量与主模型张量按同名对齐挂接——届时你会感谢命名规律带来的可读性。
对齐的一个直观实验
对齐的价值可以亲手验证:把一份小模型分别用默认对齐与过大对齐值各转一份(转换工具支持对齐参数),对比文件大小与首 token 延迟。过大对齐让张量之间的填充空隙变大,文件虚胖几个百分点,加载与计算却没有任何收益——填充不参与计算,只是占位。反向想过,默认对齐值是「刚好满足映射要求的最小浪费」,规格里的每个数字都是权衡的产物。这个五分钟的小实验,能把「对齐」从抽象名词变成看得见的字节差异,值得在换机的第一天做一次。
本节要点回顾
- GGUF 的结构是三段式:头部、元字典、张量信息表加对齐后的数据区;
- 元字典让架构扩展不再是破坏性变更:加键即扩展,老加载器跳过未知键;
- 对话模板内置:从根源上压制了「模板错配导致乱码」这一历史顽疾;
- 对齐服务 mmap:张量直接映射即可计算,冷启动快、内存占用可控;
- 量化位宽内嵌于张量类型字段:选位宽就是选文件;
- 下一节动手实践:把一份开源权重亲手转成 GGUF 并验证它真的能用。