4.1 从联邦架构到 Server Pools
4.1 从联邦架构到 Server Pools
本节摘要:Server Pools 是 MinIO 当前的扩容模型:集群由一个或多个规格一致的池组成,写入按剩余空间加权路由,池间数据永不自动搬移。理解这个模型要先看它取代了什么——本节从联邦时代的旧方案讲起,讲清"加池不搬数据"的设计为什么赢。
"Server Pool"这个词到底在说什么
行话拆解先上桌。"池"(pool)这个词在存储行业身兼数职:内存池、连接池、存储池,每个语境含义都不同。MinIO 语境里的 Server Pool 有精确的定义:一组节点与它们的全部磁盘,组成一个独立的纠删码编队。你在 2.2 建的四节点 16 盘集群就是一个池;当它不够用,你再建第二个池——可以是对等的四节点,也可以是更大的规格。多个池共用一个命名空间对外服务,应用视角里它们仍是一个 MinIO。
把这个词和"集群"区分开:集群(cluster)是逻辑整体,池是物理编队。一个集群一个池是常态,一个集群多个池是扩容后的形态。行话捋顺了,后面的演化史才读得懂。
旧时代的两难:联邦的兴衰
在 Server Pools 之前,MinIO 处理超大规模集群的方案叫联邦(federation):多个独立集群各自服务,靠一套 DNS 轮换机制(按桶名把请求引到所在集群)拼出一个"伪全局"命名空间。联邦解决了"单集群终究有规模上限"的问题,但留下三个尴尬:
- 桶是孤岛。桶建在哪个集群就一辈子在哪个集群,跨集群迁移桶要靠客户端工具搬运,门面统一、里子割裂。
- 容量利用率失衡。A 集群塞满而 B 集群空转的场景无解,人工平衡桶的分布成了固定运维负担。
- 多套管理面。每个集群独立的账号、策略、监控,管理成本随集群数线性上涨。
社区里关于联邦的讨论最终收敛成一个认识:问题不在联邦做得不好,而在"扩容需要数据搬移"这个隐含假设太贵。搬数据意味着 IO、带宽、窗口期和一致性协调,每一项都是事故温床。那么反过来想——能不能不搬?
Server Pools:把"不搬"变成设计
答案就是 Server Pools 模型,它的规则朴素到近乎固执:
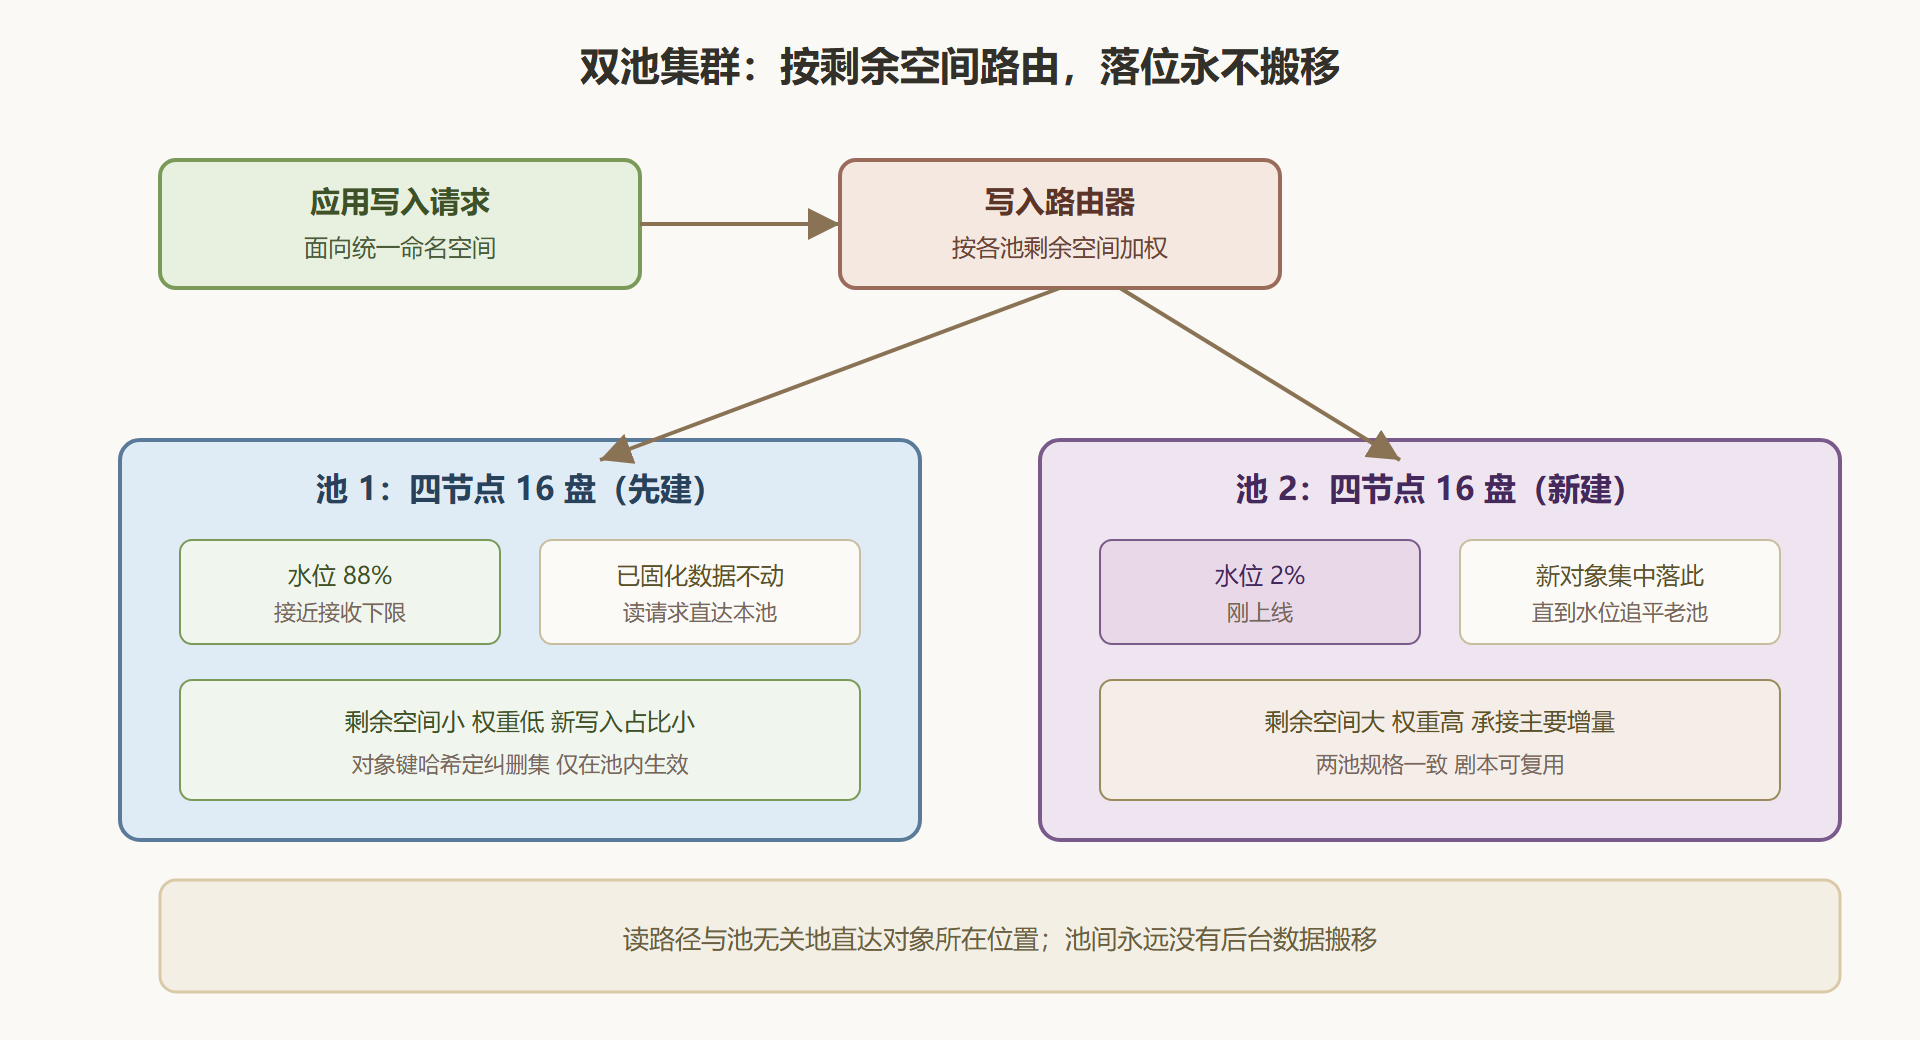
- 写入路由按池加权:新写入的对象,按各池剩余可用空间的比例分配落点。空池多接客,满池少接客,直到满池不再接收。
- 数据一经落位永不搬家:对象属于哪个池,从写入那一刻锁定到被删除。没有后台重平衡,没有静默的数据迁移。
- 池规格建议一致:多池场景下,新旧池的纠删配置与盘位规模保持同构,运维心智与故障处理剧本才能复用。
这套规则的效果是把扩容从"手术"降级成"扩建":新池上线瞬间完成,无数据搬移、无性能扰动、无窗口期;旧池该什么节奏退休就什么节奏退休。代价同样直白——池的利用率不均:老池先填满,新池后填,各池的水位天然错位。MinIO 的回答是"这是容量规划的责任,不是系统的责任",规划方法见 4.3。
图 4-1 双池集群的写入路由与数据固化
模型带来的三个规划推论
推论一:容量按池做预算。 由于数据不搬移,每个池都是一份独立的容量承诺。规划新池时问的问题是"这批硬件退役前能装下多少年的增长",而不是"集群平均能装多少"。
推论二:池是故障域也是运维域。 池内纠删集的坏盘、heal、换盘流程自成一体;多池集群的巡检要按池并行展开,监控面板按池分组是 8.2 的建议配置。
推论三:退役要靠显式指令。 想让老池把数据交出去,用的不是"重平衡",而是 decommission(退役)命令——它把老池的数据按对象搬到其他池,搬完才允许摘除。这不是后台顺手做的,是你要发起、要盯进度、要验收的正式变更。
本节要点回顾
- 池的定义:一组节点与盘组成的独立纠删码编队,集群的物理分身,应用的统一后端。
- 联邦的教训:桶成孤岛、容量失衡、管理面翻倍,根源是"扩容要搬数据"的假设。
- Server Pools 三规则:按剩余空间加权路由、数据落位永不搬移、多池规格保持一致。
- 利用率不均是特性不是缺陷:它把复杂度从运行时搬到了规划时,而规划时的错误便宜得多。
池的模型清楚了,下一节往地基再看一层:盘怎么接、文件系统怎么选、元数据住在哪里。
写入路由的两个细节
模型之外有两个实现细节,影响规划口径,值得单独立条。
细节一:权重按剩余字节数算,不按百分比。 路由加权看的是各池可用空间的绝对量。这意味着一个大池与一个小池并存时,大池天然承接更多写入——又一条"保持池规格一致"的理由:规格一致,权重分布才符合直觉,水位走势才容易解读。
细节二:元数据操作与数据路由是两回事。 建桶、改策略、设生命周期这类元数据操作作用于整个命名空间,在所有池间保持一致;只有对象数据的写入才按权重选池。理解这一点,就不会问出"桶建在池 1,能不能写到池 2"这类问题——桶没有物理归属,对象才有。
两个路由相关的常见疑问
读请求会跨池找数据吗?
会按对象所在位置直达。对象在哪个池,读请求就被引导到哪个池的分片上,不存在"先问池 1 再问池 2"的遍历。读路径的延迟因此与集群总池数无关——多池不会让读变慢。
池的规格可以不一样吗?
可以运行,不建议规划。异构池在容量权重、纠删配比、故障剧本上各成体系,监控与值班的心智负担翻倍。除了一次性的过渡期,长期运行的多池集群都应保持同构,退役旧池后重新收敛。
一段演化的历史注脚
理解 Server Pools 的设计取舍,还可以从"它拒绝成为什么"的角度看。业界另一些分布式存储选择了彻底对等的数据湖形态:所有节点共同组成一个巨大的分片空间,加节点即扩容,数据自动重平衡。这条路的产品体验极其顺滑,代价是系统内部永远跑着一台看不见的"搬家机器"——重平衡的流量、一致性的协调、以及搬家期间性能的不可预测性。Server Pools 的作者们显然权衡过这条路的诱惑,最终选择了把"搬家机器"从运行时拿掉:数据一经写入就钉在池里,系统的任何时刻的行为都可以用纸和笔推演出来。
两种形态没有绝对优劣,但适用人群截然不同:前者适合"存储由厂商托管、用户只管交钱"的云服务;后者适合"存储由自己的团队运营、行为必须可预期"的私有环境。MinIO 的私有环境基因,决定了它必然选后者。理解了这层基因,你对它的很多"怪脾气"——扩容不搬数据、池规格要一致、退役要显式指令——就不再是需要记忆的规则,而是顺理成章的推论。规则背了会忘,推论不会。