4.2 存储后端与文件系统:XFS 为什么是默认答案
4.2 存储后端与文件系统:XFS 为什么是默认答案
本节摘要:MinIO 对底下的存储层有一条简短的命令:把裸盘直通给我,格式化成 XFS,其余的别掺和。本节解释这条命令背后的三个理由——直接盘访问的性能语义、XFS 的规模与稳定性、元数据内联设计对本地文件系统的依赖——并逐一检查常见替代方案的风险。
地基课上的一张栈图
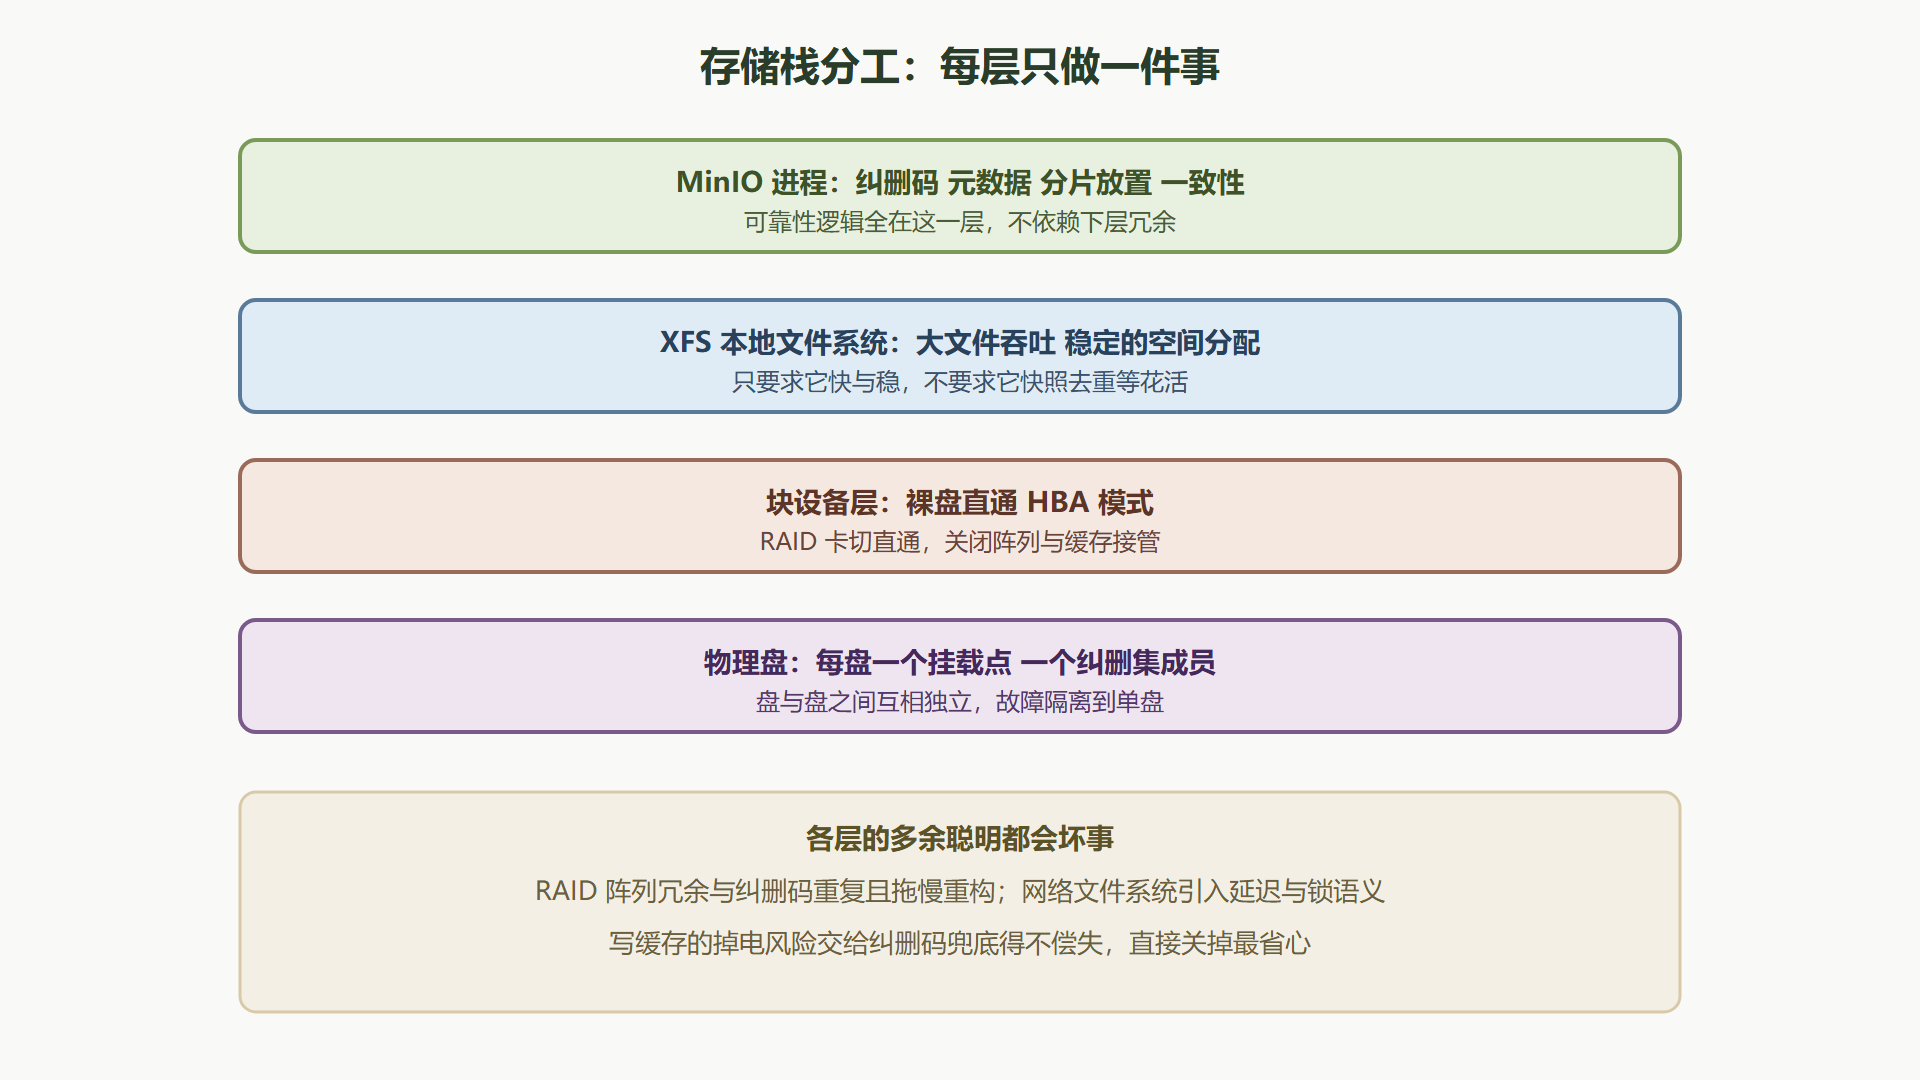
讲存储后端,先把分层摆清楚:MinIO 进程之下是本地文件系统,文件系统之下是块设备与 HBA(主机总线适配器),再往下才是物理盘。每一层都有"看起来更聪明"的替代品——RAID 卡、ZFS、网络文件系统——而 MinIO 的建议几乎都是否定的。不是保守,是它的数据路径设计只在"直连、本地、简单"的层上成立。
图 4-2 MinIO 与存储层各层的责任划分
XFS 的三个入选理由
在支持矩阵里,XFS 是被明确点名的推荐项,这不是随手勾选:
理由一:大文件吞吐与并发分配的成熟度。 对象存储的日常是"大文件顺序写、多流并发写"。XFS 的分配组(allocation group)设计让并发写入在不同区域并行推进,互不拖拽;延迟分配把小块写聚合成大块写,对旋转盘友好。这些特性在 Linux 生态里被打磨了二十多年,边界行为清楚。
理由二:规模上限宽裕。 单文件系统轻松支持 EB 级的理论上限与千万级文件,分片文件元数据精悍,df、xfs_repair 等运维工具链成熟。相比之下 ext4 在超大文件系统上的历史包袱更多(虽也能跑,但没有理由放着 XFS 不用)。
理由三:行为可预期。 MinIO 需要文件系统回答的问题是纯粹的:"这块空间还有多少、这个文件写进去多快、坏了能不能被盘替掉。"XFS 对这三个问题的回答最不含惊喜。
格式化与挂载的标准姿势:
# 整盘建 XFS,不分区——存储盘上分区表没有意义,只会添乱 mkfs.xfs -f /dev/sdb # 挂载选项:默认即可,noatime 省掉读时的访问时间更新 mkdir -p /data/minio1 mount -o noatime /dev/sdb /data/minio1 # 写入 fstab 用 UUID,盘序漂移时挂载点不变 blkid /dev/sdb echo 'UUID=xxxx-xxxx /data/minio1 xfs defaults,noatime 0 0' >> /etc/fstab
noatime 值得单独一提:对象存储的读流量巨大,每次读取都更新访问时间是纯浪费,关掉它对 HDD 池的读性能有可测的改善。
那些替代方案的雷区
RAID 阵列(RAID 5/6/10):最常被问起的方案。问题不在能不能跑,而在三层错位:其一,RAID 的冗余与纠删码重复,空间白费;其二,RAID 重建要扫全组盘,以天计的重构窗口里性能塌方,而 MinIO 的对象级 heal 只要分钟级;其三,RAID 卡的写缓存引入掉电数据风险,关掉缓存又损失性能。正确姿势是把 RAID 卡切到 HBA 直通模式,让每块盘以独立块设备呈现——现代服务器基本都支持。
ZFS/Btrfs 等特性文件系统:快照、压缩、校验听着都美好,但每一项都与 MinIO 的内建能力重复或冲突。ZFS 的 ARC 缓存会吃掉大量内存、压缩改变容量核算口径、它自己的校验修复与 heal 抢活。这些"分布式文件系统级"的聪明,MinIO 已经在更高层做完了。
NFS/SMB 等网络文件系统:曾经有网关模式支持,现已明确废弃。网络文件系统把延迟、锁语义和可用性问题引入数据路径,纠删集成员若分布在 NFS 上,一致性保证直接失守。对象存储的盘必须在本机。
云盘/虚拟盘:技术上可行(K8s 部署场景常见),但要选本地 NVMe 类或高 IOPS 的块存储,并且明白你把故障域从"本机磁盘"换成了"云厂商的存储服务",4.3 与第 8 章的容量与监控口径要相应调整。
元数据住在哪里:内联设计的地基依赖
MinIO 没有独立的元数据库——对象的键、版本、分片位置、校验值全部写在分片所在目录的元数据文件里,与数据同盘同纠删集(xl.meta 内联格式)。这个设计省掉了一个经典的分布式瓶颈(元数据服务器),也带来对本地文件系统的硬依赖:元数据的原子性与 durable 语义由文件系统的 rename 与 fsync 提供。把它放到网络文件系统上,等于让这套精密的原子语义跑在高延迟、弱保证的地基上——这就是 NFS 被除名的深层原因。
⚠️ 常见坑:把数据目录建在系统盘的 LVM 卷上"先凑合跑"。系统盘通常有分区表、有 LVM 抽象、有和日志共存的 IO 竞争,等数据涨起来再迁移就麻烦了。生产部署从第一块盘起就按 2.2 的目录纪律挂专用盘。
本节要点回顾
- 直连、本地、简单是三层底线:HBA 直通、每盘一挂载点、XFS 文件系统,每层的"聪明"都交给 MinIO 上层去做。
- XFS 入选靠成熟而非新奇:分配组并发、规模上限、工具链,三条都指向"可预期"。
- RAID 与纠删码是重复建设:直通模式释放盘位,对象级 heal 取代全组重建。
- 元数据内联决定了地基依赖:xl.meta 的原子语义长在本地文件系统上,这是 NFS 被废弃的根因。
地基夯实,下一节把 4.1 的池模型和本节的盘位纪律合起来,完整复盘一次在线扩容。
上线前的存储层核对清单
4.2 的所有建议折叠成一张验收表。新节点上架、扩容到货、迁移重建,三种场景都用同一张表逐项打勾:
| 核对项 | 合格标准 | 不合格的典型代价 |
|---|---|---|
| 阵列卡模式 | HBA 直通,每盘独立块设备 | RAID 冗余浪费空间,重建拖垮性能 |
| 文件系统 | 每盘独立 XFS,不分区 | 逻辑卷抽象让盘位编排失真 |
| 挂载选项 | noatime,UUID 写入 fstab | 读流量白白更新 atime,重启丢挂载 |
| 盘位一致性 | 每节点盘数一致,目录名规整 | 纠删集打散倾斜,故障域失衡 |
| 系统盘分离 | 数据绝不落在系统盘 | 数据与日志抢 IO,重装系统即灾难 |
| 固件批次 | 同批次盘分散在不同纠删集 | 同批次固件缺陷一坏坏一片 |
| SMART 基线 | 上线前全盘体检留档 | 带病盘入列,首月告警不断 |
| 时间同步 | 全节点 NTP 就绪 | 分布式操作的时间语义失真 |
这张表的价值在于把"经验"变成"条目":Storage 团队的新人拿到表,就能完成与老工程师同等质量的核对。表的存在也改变了责任的形状——哪一项没勾清楚,故障复盘时责任归属一目了然。