8.2 监控告警与容量水位
8.2 监控告警与容量水位
本节摘要:MinIO 原生输出 Prometheus 指标,监控链路的重点不在采集,而在"告警什么、什么阈值、告了之后做什么"。本节给出三类必告警(盘健康、纠删集水位、复制积压)的指标与阈值口径,以及一条告警设计的铁律:每条告警必须自带动作。
从"有监控"到"能睡觉"
接手集群的第一个月,值班表是这么排的:每人一晚,登录控制台看一圈盘和容量。这套"人肉巡检"在第二次有人看漏一块掉线盘后终于被推翻。监控的成熟度分三档:能看到(有图表)、能知道(有告警)、能睡着(告警可信且可执行)。本节的目标是第三档——而它的门槛不在工具,在告警清单的设计。
采集:两分钟的事
MinIO 内置 Prometheus 抓取端点,一条命令生成带鉴权的采集配置:
# 生成 Prometheus 抓取配置(含 bearer token) mc admin prometheus generate fleet # 把输出粘进 Prometheus 的 scrape_configs 即可 # Grafana 官方面板导入后即得容量、吞吐、健康三大视图
采集本身没有悬念,值得花心思的是下面这张告警清单。
必告警清单:三类风险,六个指标
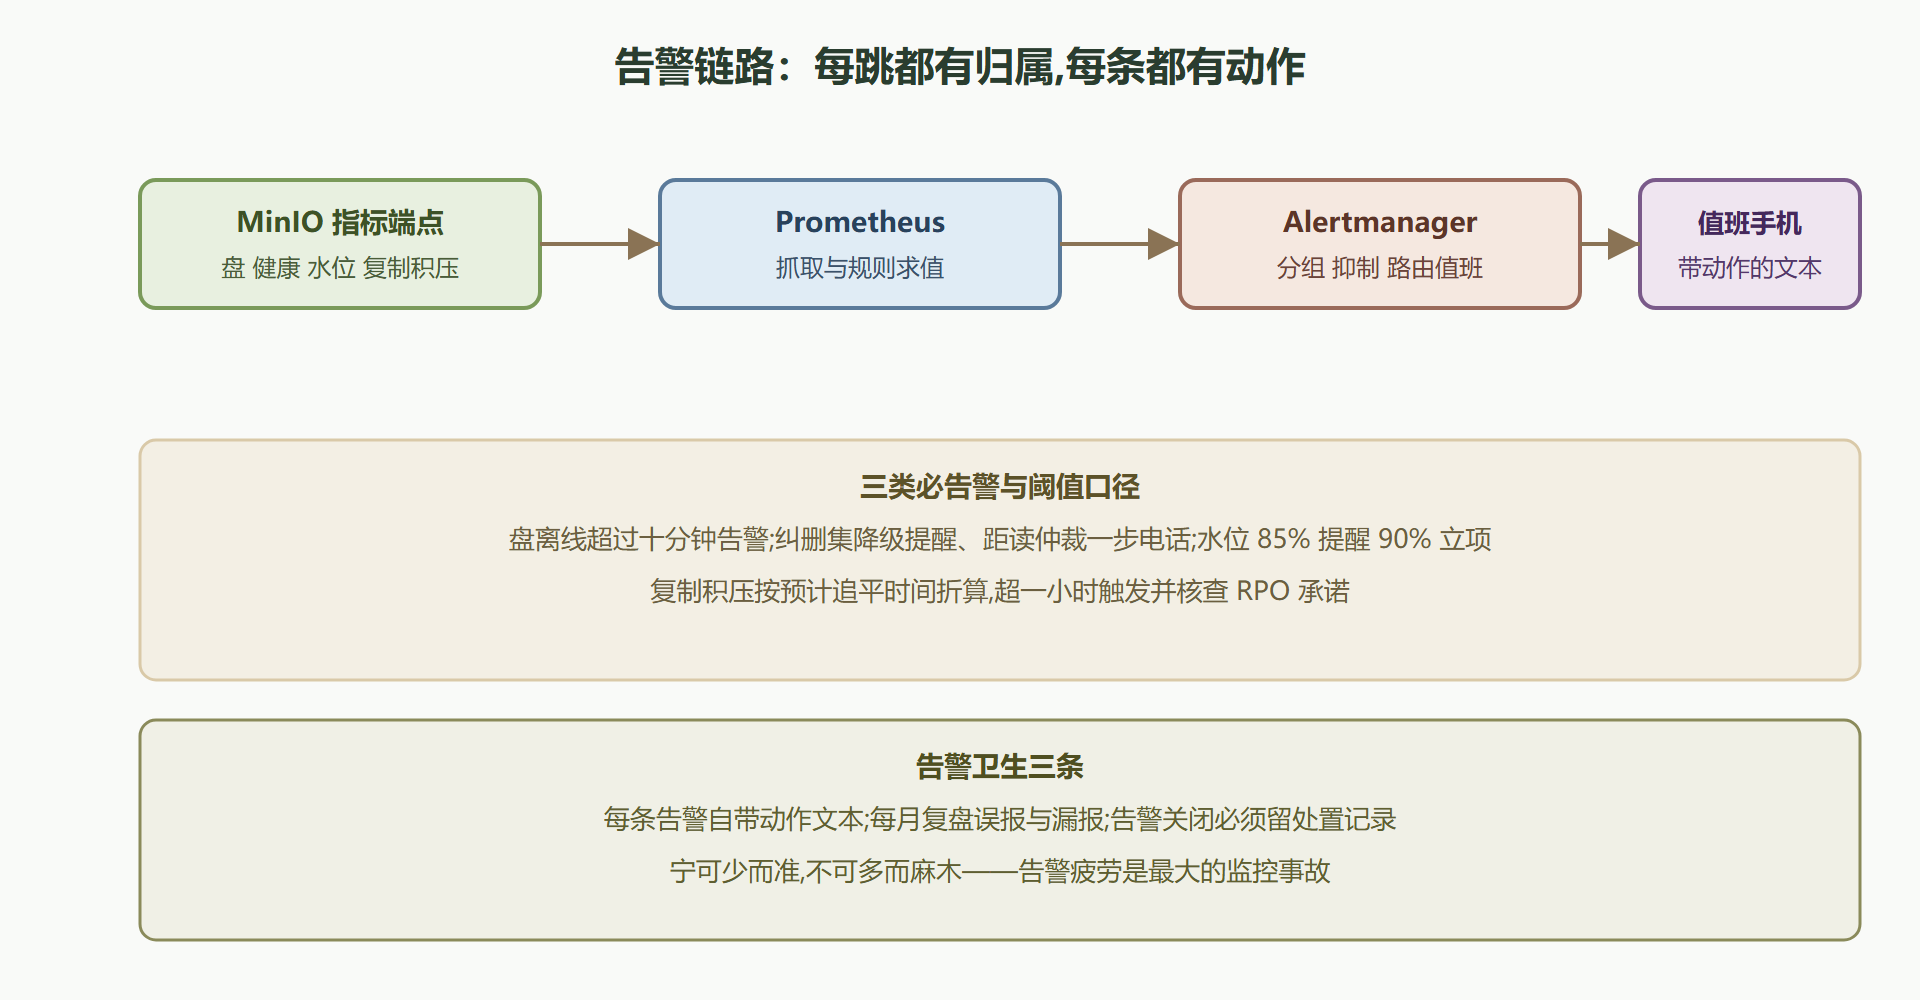
第一类:盘与节点健康。 对应指标是离线盘数与离线节点数。阈值零容忍:任何一块盘离线超过十分钟就该有人知道。3.2 讲过,单盘离线集群尚能自愈,但健康水位正在消耗——告警的意义是把"消耗"变成"可见"。
第二类:纠删集健康水位。 对应指标是各纠删集的可用分片数(或等价的降级集数量)。这是全册反复强调的头号指标(3.1、3.2),阈值分两档:降到"低于满编但可自愈"触发提醒,降到"距离读仲裁只剩一步"触发电话。后一档意味着再坏一块盘就是数据事故,夜里有电话是对的。
第三类:容量与复制积压。 容量水位按池分桶统计(4.3 的教训:总量达标而单池触顶是常见伪象),两级阈值建议 85% 提醒、90% 行动——行动指启动扩容立项,而不是删除数据。复制积压(5.4)的阈值用积压字节数除以同步速率折算成"预计追平时间",超过一小时触发,因为它直接决定容灾的 RPO 承诺。
# Prometheus 告警规则示例(节选) groups: - name: minio-health rules: - alert: MinioDriveOffline expr: minio_cluster_drive_offline_total > 0 for: 10m labels: severity: warning annotations: summary: "有盘离线,健康水位在消耗" action: "核对该盘 S.M.A.R.T. 与日志,预约换盘窗口" - alert: MinioPoolHighWater expr: minio_cluster_capacity_usable_free_bytes / minio_cluster_capacity_usable_total_bytes < 0.15 for: 1h labels: severity: critical annotations: action: "启动扩容立项,按 4.3 流程新建同规格池"
注意每条告警注释里的 action 字段——这不是装饰。告警设计铁律:收到告警的人必须能从告警文本里知道第一步做什么。 "容量偏高"不是告警,"可用低于 15%,启动 4.3 号剧本"才是告警。
图 8-2 从指标到值班的告警链路
案例一次告警清单的瘦身
背景:初版告警清单照搬了社区模板的四十多条规则,上线首月触发一百多次,其中九成是"扫描延迟抖动""单节点瞬时高负载"这类无需行动的噪音。值班群开始出现"告狼来了"式免疫。
操作:团队做了一次告警审计——把每条规则过一遍三问:它要求人做什么动作?不做会怎样?过去一个月它抓到过真问题吗?四十多条砍到九条:三类必告警加上证书到期、审计通道中断、备份任务失败。砍掉的规则并没有删除,而是降级为仪表盘上的图表,可见但不吵。
结果:次月告警量降到个位数,全部有行动、有闭环;一块提前老化的盘在离线前十天就被 S.M.A.R.T. 预警抓到。
解读:监控的敌人不是"指标太少"而是"注意力稀释"。九条告警每条都像火灾警报,四十条告警里藏一条真火警没人找得到。瘦身后的清单把值班注意力还给真正的风险。
变式:多集群环境把"集群维度的告警"再聚合一层——全局视图只报跨集群的共性问题(同一批次盘集体预警、所有池水位同步爬升),单集群细节留给各自的视图。层级化的告警才是规模化运维的形态。
本节要点回顾
- 成熟度看告警不看图表:能看到、能知道、能睡着,三档的分界在告警质量。
- 三类必告警:盘离线零容忍、纠删集水位两档制、容量与积压按行动阈值。
- 告警自带动作:收到告警的人能从文本里读出第一步,否则它只是噪音。
- 定期瘦身:告警审计三问砍掉无动作规则,注意力是监控体系最稀缺的资源。
平时有人喊疼了,还差最后一课:真出事时的剧本。下一节把断电演练办到底。
面板的三层组织法
告警清单解决"什么时候叫人",面板解决"叫来之后往哪看"。组织面板按三层展开:全局层放跨集群的对比视图(各集群水位并列、总容量趋势、按业务域的用量分布),回答"整体健康吗";集群层放单集群的详情(池水位、纠删集健康分布、请求速率与错误率、复制积压),回答"这个集群怎么了";盘层放节点与盘的明细(每盘延迟、错误计数、SMART 摘要),回答"具体是哪块盘"。三层各一张看板,层层下钻,值班时不需要在几十张图表间迷路。
监控的两个疑问
指标多久抓一次合适?
默认十五秒对告警场景足够;容量趋势这类慢变量可以用记录规则降采样到分钟级,长期存储的负担大幅下降。注意不要为了"更精确"把抓取间隔压到秒级——指标端点的压力与存储的时序量都会翻倍,换来的告警灵敏度提升几乎感知不到。
容量预测要另外建模型吗?
先把线性外推做扎实——按历史斜率外推触顶日期,已经能覆盖八成的扩容立项需求,用记录规则加一条增长速率曲线即可实现。业务形态突变(新接入大客户、迁移潮)时人工修正外推参数。复杂的预测模型在存储容量这个尺度上收益有限,斜率与水位两个数字,就是容量管理的全部核心。
监控体系的最终形态是"三层看板、九条告警、一条外推曲线"——足够薄,薄到值班工程师愿意看;足够准,准到每次响铃都值得拿起手机。做到这一步,8.2 开头那个"人肉巡检"的值班表就永远翻篇了。