8.3 灾难恢复演练与集群迁移
8.3 灾难恢复演练与集群迁移
本节摘要:灾备能力的唯一验收方式是演练。本节给出"备份策略、切换剧本、演练执行、结果反哺"四段式方法,并完整复盘一次双机房断电切换演练:从演练前两周的准备清单到恢复后的复盘会议,RTO 与 RPO 如何从纸面数字变成实测数据。
纸面容灾与真实容灾的距离
每个团队都能写出一份漂亮的灾备方案:双机房、站点复制、分钟级切换。纸面与真实的距离在三个地方:切换步骤有没有人完整走过一遍、副本站点的容量与带宽在"真承接全部业务"时够不够、切换期间应用侧的配置(连接串、凭证、DNS)是否同步就绪。这三点只有演练能验证。演练不是仪式,是把故障提前发生一次——代价可控的故障发生在演练日,总好过不可控的故障发生在某个凌晨。
备份策略:演练的地基
演练切换的前提是备站点有数据可接。5.4 的站点复制是主路径,但完整的备份策略是三条腿:
腿一:站点复制做热备。近实时同步,承接"机房级故障"场景,RPO 以秒到分钟计。
腿二:定期镜像做温备。对关键桶周期性执行 mc mirror 到独立的备份集群(或对接企业备份软件的目标端——主流备份产品对 S3 兼容目标的对接即此模式)。它覆盖"误操作批量删除后被同步到备站"的场景——站点复制会把删除也同步过去,独立镜像不会。
腿三:对象锁定做防误删底座。5.3 的 WORM 语义保证备份对象在保留期内物理不可删,这是"备份系统本身被误操作"的最后一道防线。
三条腿分别对应不同的故障谱系:机房断电、逻辑污染、人为误删。缺任何一条,演练里都会露出对应的裸区。
切换剧本:写清楚每一步谁来做
演练剧本的本质是"把所有临场决策提前做完"。以双机房切换为例,剧本骨架:
- 判定与授权(值班工程师 + 值班经理):确认主站故障等级,宣布切换,记录时间戳——这一刻即 RTO 计时起点。
- 应用切流:把 DNS 或负载均衡的指向切到备站,应用侧的存储连接配置若走配置中心则同步下发。
- 备站承接验证:读写探活、错误率观察、关键业务抽测——备站"能连上"与"能扛业务"之间隔着容量与并发,演练就是量这个的。
- 回切或固化:主站恢复后,数据反向补同步,再择机回切;或直接以备站为新主站运行。
每一步标注执行人、预计耗时、回退条件。剧本写完先做"桌面推演"(所有人对着文档走一遍嘴),再做真机演练。
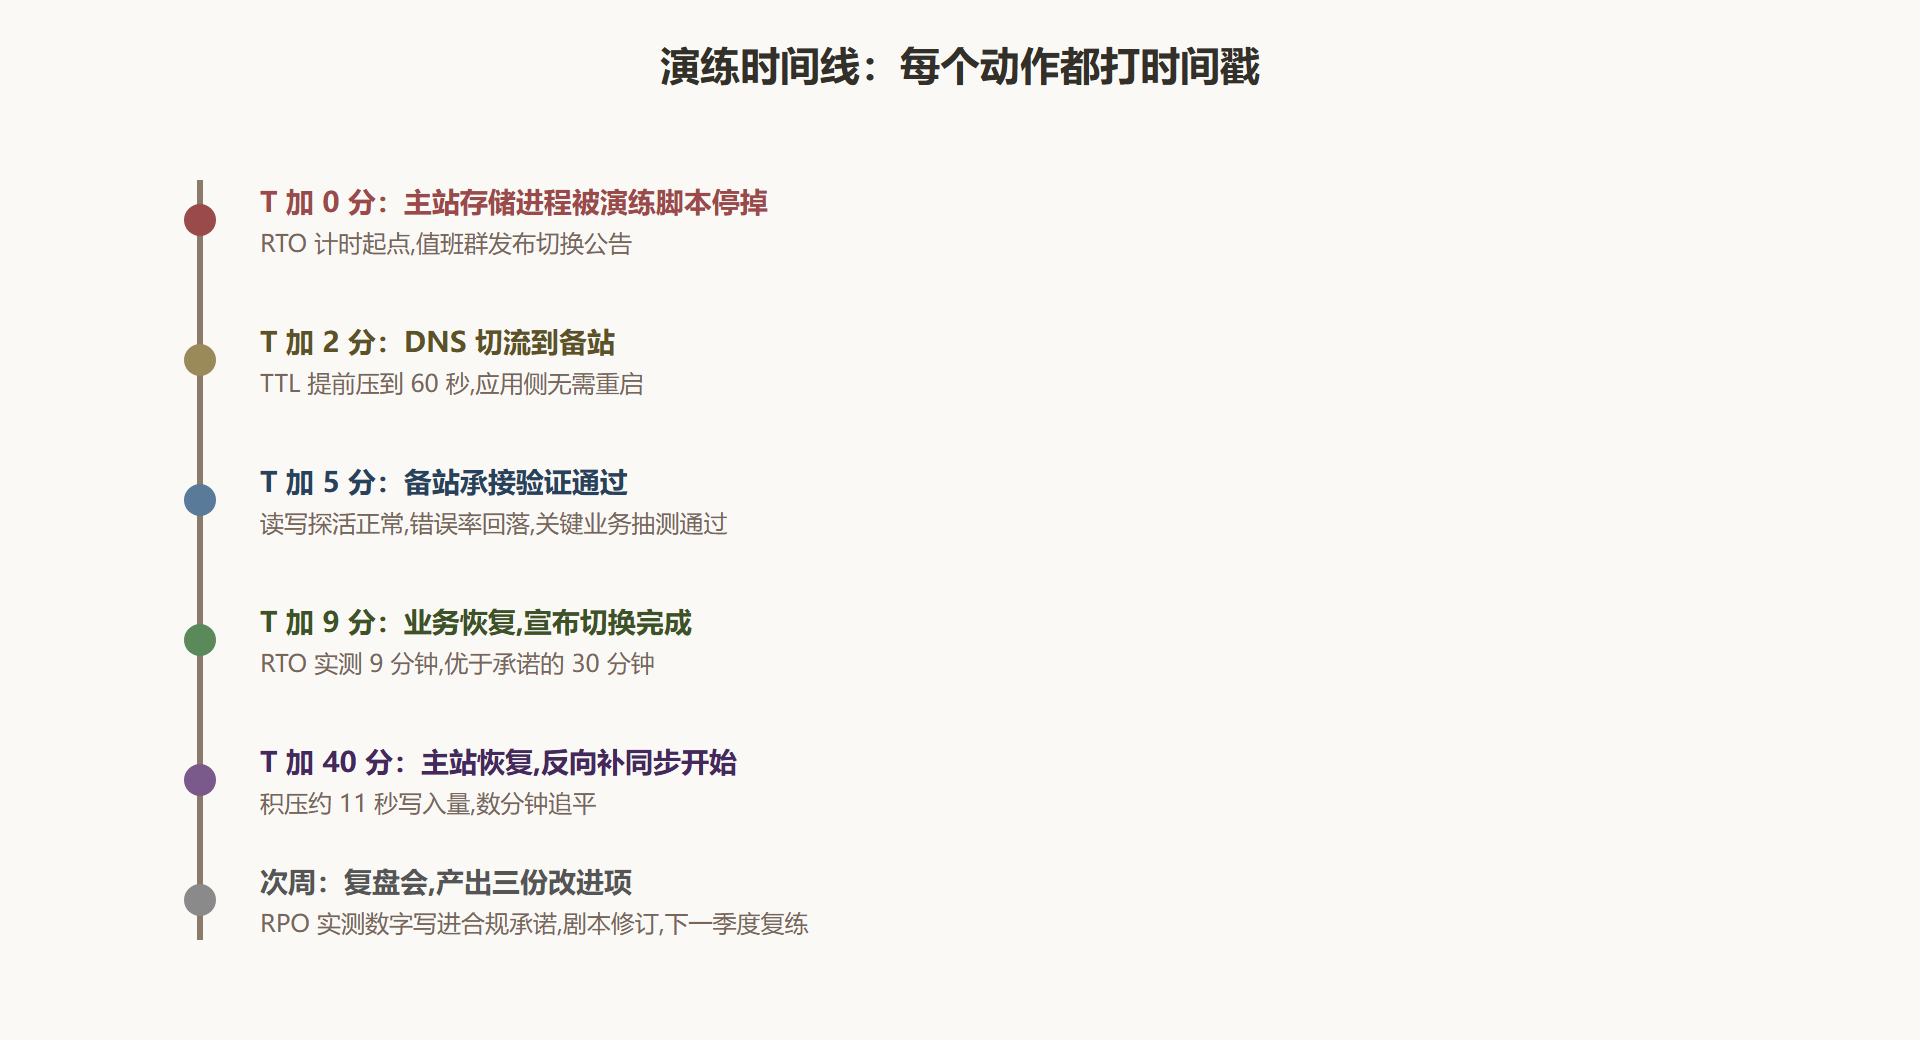
图 8-3 一次断电切换演练的时间线
案例复盘:9 分钟与 11 秒的含金量
背景:5.4 搭建的双机房集群,合规承诺 RTO 30 分钟、RPO 5 分钟,首次真机演练。
操作:演练前两周的准备清单逐项打勾:备站容量余量复核(承接全量业务的容量富余)、复制带宽压测(确认峰值写入不积压)、剧本桌面推演、监控告警在备站视角可用、回退步骤明确。演练当天按图执行,全程录屏与时间戳留档。
结果:RTO 实测 9 分钟,RPO 实测约 11 秒的写入量(同步延迟窗口),双双达标。复盘会产出三项改进:切流脚本手工步骤过多,自动化成一键工具;备站的监控视图缺业务错误率面板,补齐;演练频率从半年一次提到季度一次。
解读:这次演练最值钱的产出不是达标本身,而是把三个纸面盲区变成了改进项。尤其 RPO 的 11 秒——它不是"复制是异步的"这句话,而是一个可以写进对客承诺、可以用下一季度演练复验的数字。
变式:集群迁移(如 8.1 的上云迁移)可以视作一次"计划内切换",剧本骨架相同:双跑、切流、验证、退役,只是节奏从容得多。迁移与演练共用一套剧本,也是让团队保持肌肉记忆的巧妙安排。
本节要点回顾
- 演练是唯一验收:纸面容灾与真实容灾的差距,只有真断电能量出来。
- 备份三条腿:站点复制抗机房故障、独立镜像抗逻辑污染、对象锁定抗人为误删。
- 剧本消灭临场决策:每步有执行人、预计耗时、回退条件,先桌面推演再真机。
- 复盘反哺架构:RTO 与 RPO 要实测成数字,改进项要进下一轮演练的验收项。
剧本、监控、演练都齐了,最后把门槛放低:让业务团队顺手把数据接进来。下一节是面向开发者的收尾。
演练剧本骨架表
8.3 的剧本骨架压成一张表,写剧本时直接往里填血肉:
| 阶段 | 动作 | 执行人 | 预计耗时 | 回退条件 |
|---|---|---|---|---|
| 判定授权 | 确认故障等级,宣布切换 | 值班经理 | 2 分 | 误判即撤令 |
| 切流 | DNS 或负载均衡指向备站 | 值班工程师 | 3 分 | 备站探活失败即停 |
| 承接验证 | 读写探活、错误率、业务抽测 | 应用值班 | 4 分 | 错误率超标即回切 |
| 宣布完成 | 记录 RTO,通报业务方 | 值班经理 | 1 分 | — |
| 恢复收尾 | 主站修复后反向补同步 | 存储工程师 | 视积压 | — |
演练的两个常见顾虑
演练本身会不会弄丢数据?
设计正确的演练不会。切换在备站侧承接,主站侧只做"停进程"级别的模拟故障,数据卷原样保留;即便演练中途出意外,主站进程拉起即回到演练前状态。真正的风险不在数据,在"剧本没写全就硬上"——所以桌面推演是硬前置。
演练频率多高才算够?
季度是经验上的平衡点:频率足以让剧本与人员保持新鲜,又不至于把演练变成日常噪音。此外每次基础设施变更(大版本升级、机房迁移、复制拓扑调整)之后,应追加一次针对性演练。演练的敌人不是时间,是"上次没问题"带来的松懈——剧本是活的文档,演练是它的心跳。
把 8.3 收进全册的语境里:第 5 章建了复制,本节让复制通过实战考试。一个集群的成熟度,从来不是看它功能开了多少,而是看它敢于演练什么。
演练报告的标准样
演练的交付物是报告,一份合格的演练报告只需回答六个问题:演练时间与触发方式(计划内还是突袭);切换各步骤的实际耗时与预计耗时的对比;RTO 与 RPO 的实测值;演练中发现的异常清单(哪怕是小到"面板上备站视角缺一个图"级别的问题);对应的改进项与责任人;下一次演练的时间与验收项。报告写完发给业务方与合规方各一份——8.3 案例里那句"实测 RPO 为 11 秒"能写进合规承诺,靠的就是这份报告的存在。
突袭式演练值得单独推荐:不预告具体时间(但提前公告演练季与范围),由值班经理择日触发剧本。计划内演练考的是剧本,突袭演练考的是人——后者才能暴露"值班工程师其实从没独立走过一遍切换"这类最危险的真相。当然,突袭的前提是计划内演练已经把基础动作练熟,两者是递进关系而不是替代关系。把演练办成组织的常规动作,灾难来临时它就只是又一次演练而已。