5.2 性能监控与诊断
5.2 性能监控与诊断
本节摘要:Ollama 自带的耗时统计字段已经够做一次完整的性能解剖——把端到端延迟拆成排队、加载、预填充、解码四段,分别定位到不同的资源瓶颈。本节给出标准测量方法、四个典型病症的判读表,以及一套可持续的监控脚本方案。
一次请求的耗时都花在哪
API 的最终响应(或 CLI 的 --verbose 输出)携带全部原始数据:total_duration 总耗时、load_duration 模型加载耗时、prompt_eval_count/prompt_eval_duration 预填充的 token 数与耗时、eval_count/eval_duration 生成的 token 数与耗时。换算成三个核心指标:
- 首字延迟 ≈ 排队 + 加载(若有)+ 预填充总耗时;
- 生成速度 = eval_count ÷ eval_duration × 10⁹(tokens/s);
- 预填充速度 = prompt_eval_count ÷ prompt_eval_duration × 10⁹。
# CLI 一行拿到全部数字 ollama run qwen2.5:7b --verbose "用100字介绍 epoll" # API 方式(非流式响应尾部带同样字段) curl -s http://localhost:11434/api/generate -d '{ "model": "qwen2.5:7b", "prompt": "用100字介绍 epoll", "stream": false }' | python -c "import json,sys; d=json.load(sys.stdin); \ print('total(s):', d['total_duration']/1e9); \ print('decode t/s:', d['eval_count']/(d['eval_duration']/1e9)); \ print('prefill t/s:', d['prompt_eval_count']/(d['prompt_eval_duration']/1e9))"
三个指标各对应一种硬件:预填充速度低是算力不足;生成速度低是带宽不足;首字延迟大但两者不低,问题在排队或加载。
病症判读:四种典型慢法
病症一:首条请求慢十几秒,之后秒回。 看 load_duration 占了大头——模型不在驻留状态。这不是性能问题而是驻留策略问题,调 OLLAMA_KEEP_ALIVE 或请求级 keep_alive: -1 即解决(见 5.3)。
病症二:生成速度远低于该硬件的理论值。 先查 ollama ps:SIZE_VRAM 明显小于 SIZE 说明有层落在内存,GPU 在等 PCIe 喂数据。对策是降量化档位、缩小 num_ctx,或手动调 num_gpu 层数,让"装得下的层数"全进显存。CPU 跑同一模型速度砍到几分之一属于物理规律,先确认没有误走 CPU 路径:
# 日志里找 offload 层数:offloaded 28/28 layers to GPU 才是全入 journalctl -u ollama | grep -i offload
病症三:对话越聊越慢。 上下文在涨,每轮都重算全部历史,KV 缓存膨胀也挤压带宽。判读方法是多轮请求后观察 prompt_eval_count 是否逐轮累加。对策:无关话题前 /clear(CLI)或裁剪 messages 历史(API),长会话考虑摘要压缩上下文。
病症四:并发一上来延迟陡增。 同一模型的解码在 server 内是串行的,第 N 个请求要等前面排完。看并发时的 total_duration 与 eval_duration 的差值即排队时间。对策不是加内存,而是多实例分流(7.3 节)或用队列削峰。
系统侧观测:与 Ollama 数字互相印证
Ollama 的字段只讲自己,系统工具讲环境。GPU 侧盯两项:显存占用(是否顶到上限触发层溢出)与 SM 利用率(解码期低于 90% 多半在等带宽或被别的进程抢占):
watch -n1 nvidia-smi --query-gpu=memory.used,utilization.gpu,power.draw --format=csv # 找出抢占显存的其他进程 nvidia-smi --query-compute-apps=pid,name,used_memory --format=csv
CPU/内存侧,htop 看 ollama 进程的内存 RSS 是否随会话增长(KV 缓存),iostat/任务管理器看加载期磁盘是否成为瓶颈(机械盘上首次加载大模型明显更慢,换 NVMe 或预拉取可解)。
搭一个可持续的巡检脚本
一次性手测之外,建议把测量固化成脚本,服务化部署后定时采样入库。最小可用版本:
import time, requests, statistics TARGETS = [("qwen2.5:7b", 256)] def probe(model, prompt_len): t0 = time.time() r = requests.post("http://localhost:11434/api/generate", json={ "model": model, "prompt": "数 " * prompt_len + "\n请把上面的内容原样复述一遍。", "stream": False, "options": {"num_predict": 32}, }, timeout=600).json() return { "wall": time.time() - t0, "tps": r["eval_count"] / (r["eval_duration"] / 1e9), "prefill_tps": r["prompt_eval_count"] / (r["prompt_eval_duration"] / 1e9), } if __name__ == "__main__": for m, n in TARGETS: samples = [probe(m, n) for _ in range(3)] tps = [s["tps"] for s in samples] print(m, "median t/s:", round(statistics.median(tps), 1), "prefill t/s:", round(statistics.median(s["prefill_tps"] for s in samples), 1))
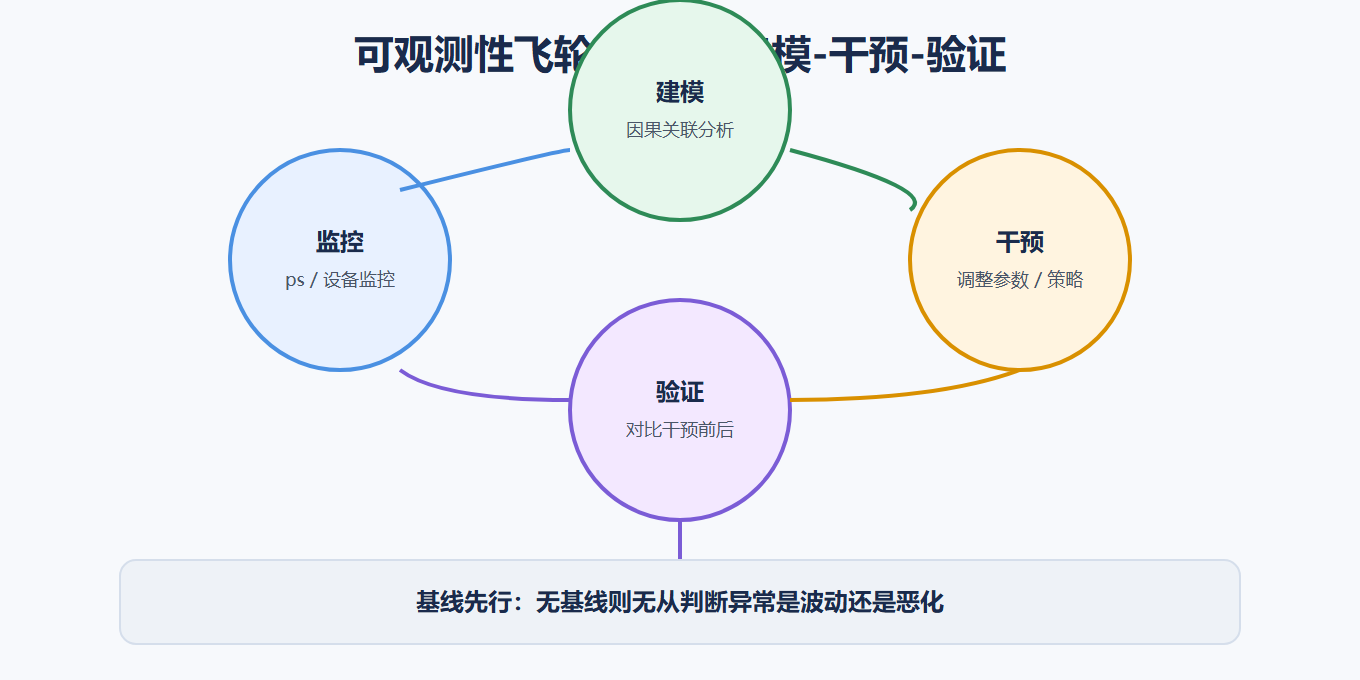
三个要点让数据可信:预热一次再采样(排除加载期);每次探测固定 prompt 与参数(否则不可比);多采几次取中位数(系统抖动无处不在)。拿到稳定的基线后,任何"感觉变慢了"都能回到数字上验证。
诊断清楚瓶颈归属之后,下一节的进阶调优才有的放矢——驻留、分层、上下文与批处理的组合拳。