- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读:本地大模型运行工具 Ollama
一句话定位:Ollama 是一个把开源大语言模型"下载即用、一行命令跑起来"的本地运行工具。本教程走动手优先 + 演化历史路线——先让你在 10 分钟内跑起第一个模型,再回头讲清楚它凭什么能做到,以及这个工具在过去两年里是怎么一步步走到今天的。
这个教程解决什么问题
很多人第一次接触大模型,卡住的不是模型本身,而是"怎么把它弄到自己的电脑上跑起来"。装 CUDA、编译量化工具、配 Python 环境、调显存参数——一套组合拳打下来,模型还没见到,热情先没了。Ollama 把这件事压缩成一条命令:装好之后 ollama run llama3.2,回车,就能对话。
但"能跑"只是起点。真实场景里,你会碰到这些问题:模型放在哪个目录、怎么自定义一个带角色设定的模型、怎么把本地模型接进自己的程序、怎么在 8GB 显存的笔记本上流畅运行、怎么给团队开一个安全的远程服务。这些问题散落在官方文档和社区帖子里,本教程把它们按一条主线串起来:从拿到模型,到把它用起来,再到把它部署好。
适合谁读
- 装过或想装 Ollama,但只会
ollama run一条命令的开发者 - 想把本地大模型接进自己的应用、知识库或自动化脚本的工程师
- 需要给团队搭建本地 AI 服务,关心网络、安全和性能的人
- 被各种"三分钟跑通"教程坑过,想系统弄明白原理的初学者
学完你能做什么
- 从零安装 Ollama,用命令行完成模型的下拉、运行、查看、删除
- 用 Modelfile 自定义模型的系统提示、参数、对话模板和 LoRA 适配器
- 通过 REST API 和官方 SDK 把本地模型接进自己的程序
- 根据自己硬件条件选模型、调显存、做基础的性能调优
- 搭建带 RAG 知识库的应用,并串联起简单的 Agent 工作流
- 用 Docker 和反向代理把 Ollama 安全地开放给局域网或团队使用
学习路线
| 阶段 | 核心能力 | 典型产出 |
|---|---|---|
| 第1-2章 | 安装、跑通、理解整体架构 | 10 分钟内跑起第一个本地模型 |
| 第3章 | 模型获取、存储、Modelfile 自定义 | 一个带专属人格的定制模型 |
| 第4章 | CLI 高级用法、REST API、SDK | 一行 Python 调用本地模型的脚本 |
| 第5章 | 硬件评估、监控诊断、调优策略 | 在有限显存下流畅运行的配置 |
| 第6章 | RAG、Agent、多模态 | 一个基于本地模型的知识库问答应用 |
| 第7章 | 网络配置、安全加固、容器部署 | 团队可用的安全远程服务 |
| 第8章 | WebUI、IDE 插件、未来趋势 | 选型清单与演进判断 |
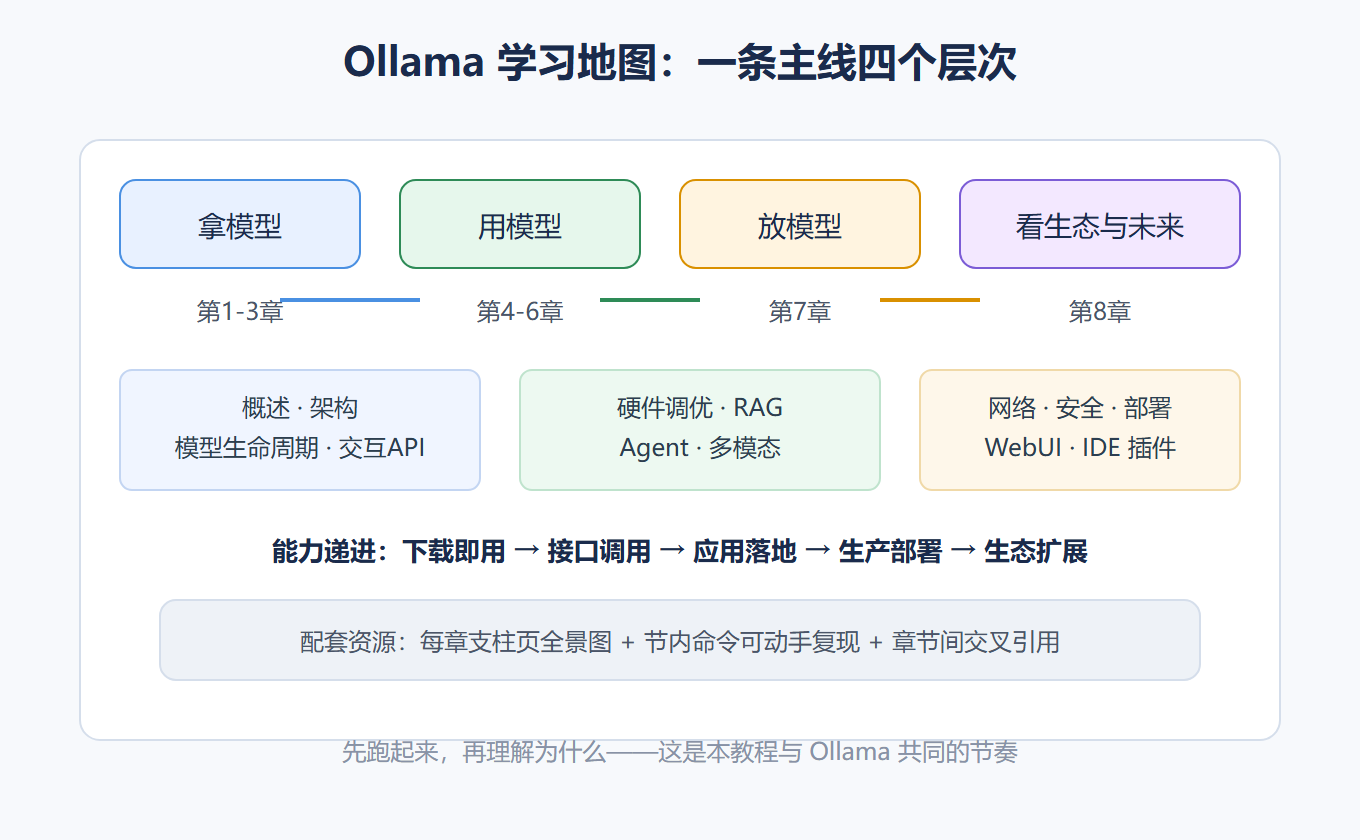
Ollama 的学习地图
怎么用这个教程
每章先读支柱页,用几分钟看清这一章解决什么问题;然后按顺序动手做节里的命令。SOURCE 原文里的 ollama run、ollama create、curl -X POST 这些命令都保留在对应节内,建议边看边在自己的终端敲一遍。第 3、6、7 章的命令会相互依赖,别跳着做。
三条主线怎么串
整本教程可以浓缩成三句话:拿模型(第 1-3 章:装工具、建模型、管模型)、用模型(第 4-6 章:命令行对话、接口调用、应用落地)、放模型(第 7-8 章:网络安全、规模化部署、生态扩展)。如果你时间紧,只想"跑通一个能回答问题的本地模型",走第一条主线就够;如果要做知识库问答或接进现有系统,三条主线都得走一遍。
阅读顺序上,我不建议完全按页码线性读。第 1 章和第 2 章的关系是"先知道它是什么,再知道它凭什么",但如果你想尽快上手,可以读完 1.1 就直接跳到第 3、4 章动手,遇到架构概念再回来翻第 2 章。第 5 章硬件调优不必一次读完,等你发现模型跑得慢再回来查也不迟——它更像一本排查手册而不是必读讲义。
每节花多久
粗略估计:第 1-2 章每节 15-20 分钟(以理解为主,动手为辅);第 3-4 章每节 30 分钟以上(命令多,建议全部敲一遍);第 5-7 章每节 20-30 分钟(涉及本机硬件,需要实际跑监控命令观察输出);第 8 章每节 15 分钟(以选型判断为主)。整体走完一遍,一天到一天半是合理预算。
⚠️ 常见误区:把 Ollama 当普通软件装完就忘。它本质是一个后台服务加一套协议,
ollama serve负责干活,CLI 只是它的前台。后面讲 API 和部署时,这个心智模型会反复用到。
💡 关键直觉:Ollama 的核心思路是"模型即文件、推理即服务"。模型不再是一个需要手动配置的权重文件,而是一个封装好的、可校验的包;推理能力则通过一个本地 HTTP 服务暴露出来。抓住这两点,整本教程的主线就通了。
前置知识
- 能打开终端,执行简单命令行操作(安装软件、运行命令)
- 有一点 HTTP 和 JSON 的基础更好,但第 4 章之前不强求
- 有 Python 基础的话,第 4、6 章会学得更顺
没有 GPU 能学吗
完全能。整本教程只有第 5 章和第 7 章涉及 GPU 的讨论,而即使没有独立显卡,纯 CPU 也能跑小模型(比如 3B 以下的量化版本),体验慢一点但流程完全一样。第 1-4 章的所有命令不依赖 GPU;第 5 章你依然可以学"怎么判断自己该买什么硬件"以及"纯 CPU 下怎么把推理调到最快";第 6 章的 RAG 与 Agent 跟硬件关系不大,用小模型也能跑通演示。所以:有 GPU 学得更深,没 GPU 不妨碍学完整本。
需要准备什么环境
建议准备一台装了 Ollama 的机器,操作系统不限(macOS、Linux、Windows 都支持)。磁盘预留至少 10GB 用于下载两三个模型;内存 8GB 以上跑小模型比较舒服。第 4 章开始会用到 curl 或 Python,按自己的平台装好即可。所有概念性命令都会在正文里给出,不需要额外查资料。
章节概览
- Ollama 概述 — 它是谁、解决什么问题,以及从 2023 年至今的演进脉络
- 核心架构 — CLI 与服务进程如何分工、GGUF 格式、跨平台支持原理
- 模型生命周期 — 模型怎么来、存在哪、如何用 Modelfile 自定义
- 交互 API 与开发 — CLI 高级用法、REST API 细节、官方 SDK 与多语言支持
- 硬件与性能调优 — 硬件需求评估、性能监控诊断、进阶调优策略
- 高级应用场景 — RAG 知识库、Agent 工作流、多模态模型
- 安全网络与生产部署 — 网络配置、安全考量、容器化与集群部署
- 生态与未来 — WebUI 与 IDE 插件、未来演进与边缘 AI 定位
目录大纲
最新文档
知识宇宙
正在加载知识图谱...