6.1 AZDO:逼近零驱动开销
6.1 AZDO:逼近零驱动开销
本节摘要:AZDO 不是单个 API,而是一组共同把 CPU 端驱动开销逼近零的技术组合:实例化渲染把重复物体压成一次调用,间接绘制把绘制参数搬进 GPU 缓冲实现 GPU 驱动渲染,配合 GPU 侧剔除形成完整闭环。本节先解剖一次绘制调用的隐形成本清单,再逐件拆解两件主武器的机制与适用边界,最后给出「合并优先、实例化次之、间接绘制压轴」的选型阶梯。这是性能优化的方法论核心节。
先算一笔管理费
普通思路里「画一个物体」等于「发一次绘制调用」,直觉上这是一条近乎免费的指令。实际账单远不止:驱动要校验当前状态组合是否合法(着色器与 VAO 布局匹配吗、纹理都绑了吗)、把抽象命令翻译成 GPU 硬件命令、维护缓存与同步。每次调用的管理费约几十微秒——单看便宜,乘上规模就可怕:一帧五千次调用 × 每次三十微秒 = 一百五十毫秒,帧率直接掉到个位数,而 GPU 本身可能根本没吃饱。这是「CPU 限制型」瓶颈的典型成因:提交端排队的时间超过了执行端干活的时间。
把账算得更细一层,管理费里最贵的三笔值得单独点名。状态校验:每次绘制前驱动核对「当前程序 + 当前 VAO 布局 + 当前纹理绑定」的组合一致性,绑定越杂校验越长——这就是材质排序(第 7 章)省钱的微观机理。命令翻译:抽象的绘制调用要变成特定 GPU 的硬件指令序列,指令缓冲的格式因厂商而异。同步维护:驱动要在「尽快返回」与「不写坏 GPU 正在读的数据」之间打点,第七章诊断里会看到它的影子。三笔合起来是「每次调用几十微秒」的构成——而合并缓冲、实例化、间接绘制分别在「调用次数」这个维度上把乘数砍下来。
病理的迷惑性在于症状:帧率低,直觉怪 GPU 慢,跑去优化着色器(减少光照计算、换更小的纹理)毫无起色——因为瓶颈根本不在 GPU。判断的第一信号:把绘制调用数砍半(哪怕简单地把一半物体藏起来),帧率几乎翻倍——瓶颈在哪立刻现形。第 7 章会用计时器定量确认,本节先记住这个廉价的定性试验。
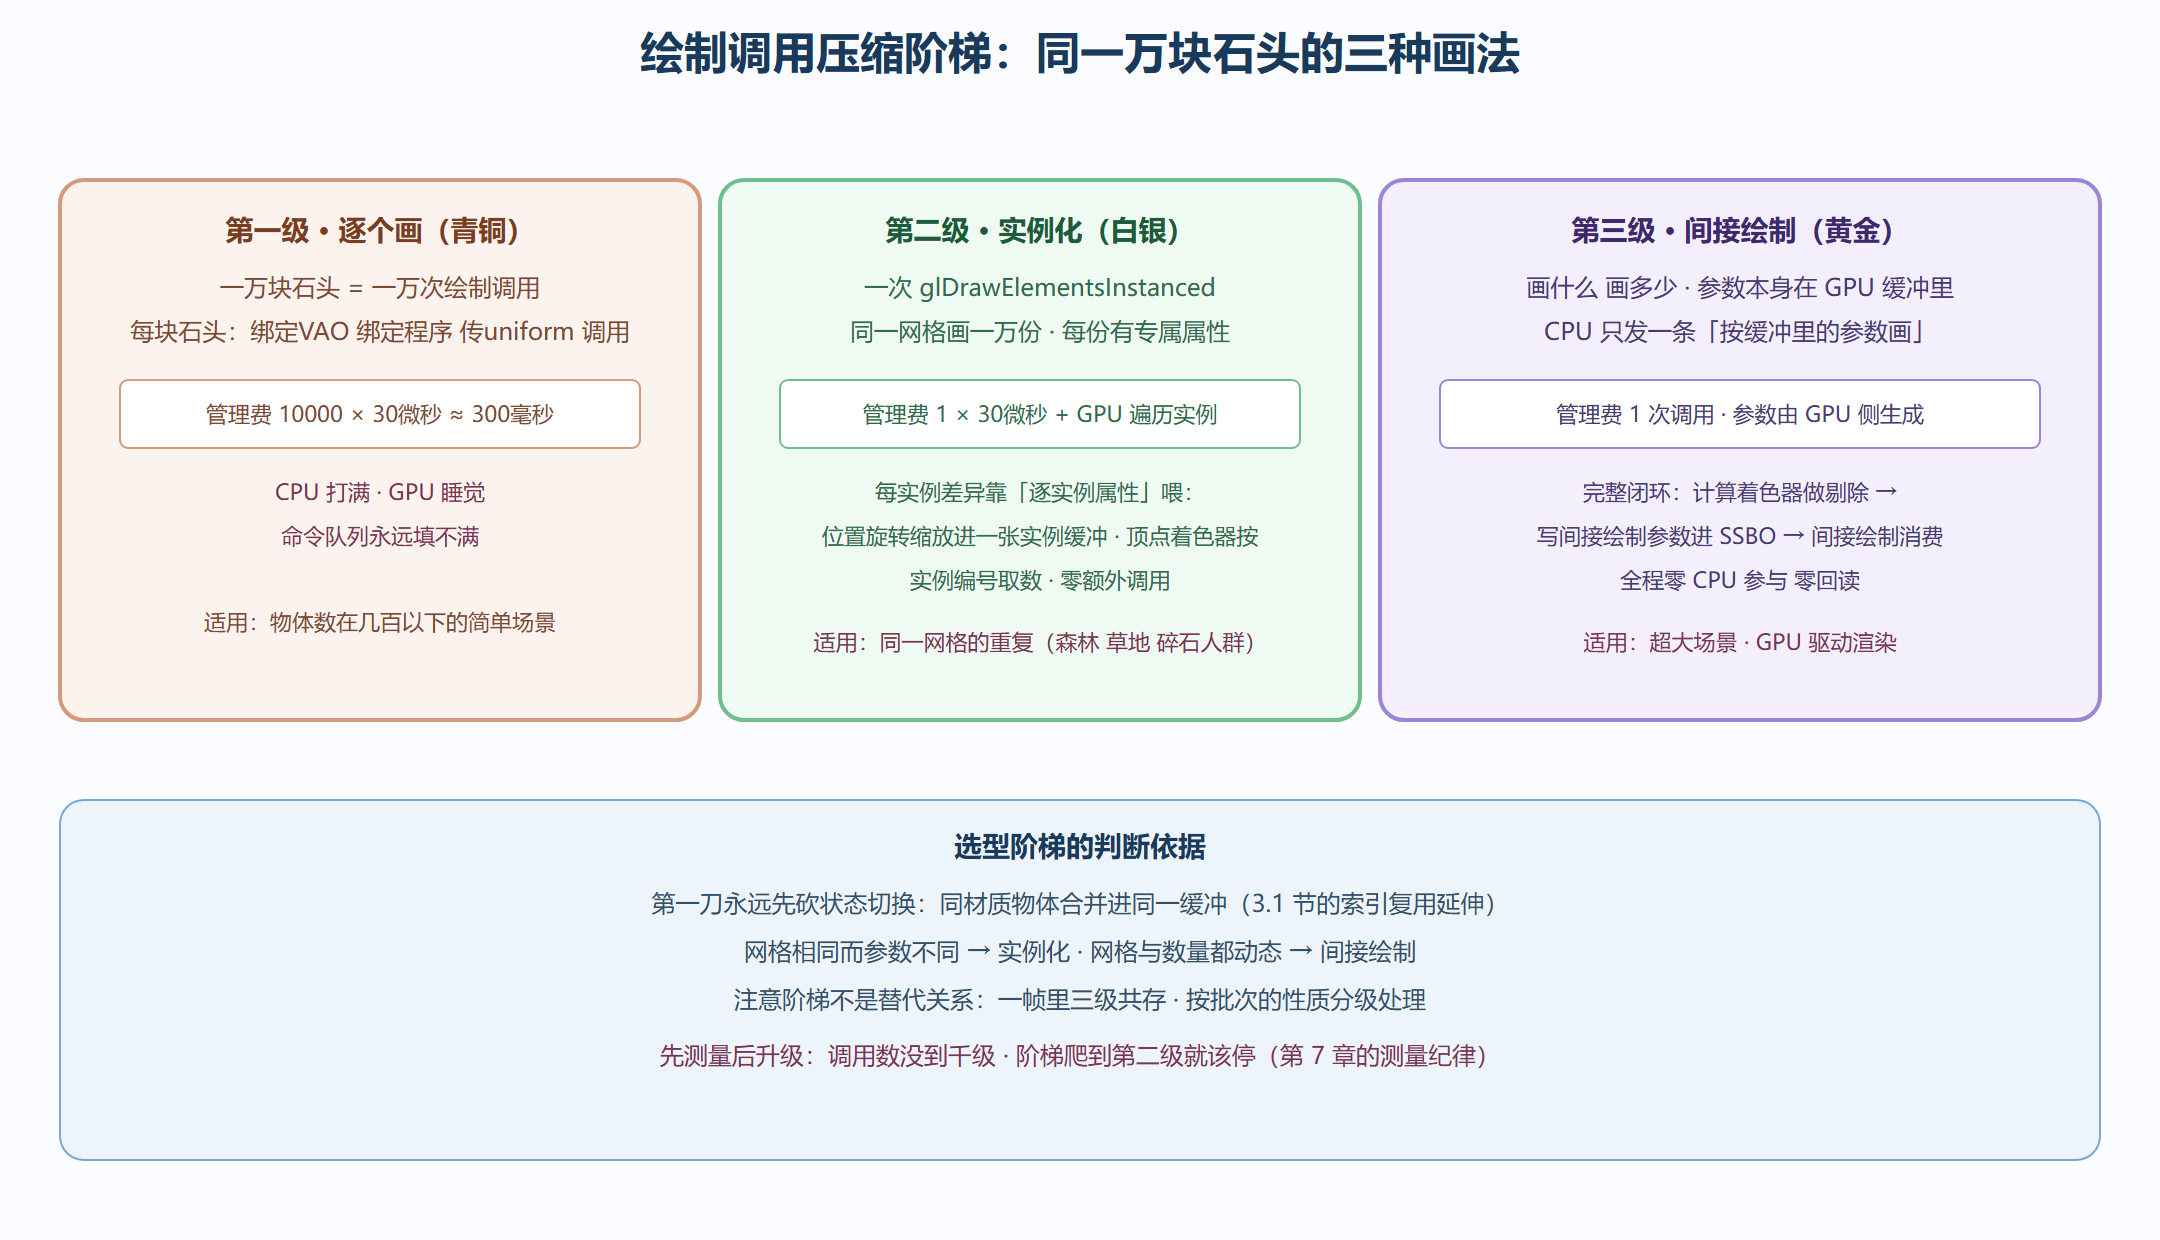
图 6-1 调用数压缩的三级阶梯:从逐个画到 GPU 自主画
实例化:把循环搬进 GPU
机制本身三件套。第一件,绘制调用换成 glDrawElementsInstanced,多一个「实例数」参数。第二件,顶点着色器里解锁内置变量 gl_InstanceID——每个实例拿到自己的编号。第三件,逐实例属性:把一万个实例各自的变换矩阵(或位置加朝向)装进一张缓冲,用顶点属性的「除数」技巧(glVertexAttribDivisor 设为 1,属性每实例前进一格而不是每顶点前进)或直接在着色器里按编号索引 SSBO 取数。
// 实例化顶点着色器的核心三行 layout (location = 4) in mat4 instanceModel; // divisor=1 的逐实例矩阵属性 void main() { vec4 world = instanceModel * vec4(aPos, 1.0); // 每实例自己的摆位 gl_Position = projection * view * world; ... }
mat4 占四个属性位置(location 4 到 7),这是 GLSL 属性的隐规则。用 SSBO 索引的替代写法更省属性槽位,两案并存,按属性预算选。实例化的边界也要心里有数:它优化的是「提交成本」,网格本身太重(顶点太多)时瓶颈在顶点站,实例化救不了——先诊断再选刀。
一个实例化的实战账单可以建立手感:一万平方米草地,每平方米一丛草、每丛九个顶点。逐丛绘制是「一万个调用、九亿分之一的管理费乘一亿次」的天文数字;合并成一个大网格是零额外调用但草丛之间无法差异化(风吹方向、颜色变化全失);实例化是「一次调用、一万个实例矩阵、每实例九顶点」——既有一万份差异又有一次提交。三案对比后实例化的生态位一目了然:「网格相同 + 参数各异 + 数量巨大」三个条件同时成立时,它是唯一合理解,缺任何一个条件都要回到合并或逐个调用的老路。
间接绘制:CPU 交出决定权
glDrawElementsInstanced 仍然由 CPU 决定画多少。间接绘制(glMultiDrawElementsIndirect 一族)把「首顶点、索引数、实例数」这些参数本身装进 GPU 缓冲,CPU 的调用退化为「按缓冲内容画,你自己看」。参数既然在显存里,就能由 GPU 写——于是闭环成立:计算着色器(6.3 节)遍历所有物体的包围盒做视锥剔除,把「幸存者清单」直接写进间接绘制参数缓冲,随后的间接绘制按这份 GPU 生成的清单执行。整个过程 CPU 零参与、零回读(1.1 节的回读陷阱彻底绕开)。
这个闭环就是「GPU 驱动渲染」:CPU 每帧只做「发起一遍剔除计算 + 一条间接绘制 + 深度预处理」级别的少量工作,场景里十万物体与一万物体的 CPU 成本几乎相同。代价是复杂度:剔除结果的调试(第 7 章工具也难以直接观察 GPU 侧生成的清单,需要旁路手段)、多线程提交的同步设计、代码可读性的显著下降。工程判断:物体量十万级、或剔除逻辑每帧变化剧烈(粒子、大规模植被)才值得上;几千物体用「CPU 剔除 + 实例化 + 合并缓冲」就够。
💡 关键直觉:AZDO 的每件武器都在做同一件事——把「CPU 每帧的重复决策」变成「GPU 的一次批量执行」。合并缓冲消灭逐物体的绑定决策,实例化消灭逐实例的调用决策,间接绘制消灭逐批次的参数决策。优化思路先找决策,再找对应的武器。
本节要点回顾
- 调用成本是管理费不是指令费:状态校验与命令翻译每次几十微秒,千级调用就是毫秒级账单
- 定性试验:藏一半物体帧率翻倍 → CPU 限制型,别去优化着色器
- 实例化三件套:实例数参数、gl_InstanceID、除数属性或 SSBO 喂数
- 间接绘制交出决定权:参数在 GPU 缓冲、计算着色器可写、闭环零回读
- 三级阶梯按批次性质分级:先合并、重复上实例、动态上间接,先测量再升级
调用数压下来了,剩下的开销在数据搬运上——下一节解剖显存带宽:持久映射怎么让 CPU 直接写显存、动态数据怎么流式更新、无绑定纹理怎么把纹理绑定也变成历史。