2.1 组件拆解:conmon、运行时与存储栈
2.1 组件拆解:conmon、运行时与存储栈
本节摘要:Podman 引擎本身只做参数解析与状态管理,创建容器的实际工作由一组标准组件接力完成:containers/storage 提供镜像层与写时复制 rootfs,Netavark 配置网络,conmon 监控容器全生命周期,crun 按照 OCI 规范创建进程。本节沿一条命令的执行路径拆解这套接力,并把每个组件与 Docker 架构中的对应角色做对照。
从回车到进程诞生:一条完整路径
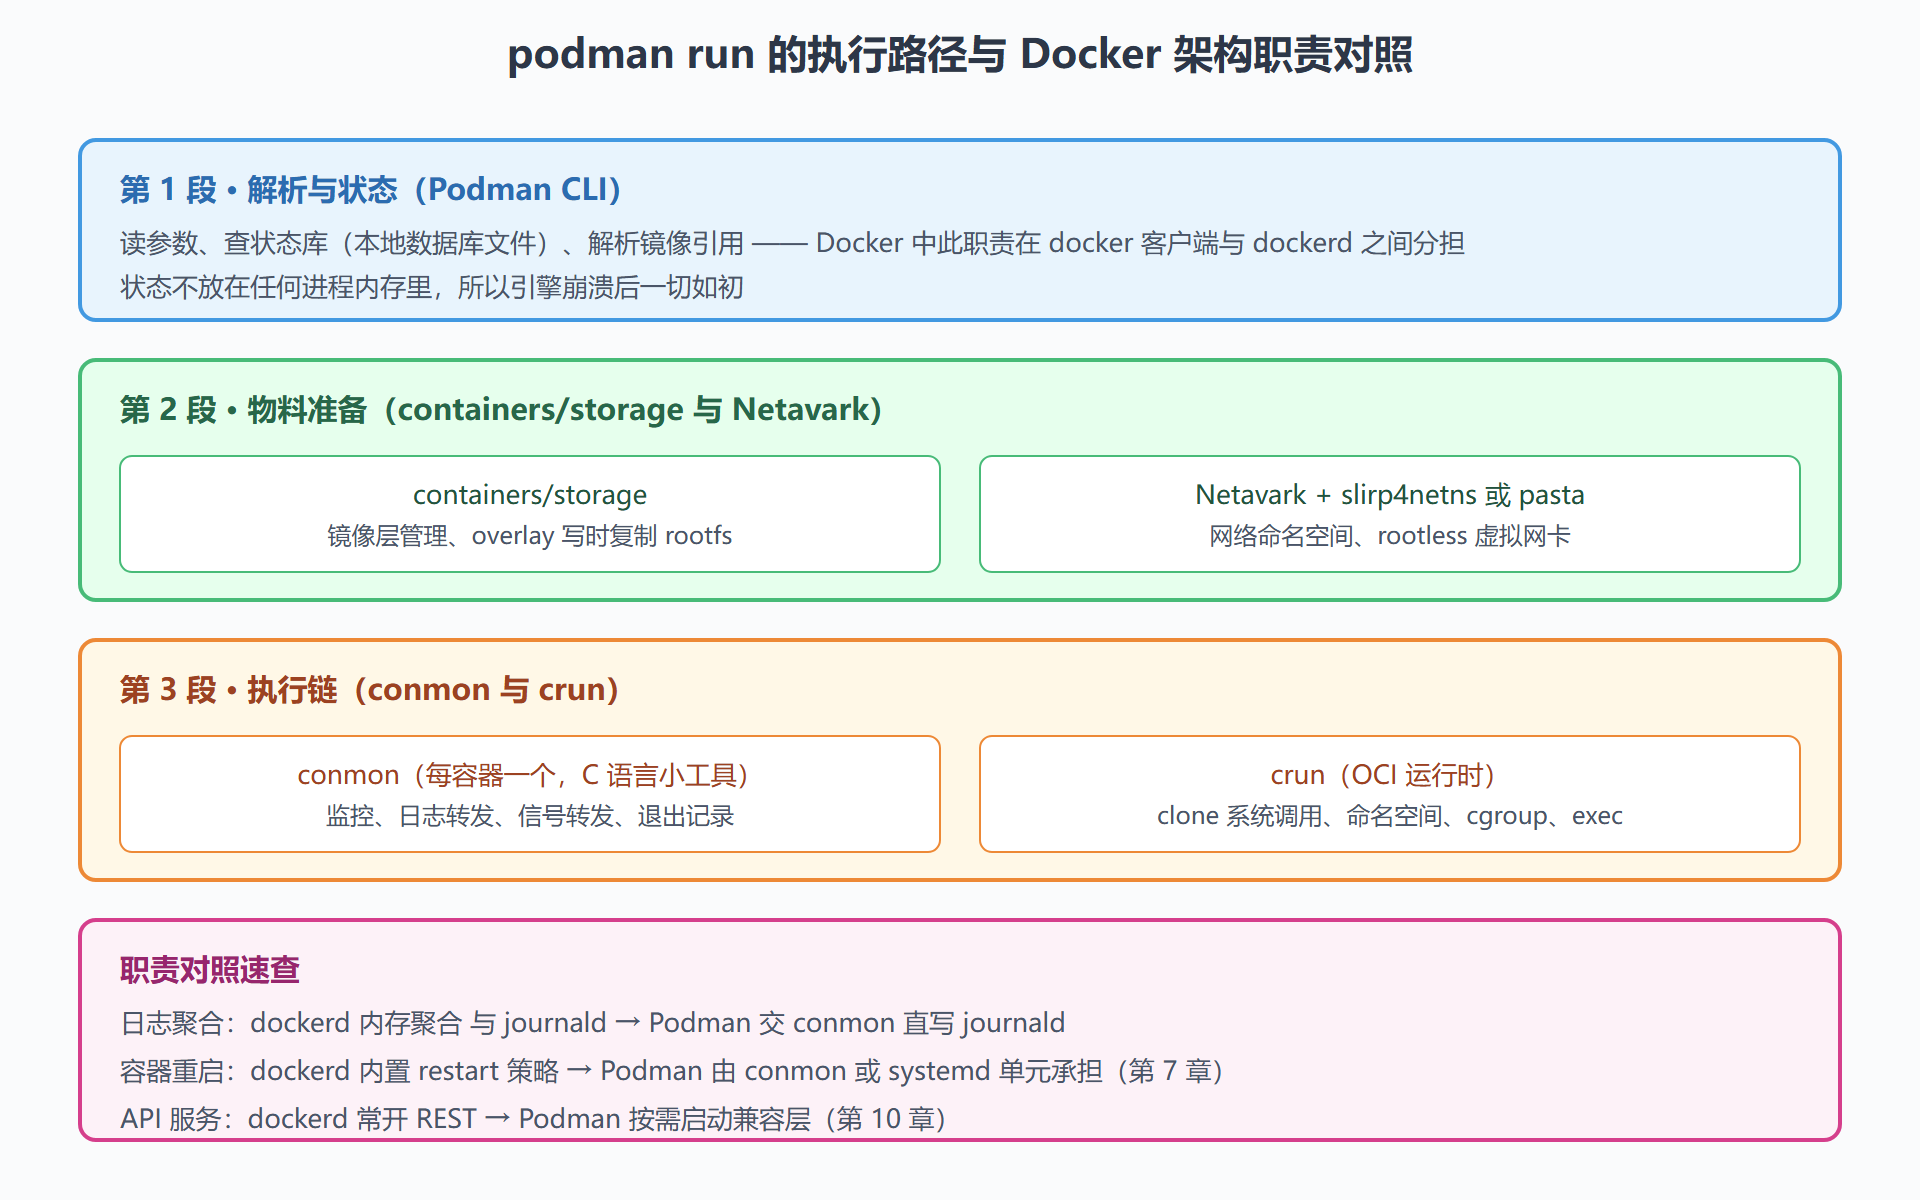
把 podman run -d nginx:alpine 想成一条流水线,货物流向如下:CLI 进程先查本地状态库(数据库文件,不是守护进程内存),确认镜像存在;若不存在则向仓库拉取(内部逻辑与 Skopeo 同源)。镜像就绪后,containers/storage 用 overlay 挂载技术把只读镜像层加一个可写层组装成 rootfs;Netavark 在 rootless 场景下用 slirp4netns 或 pasta 仿造一块虚拟网卡;然后 Podman fork 出 conmon,conmon 再调起 crun,由 crun 完成 clone、设置命名空间与 cgroup 的系统调用,容器进程才算诞生。
conmon:被低估的迷你管家
这套架构里最容易被忽视也最关键的是 conmon。它是用 C 写的小程序,Podman 为每个容器 fork 一个,父进程退出后它继续以独立进程存在,职责清单相当实在:持有容器主进程的打开描述符、把容器输出转发给 journald、把用户信号转发给容器、在容器退出时记录退出码并执行清理、按配置执行重启。
为什么必须独立于 Podman 进程存在?因为 CLI 进程会退出。Docker 里"容器活得比客户端久"由 dockerd 保证;Podman 里这个职责给了 conmon——它就是去中心化后的"看孩子的人"。验证它的存在感:
# 启动一个容器,观察 conmon 的命令行 podman run -d --name demo quay.io/libpod/alpine:latest sleep 600 ps -o pid,cmd -C conmon # PID CMD # 8421 /usr/bin/conmon --api-version 1 -c demo # -r /usr/bin/crun ... --exit-command /usr/bin/podman # 注意最后一段:conmon 被赋予了"容器退出后调用 podman 清理"的指令。 # 迷你管家手里有容器全生命周期的钩子 # 停掉 conmon 会发生什么?容器进程仍在(它由 crun 创建,不是 conmon 的子进程), # 但日志与重启机制失效——这就是"组件化"的含义:坏一个件,坏一件事
crun 与运行时选择
crun 做"最后一公里":读 OCI 运行时规范的 JSON 配置(config.json),执行 clone 设置全部命名空间、写 cgroup、chroot 到 rootfs、最后 exec 用户命令。它是 C 实现,Red Hat 系发行版的默认;另一主流 runC 是 Go 实现,Docker 的默认,两者都实现同一规范,可以互换。
# 查看与切换运行时 podman info --format '{{.Host.OCIRuntime.Name}}' # crun # 在 containers.conf 中可切换(改全局默认或单次指定) podman run --runtime runc --rm alpine:3.19 echo ok # ok # 选型经验:crun 启动更快、内存占用更低;runC 生态更老。 # 对绝大多数场景两者无感,真正需要纠结的是第 10 章的 CRIU 检查点功能支持度
存储栈:镜像层的物理形态
containers/storage 是 Podman、Buildah、Skopeo 三者共享的底层库(第 3 章的主角设定由此而来)。它管理两个目录:镜像与层的仓库,加上每个容器的可写层。rootless 模式下这一切在用户家目录里,rootful 则在系统路径下:
# 两套存储完全独立,看一眼物理位置 podman info --format 'rootless: {{.Store.GraphRoot}}' # rootless: /home/dev/.local/share/containers/storage sudo podman info --format 'rootful: {{.Store.GraphRoot}}' # rootful: /var/lib/containers/storage # 解读:同一台机器、同一个用户,rootless 与 rootful 的镜像缓存互不相通。 # 这解释了一个高频疑问:"为什么 sudo podman 里没有我刚拉的镜像?"
存储驱动默认 overlayfs(写时复制):多个只读层叠出镜像,一个可写层承载容器运行期修改。这与 Docker 的 overlay2 驱动在内核机制上同源——差异不在技术,在于"这套存储归谁用":Docker 的存储归 root 守护进程私有,Podman 的存储按用户隔离、按工具共享。所有权模型的不同,正是第 3 章生态对比的种子。
写时复制的实际收益值得用数字体会:两个都基于同一个 nginx 基础镜像的容器,磁盘上基础层只存一份;容器里对文件的修改只占可写层的增量空间。验证手段是现成的系统命令:
# 看镜像的分层与各层大小 podman image tree docker.io/library/nginx:alpine 2>/dev/null \ || podman history docker.io/library/nginx:alpine # 每行一个层:基础系统、依赖安装、配置—— # 多个镜像共用的层在存储里只有一份物理拷贝 # 看一个正在运行的容器实际"写"了多少 podman container diff myweb # C /etc、A /var/cache/...(C 改动、A 新增) # 这些改动全部落在可写层,镜像本身从未被碰过
这也解释了第 5 章会展开的一个现象:容器内修改文件后 commit 成镜像,会生成新层而不是改写旧层——分层与共享是同一机制的两面,理解了"层只增不改",镜像膨胀与清理(第 9.2 节的 prune 三连)的逻辑就全部通了。
本节要点回顾
- 职责没有消失,只是被拆开:解析、存储、网络、监控、执行五个环节各归标准组件
- conmon 是去中心化的管家:每容器一个,管日志、信号、退出码与重启钩子
- crun 只做最后一公里:按 OCI 规范 JSON 执行 clone 与 exec,可替换成 runC
- 状态在文件不在内存:引擎崩溃不影响容器与元数据,这是无守护进程的前提
- 存储按用户与权限隔离:rootless 与 rootful 的镜像缓存互不相通,sudo 下"丢镜像"是这个原因