1.1 一次抓包引出的悬案:Protobuf三层职责
1.1 一次抓包引出的悬案:Protobuf 三层职责
本节摘要:从一个真实的线上排障案例切入——网关抓包显示服务 B 收到的 Protobuf 消息比服务 A 发出的少了一个字段。围绕这桩悬案,本节拆解 Protobuf 的三层职责:IDL 契约层(proto 文件)、wire format 编码层、protoc 生成层,并给出学习这三层的正确顺序。读完你应当能独立读懂一段十六进制 dump 的大致结构,并说出字段"凭空消失"的三种可能原因。
在知识地图上,本节是全册的锚点:它建立问题意识(为什么必须懂字节层)并铺出三层职责框架,第 2、3、4 章分别把每一层挖深。如果你已经写过多年代码但从未打开过 Protobuf 的字节流,这一节就是为你写的。
悬案现场
某支付链路的排障记录是这样的。服务 A 用 Go 编写,发出一条用户事件消息;服务 B 用 Java 编写,消费同一条消息。测试环境一切正常,灰度环境里服务 B 的日志突然出现大量"字段缺失"告警。运维在网关侧抓到两个环境各一条消息的十六进制 dump(此处截取开头 32 字节):
测试环境: 0A 10 08 E9 07 10 05 1A 06 E4 B8 AD E6 96 87 12 0B ... 灰度环境: 0A 10 08 EA 07 10 05 1A 06 E4 B8 AD E6 96 87 12 0B ...
两段字节长度相同、结构相同,肉眼几乎分不出差别——差异藏在第 4 字节:E9 07 变成了 EA 07。开发同事最初的判断是"网络丢包",但消息长度没变、校验通过,丢包说不成立。真正的答案要到第 3 章才揭晓(先剧透:那个字节是一个 varint 编码的时间戳,跨过了一个 128 的进位边界,而下游某个环节用了错误的解码方式)。这里要说的不是答案本身,而是这桩悬案暴露出的认知断层:团队里每个人都"会用" Protobuf,但没有人能读懂它产出的字节。
这就是这套教程的出发点。用考古的行话说:大家都在博物馆里隔着玻璃看展签,没有人下过发掘现场。
三层职责:把黑箱拆成三个可考察的地层
把 Protobuf 说成"一个序列化库",就像把一座城说成"一堆房子"——字面没错,但什么都解释不了。它实际由三个职责迥异的层构成,故障排查时你必须先判断问题出在哪一层。
第一层:IDL 契约层
proto 文件是独立于任何编程语言的接口契约。一段最小的定义长这样:
syntax = "proto3"; message UserEvent { uint64 event_id = 1; int32 priority = 2; string nickname = 3; }
注意三个细节:syntax = "proto3" 声明语言版本(决定后面大量语义);每个字段等号右边是字段编号而不是默认值——编号才是字段在字节流中的身份标识,字段名只活在编译期;类型决定编码方式。这一层由第 2 章专门发掘。
第二层:wire format 编码层
序列化后,上面的消息变成一串字节。比如 event_id = 1000 编码为 08 E8 07。这层定义了"每个字节是什么意思":08 标识"字段 1、varint 类型",E8 07 是 1000 的变长编码。悬案里那段 dump 的每一处差异,都发生在这一层。它由第 3 章逐字节发掘。
第三层:protoc 生成层
proto 文件本身不能运行,要靠编译器把它翻译成各语言的桩代码——Go 的 struct 与 Marshal 方法、Java 的不可变类与 Builder。悬案的另一个常见根源就在这层:protoc 版本差异会让生成代码行为不同。第 4 章拆解这条流水线。
图 1-2 一条消息的三层旅程
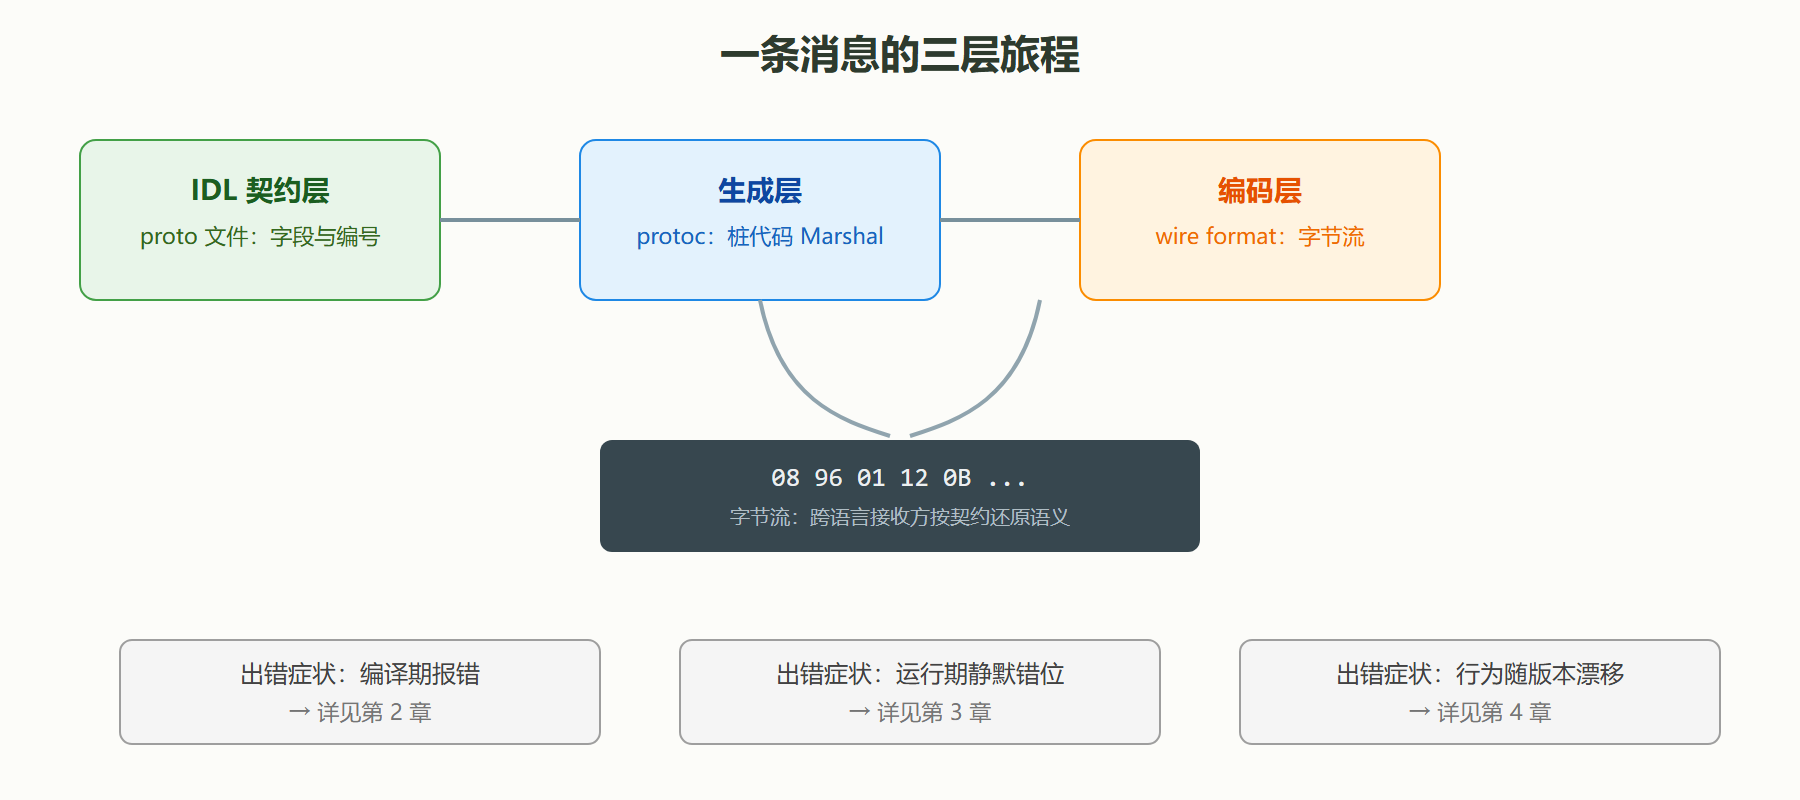
三层职责可以用一张对照表钉死:
| 层次 | 载体 | 回答的问题 | 出错时的典型症状 | 对应章节 |
|---|---|---|---|---|
| IDL 契约层 | proto 文件 | 数据长什么样、字段叫什么 | 编译期就报错,最容易暴露 | 第 2 章 |
| wire format 层 | 十六进制字节 | 每个字节如何编码、如何被跳过 | 运行期静默出错,最难排查 | 第 3 章 |
| 生成层 | 各语言桩代码 | 契约如何落地成可执行代码 | 行为随版本漂移,诡异难懂 | 第 4 章 |
实战案例:用三个工具完成第一次现场勘察
背景:假设你要在没有任何文档的情况下,搞清楚一段线上消息的大致结构。操作过程如下。
操作:先把悬案里的字节存进文件(十六进制转二进制后保存为 message.bin),然后用 protoc 自带的解码工具勘察:
protoc --decode_raw < message.bin
输出大致是:
1: 1000 2: 5 3: "\344\270\255\346\226\207"
结果解读:decode_raw 不需要任何 proto 文件,它按 wire format 语法"硬解"出字段编号与值——字段 1 是整数 1000,字段 3 的那串八进制转义正是 UTF-8 的"中文"两字。这就是悬案勘察的第一件工具:不需要契约也能看出大致结构,这正是 TLV(Tag-Length-Value)设计的威力。
变式:如果手头有 proto 文件,用 protoc --decode=UserEvent events.proto < message.bin 可以得到带字段名的完整还原;Go 环境下也可以在测试里打印 proto.Marshal 的结果再用 %x 格式输出十六进制对照。三个工具覆盖了从"完全黑箱"到"完全契约"的勘察光谱。
⚠️ 一个高频误判:decode_raw 显示"字段编号"而不是字段名。悬案里"字段消失"的第一种可能原因,其实是字段还在字节流里,只是查看工具没有契约、显示不出名字——先确认这一点,再怀疑数据丢失。
字段"凭空消失"的三种可能
把悬案做一般化总结,字段缺失只有三种字节层原因,后续章节会逐一验证:
- 字段编号被重用:proto 文件里新增字段占用了旧编号,老字节被新契约解读成别的语义(第 5 章);
- wire type 不匹配:字段的编码类型变了(如 int32 改 string),解码器按错误方式读取导致后续字节错位(第 3、5 章);
- 生成层行为差异:不同 protoc 版本对未知字段的丢弃策略不同,中转服务把没见过的字段剥掉了(第 4、5 章)。
本节要点回顾
- 悬案是入口:字节层知识不是锦上添花,是线上排障的刚需——团队"人人会用、无人能读"是常见断层;
- 三层职责:IDL 契约层、wire format 编码层、protoc 生成层,排障第一步是定位问题在哪一层;
- 字段编号是身份:proto 文件里等号右边是编号不是默认值,编号决定字节流中的身份;
- decode_raw 是勘察铲:无需契约即可硬解任意 Protobuf 字节,这是每次现场勘察的起点;
- 消失有三种:编号重用、wire type 错配、未知字段被剥——三种原因分别在第 3、4、5 章找到机理。
下一节把时间轴拉开:这些设计不是一次性成型的,proto2 到 proto3 的每一次"挖掘回填"都有工程代价,看懂年表才能理解今天的规则为什么长这样。