1.2 地层年表:proto2、proto3与editions的三个转折
1.2 地层年表:proto2、proto3 与 editions 的三个转折
本节摘要:Protobuf 的语法从 proto2(2008 开源)到 proto3(2014 主推)再到 editions(2023)走过三大地层,每次转折都伴随特性的挖掘与回填:proto3 挖掉 required 与显式 optional,editions 又把字段存在语义交还给开发者。本节按地层学方式梳理这条年表,重点解析每个转折点解决的具体问题与付出的代价,并给出新项目迁移 editions 的判断依据。
承接上一节的悬案:想读懂今天的规则,必须知道规则是怎么变成这样的——地层年表提供的就是这种纵向视野。它也为第 5 章的兼容性规则准备好了历史背景:为什么字段编号"只增不改"会成为铁律,答案埋在 proto2 时代的血泪里。
为什么考古者需要年表
先交代一段行话背景。Protobuf 2001 年诞生于 Google 内部,2008 年以 proto2 之名开源。注意一个容易混淆的点:proto2 指的是语法版本(proto 文件第一行 syntax = "proto2" 声明),而不是发布序号——开源的第一个版本就叫 proto2,因为 Google 内部此前的演进史没有对外公开编号。这个命名让无数初学者困惑过:"proto1 去哪了?"答案:没有 proto1,只有内部代号。
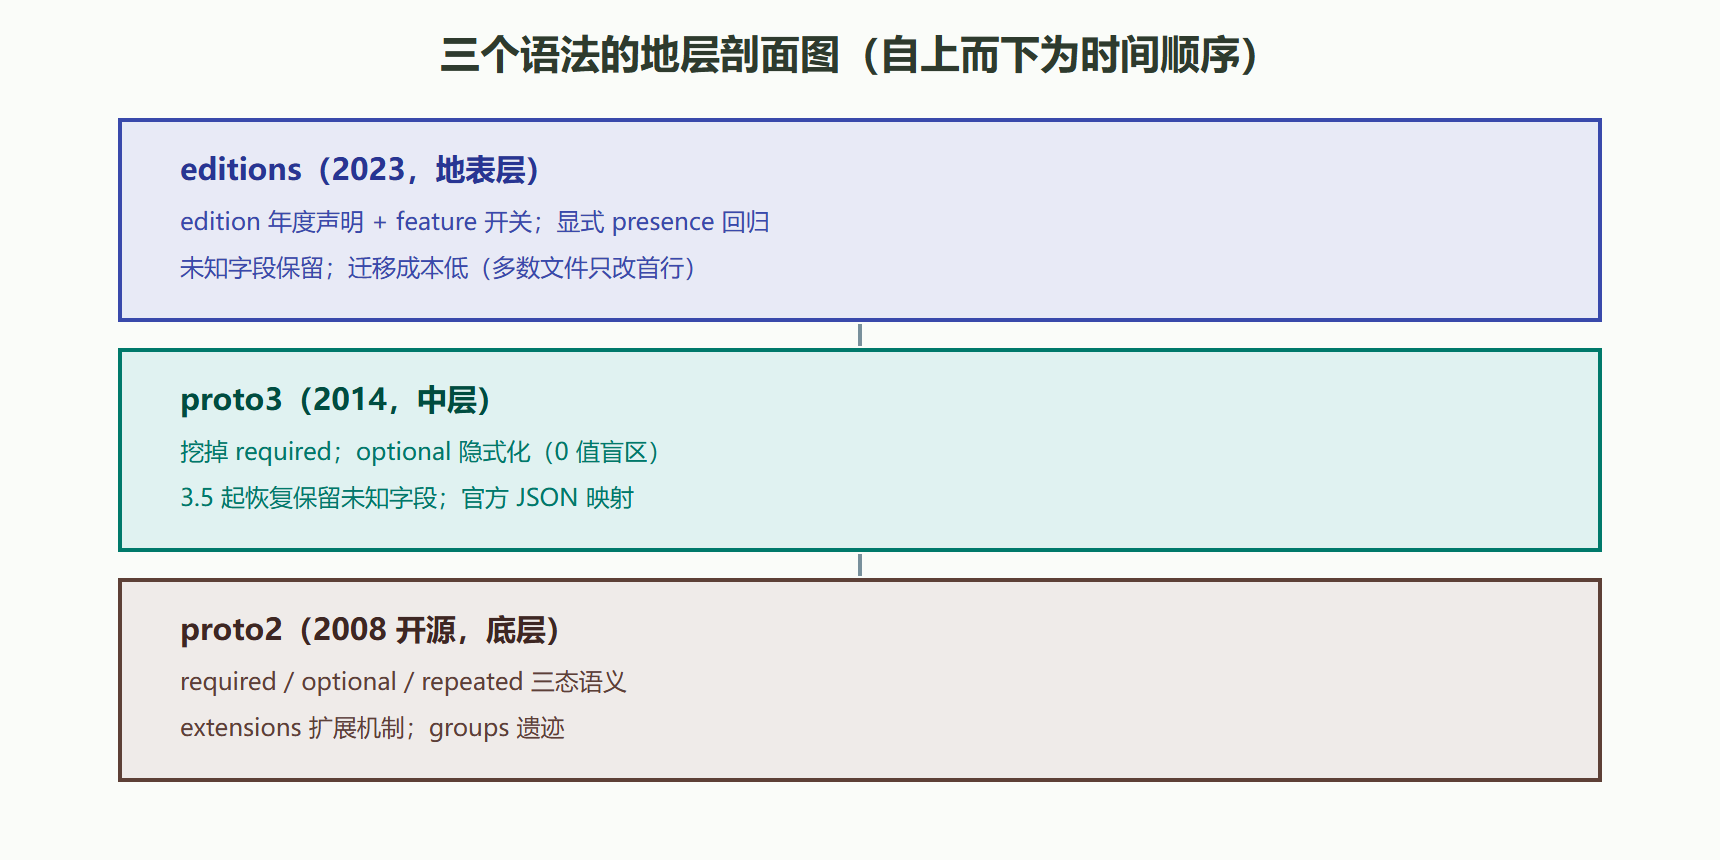
三个地层各自的特征先列成对照表,后面逐一展开:
| 维度 | proto2 | proto3 | editions |
|---|---|---|---|
| 字段存在语义 | required / optional / repeated 三态 | 全部隐式 optional,去掉 required | 显式 presence,按 feature 声明 |
| 未知字段 | 保留并回传 | 起初丢弃,3.5 起恢复保留 | 保留,行为可配置 |
| JSON 映射 | 无官方标准 | 官方 JSON 规范 | 继承 proto3 |
| 典型声明 | optional string name = 1; |
string name = 1; |
edition = "2023"; + features |
第一个转折:proto3 挖掉 required
proto2 时代最著名的坑是 required 修饰符。它要求发送方必须填写该字段,否则序列化直接失败。设计初衷是强契约,现实却演化成一场灾难:一个运行了五年的系统里,某个 required 字段想改成 optional——升级期间,新旧两端对"消息是否合法"的判断不一致,旧发送方认为不带该字段的消息是坏的,新接收方认为带不带都行,协议协商窗口里故障不断。
Google 内部最终得出结论:required 的存在让协议演化变成不可能。proto3 干脆把它整个挖掉,同时做了一个更激进的决定:连 optional 也隐式化——所有标量字段默认"可缺省",读取未设置的字段返回类型默认值(int32 返回 0,string 返回空串)。这带来了著名的"0 值不可见"问题:字段值是 0,和字段根本没被赋值,序列化后无法区分(proto3 里两者都编码为"不输出")。这个取舍简化了绝大多数业务场景,却让"显式空值"表达成为缺口。
💡 一个考古式的直觉:proto3 的激进做减法,本质是把"契约该多严"这个问题从语言层挪回了应用层。语言不再替你担保存在性,你的业务代码要自己区分"0 是有效值"还是"没填"。
图 1-3 三个语法的地层剖面图
第二个转折:未知字段的丢弃与回填
proto3 开源初期还有一个今天看来匪夷所思的行为:解码器遇到不认识的字段直接丢弃,重新序列化时这些字段不会出现在输出里。设想一个中转代理服务:上游发来带新字段的消息,代理反序列化再序列化转发下游——新字段无声消失,下游永远收不到。这类"代理剥字段"故障在微服务架构里尤其高发。
2017 年的 3.5 版本把行为改了回来:未知字段默认保留,与 proto2 对齐。这是一次典型的"挖掘回填"——认识到当初的简化在真实架构里代价过高。这个案例的价值在于提醒我们:序列化器的行为细节本身就是分布式系统的一致性来源,第 5 章会把它展开成完整的兼容规则。
第三个转折:editions 把语义还给开发者
proto3 挖掉 optional 造成的不便,催生了大量 workaround(用 wrapper 类型包装、用 oneof 强制 presence),社区抱怨十年。2023 年 Google 推出 editions 机制:不再有大版本号的革命,改为按年度 edition 声明一组 feature 默认值,开发者可逐项覆盖:
edition = "2023"; message Order { int32 quantity = 1 [features.field_presence = IMPLICIT]; string note = 2; // edition 2023 默认显式 presence,等价 proto2 的 optional }
edition 2023 的默认行为:字段显式 presence(解决 proto3 的 0 值盲区),未知字段保留。迁移成本被刻意压低——大部分 proto3 文件只需把首行换成 edition 声明。新项目是否该直接上 editions?我的判断是:团队工具链(protoc、各语言运行时、buf)都跟上 2023 edition 的今天,新项目直接用 editions 是合理默认;存量 proto3 项目按第 5 章的兼容法则逐文件迁移,不必一刀切。
实战案例:一次 syntax 迁移的完整过程
背景:某团队维护着一个 proto2 存量服务,计划迁移到 proto3 以获得 JSON 映射与新语言支持。操作:先全局搜索 required——发现 12 处,全部逐个改为业务层校验(在序列化前手工检查必填字段);再处理 optional 标量字段——凡是被下游依赖"是否设置过"语义的,改用 wrapper 类型 google.protobuf.Int32Value;最后把首行改为 syntax = "proto3" 逐文件编译。结果:迁移本身一周完成,但灰度期发现两起下游解析异常——都是字段编号在历史版本里被重用过的旧债,被这次严格编译暴露出来。解读:语法迁移的显性工作量不大,风险藏在字段编号的历史欠账里——这正是下一章要立的规矩。变式:如果目标是 editions,步骤相同,但 wrapper 类型那步可以省掉(edition 2023 原生支持显式 presence)。
本节要点回顾
- 三个地层:proto2(三态字段语义、保留未知字段)→ proto3(极简、隐式 optional、一度丢未知字段)→ editions(feature 开关、显式 presence 回归);
- required 之死:不是被更好的机制替代,而是被证明与协议演化根本冲突;
- 0 值盲区:proto3 里"值是 0"与"没赋值"编码后不可区分,是迁移排查的高频坑;
- 未知字段政策:3.5 版本是分水岭,之前的 proto3 会剥掉未知字段,中转服务要特别当心;
- 迁移先查编号:语法迁移的主要风险不在语法本身,在字段编号历史欠账。
地层决定了骨架长什么样,但骨架的每个关节——message、编号、类型——的精细规则还在 proto 语言本身。下一章进入正式发掘的第一站。