1.3 选型地层学:与JSON、Avro、Thrift的对比
1.3 选型地层学:与 JSON、Avro、Thrift 的对比
本节摘要:把 Protobuf 与 JSON、Apache Avro、Apache Thrift 放进同一探方逐层比对,维度包括字节体积、编解码速度、schema 演进机制、人类可读性与生态工具链。结论不是一个简单的赢家,而是一张适用边界地图:内部高频通信选 Protobuf,对外开放 API 多数场景仍是 JSON,Avro 在批量列存场景有独特优势,Thrift 的历史地位由 RPC 一体性决定。
本节是地表踏查的最后一站,回答"什么时候用"——这个问题没有标准答案,但有可复用的论证框架。承接前两节:1.1 建立了三层职责模型,本节把四个候选格式都放进这个模型里比对,你会发现选型争议多数源于把不同层的问题混在一起谈。
四个候选格式的出身
用一段行话开场:序列化格式的江湖里,JSON 是"没有 schema 的普通话",Avro 是"schema 与数据同行的搬家卡车",Thrift 是"自带 RPC 的老牌军火库",Protobuf 则是"契约先行的铸币厂"。四者设计目标不同,直接比"谁更快"是伪问题——要比的是在你的场景里,哪一层的代价你能承受。
| 格式 | 诞生 | schema | 编码 | 人类可读 | 典型阵地 |
|---|---|---|---|---|---|
| JSON | 2001 标准化 | 可选(JSON Schema 弱规范) | 文本 | 是 | Web API、配置、开放生态 |
| Thrift | 2007 Facebook | 强制 IDL | 二进制(多协议可选) | 否 | 跨语言 RPC(历史存量) |
| Avro | 2009 Hadoop 系 | 强制(读写双方 schema 协商) | 二进制 | 否 | 大数据列存、Kafka Schema Registry |
| Protobuf | 2008 开源 | 强制 IDL | 二进制 TLV | 否 | gRPC、微服务内部通信、K8s |
逐层比对:把探方切到三个深度
浅层:体积与速度
拿同一份数据编码对比(一条含 5 个字段、一段短文本的用户事件,各编码 100 万次取均值,具体数字因数据形态而变,量级关系稳定):
| 格式 | 编码后字节数 | 相对体积 | 编码速度量级 | 解码速度量级 |
|---|---|---|---|---|
| JSON | 约 120 | 100% | 慢(文本解析) | 慢(文本解析+类型推断) |
| Thrift(紧凑协议) | 约 58 | 48% | 快 | 快 |
| Avro | 约 40 | 33% | 快 | 快(需先对齐 schema) |
| Protobuf | 约 45 | 37% | 快 | 快 |
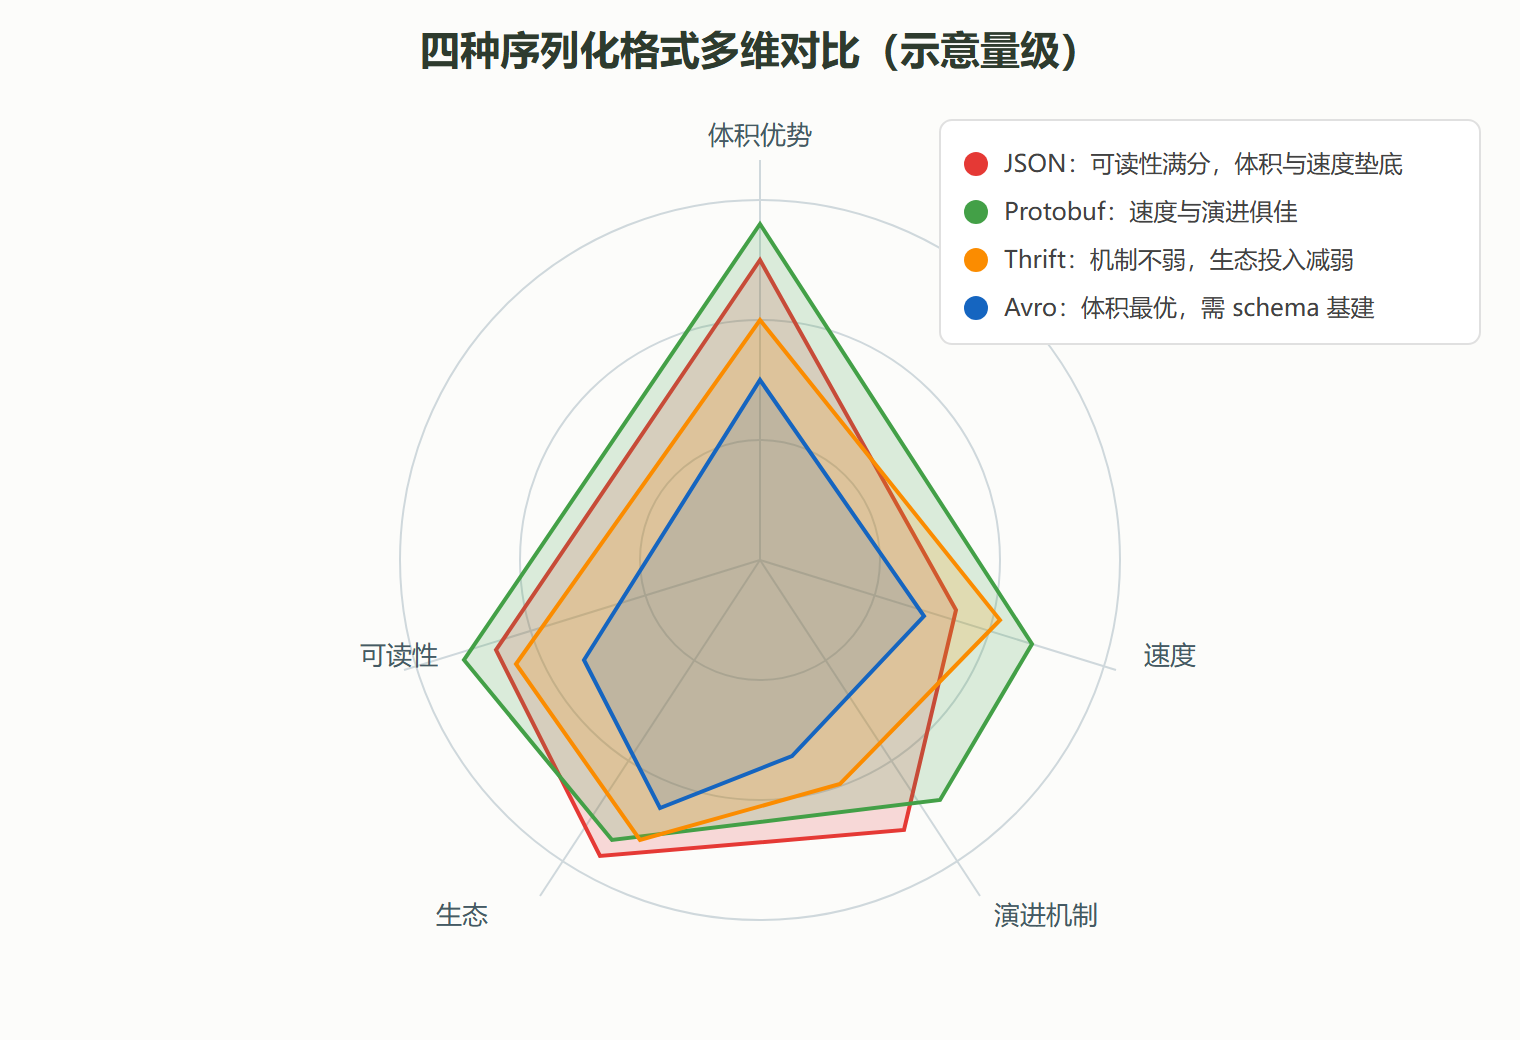
三个值得注意的细节:其一,JSON 的体积膨胀主要来自键名重复——每个对象都要写一遍 "event_id" 这样的字符串键名,而 Protobuf 只写字段编号(一个字节);其二,Avro 在数值密集数据上常常比 Protobuf 更小,因为它的编码根本不写字段标识,纯靠读写双方 schema 的位置对齐;其三,解码速度上 JSON 的劣势不只是文本解析,还有动态类型判定——每个值都要判断是数字、字符串还是嵌套对象。
中层:schema 演进机制
这是最容易被忽视、却最影响长期成本的一层。四种格式的演进哲学截然不同:
Protobuf 与 Thrift 都用字段编号锚定身份——只要编号不重用、wire type 兼容,新旧版本可以互相解读。Avro 走了另一条路:数据里完全没有字段标识,读方拿自己的 schema 对照写方的 schema 做"按名解析",增删字段时靠解析器自动跳过对不上的部分。这套机制在 Kafka 这样"写一次、多版本读者长期消费"的场景里非常优雅,但要求基础设施把两个 schema 都送到读者手里(Schema Registry 应运而生)。
深层:可读性与生态
人类可读性是 JSON 最硬的护城河:curl 一下就能看返回值,浏览器开发者工具直接展示,日志排查无需任何工具。Protobuf 的字节流必须借助 decode 工具(第 1.1 节的勘察三件套)。这个差距在生产环境里的实际成本,取决于你的排障频率。
生态维度上四者差异巨大:JSON 有全宇宙的语言支持;Protobuf 背靠 gRPC、Kubernetes API、Envoy 的 xDS 协议,云原生世界事实上通用语;Avro 深耕 Hadoop/Spark/Kafka 生态;Thrift 早年靠 Facebook 与 Cassandra 的采用立足,如今社区投入明显减弱,新项目选它的理由基本只剩存量对接。
图 1-4 四格式多维雷达对比
实战案例:一次真实的选型评审
背景:某公司要建一条新的事件管道,事件从三十多个微服务产生,经 Kafka 传输,下游有实时风控(Java)、离线数仓(Spark)、运营后台(Web 前端)三类消费方。候选:JSON、Protobuf、Avro。
操作:评审按三层展开。体积层——预估日均 200 亿条事件,JSON 比 Protobuf 多出的约 60% 体积意味着每年数百 TB 的额外存储与带宽,砍掉 JSON。演进层——事件 schema 会频繁演进,Protobuf 与 Avro 都支持,但 Kafka 侧已有 Confluent Schema Registry 对 Avro 的深度集成,Avro 加分。消费方层——运营后台是浏览器前端,无法直接消费二进制格式;实时风控团队强烈要求强类型桩代码。
结果:最终方案是双轨——Kafka 主链路用 Protobuf(风控与数仓都消费二进制),运营后台走一个独立的 JSON 网关,由事件 schema 自动生成转换代码(第 8 章的互操作话题)。Avro 落选的原因不是技术劣势,而是团队栈里 Protobuf 已有 gRPC 基建与人才储备。
解读:这次选型最值得复用的经验是按消费者分层论证——管道类决策的第一问不是"哪个格式更好",而是"谁在读、他们各自的约束是什么"。变式:如果事件量小两个数量级、且只有一两个消费方,JSON 一把梭反而是对的——工程成本里最贵的永远是维护两个体系的人力。
本节要点回顾
- 没有全能赢家:体积速度 Avro/Protobuf 并驾,可读性 JSON 独占,演进机制 Protobuf 的编号锚定最适合多语言微服务;
- JSON 膨胀的根源是键名重复与动态类型判定,理解这一点比记住百分比重要;
- Avro 的按名解析优雅但有基建前提,没有 Schema Registry 就没有 Avro 的演进红利;
- Thrift 的今天:机制上并不落后,败在生态投入,新项目选型要考虑社区的长期供血;
- 选型按消费者分层:先枚举所有读方及其约束,再定格式,双轨制(内部二进制+对外 JSON)是最常见的落点。
踏查到此结束。下一章拿起手铲进入第一个正式探方——proto 语言本身:message、字段编号与类型系统,地层里的每一道铭文都有讲究。