7.1 建立基准:测量序列化的真实开销
7.1 建立基准:测量序列化的真实开销
本节摘要:可信的序列化基准要避开三个反模式:循环内分配污染、单一形状样本、忽视运行时预热,并且要区分吞吐型与尾延迟型两种解读口径。本节给出一个可复用的测量框架、一组参考量级(并解释为什么不该迷信它)、以及"线上比基准慢十倍"的排查路线。读完你应当能为自己的消息形状跑出可复现的数字。
本章的第一件事是校准仪器。考古学里碳十四测年先要校准曲线,性能测量先要消除测量本身的系统性偏差——序列化基准的反模式多到值得专门一节。
三个反模式与修复
反模式一:循环内分配污染。 最常见的错误写法:
// 错误示范:b 每轮重新分配,测的是分配器不是序列化 for i := 0; i < N; i++ { b, _ := proto.Marshal(msg) // b 逃逸到堆上 _ = b }
每轮都新分配输出缓冲区,测出来的数字一半是内存分配器的开销。修复:预分配足够容量的缓冲区并复用(多数运行时的 Marshal 支持传入目标缓冲区或提供 Reset 语义)。但注意一个反转——预分配不是永远更快:如果消息体积差异大,过大的预分配会恶化缓存局部性,小消息反而变慢。正确姿势是按消息体积分桶各自测。
反模式二:单一形状样本。 用一条消息测一亿次,结论只对这条形状成立。第 3 章已经证明:同样字段数,全小正数(varint 1 字节)与带负数字段(int 系 10 字节)的体积与耗时差数倍。修复:样本集覆盖值域分桶(小值、跨界值、负数、大值、长字符串、深嵌套),分别报告。基准样本的设计本质是对第 3 章编码机理的枚举——你已经知道哪些形状贵,样本就要包含它们。
反模式三:忽视预热与 JIT。 虚拟机语言(Java、C#)的首次迭代包含 JIT 编译,Go 的首次分配触发堆增长,都不代表稳态。修复:先跑够量的预热轮再计时;同时警惕编译器把"结果没人用"的循环整个优化掉——把校验和累加并在循环里最后打印出去,是防优化的古典手法。
一个可复用的测量框架
func Benchmark(msgs []proto.Message, out *testing.B) { // 预分配按最大消息的序列化尺寸估算 buf := make([]byte, 0, maxEncodedSize(msgs)) var sink uint64 for i := 0; i < out.N; i++ { m := msgs[i % len(msgs)] // 样本轮换:覆盖形状分桶 n, err := proto.MarshalOptions{}.MarshalAppend(buf[:0], m) if err != nil { out.Fatal(err) } sink += uint64(len(n)) // 防优化:消费结果 } if sink == 0 { out.Fatal("空结果") } // 防优化:条件消费 }
框架的四个要素都在前面论证过:缓冲复用(MarshalAppend 到同一底层数组)、样本轮换(形状分桶进 msgs)、结果消费(sink 累加)、失败即停。反序列化的版本结构相同,方向反过来。
两种解读口径
同样一组数字,按场景有两种读法:
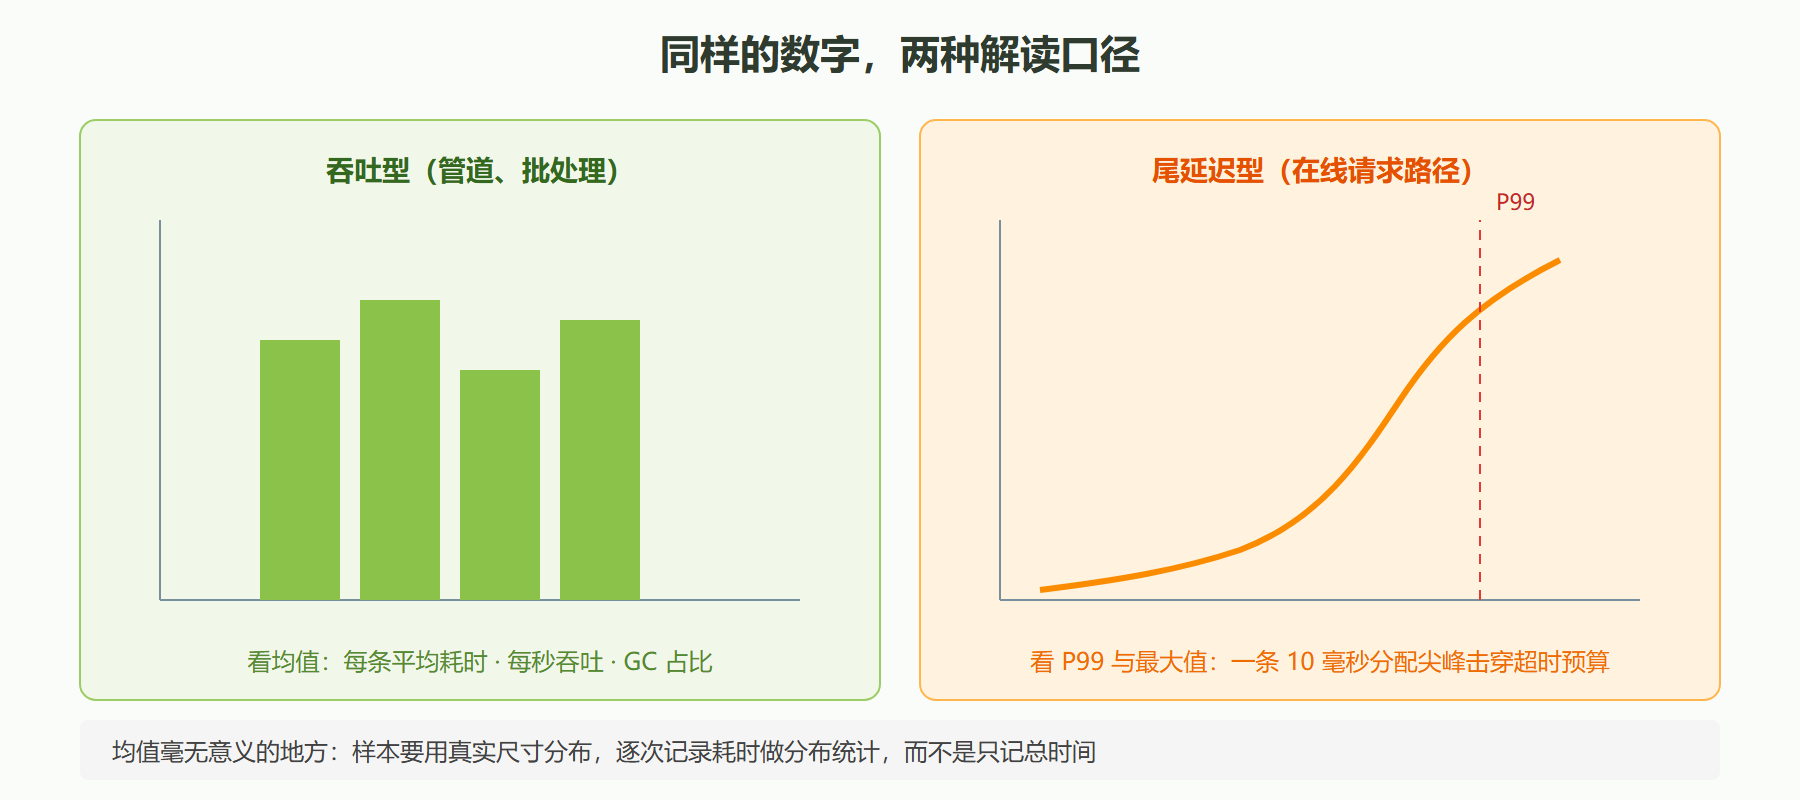
吞吐型(管道、批处理、日志采集):关心每条平均耗时与每秒吞吐——总耗时除以条数就是决策数字,分配压力(垃圾回收占比)要一并观察,因为吞吐场景的稳定态由 GC 节奏决定。尾延迟型(在线请求路径、交易链路):关心P99 与最大值——平均值毫无意义,一条 10 毫秒的分配尖峰足以击穿超时预算。两个口径的测量配置也不同:尾延迟型要用真实尺寸分布的样本、记录每次耗时做分布统计,而不是只记总时间。
图 7-2 吞吐型与尾延迟型的解读差异
参考量级与它的正确用法
给一组参考量级(Go 与 Java 各一档主流运行时、普通 x86 服务器、小消息约百字节量级):单条 marshal 与 unmarshal 各在微秒以下到数微秒之间,比同尺寸 JSON 快约五到十倍。这组数字的正确用法是校验你自己的测量没有系统性错误——如果你的数字偏离一个数量级,先怀疑测量方法,再怀疑场景特殊。错误用法是写进架构文档当承诺——你的消息形状、字段构成、运行时版本、硬件都会让真实数字漂移。
实战案例:一次"线上慢十倍"的排查
背景:某服务上线前的基准显示单条反序列化 2 微秒,线上 P99 却到 20 微秒上下,团队怀疑基准做错了。操作:第一步复跑基准(方法无误、数字复现);第二步取线上真实消息样本按第 3 章机理做形状分析——发现线上消息的 repeated 字段平均 40 元素(基准样本是 3 元素)、且 map 字段平均 60 键(基准是 2 键),LEN 载荷的长度前缀解析与分配次数随元素数线性放大;第三步重建基准样本集(按线上分布重造),数字回到 18 微秒,与 P99 对齐;第四步针对性优化——该服务在请求路径上反序列化完整消息只为读三个字段,改用反射按需读取(第 6.2 节的分层技巧),P99 降到 6 微秒。结果:差距全部归因,优化有的放矢。解读:这个案例的教学点是基准样本的形状必须来自真实分布——不是"造一条差不多的消息",而是从生产环境采样(或按字段统计建模):"基准测的是你的样本,不是你的系统"。变式:无法采样生产时,用第 6.2 节的通用工具解析测试环境流量做形状统计,同样能指导样本构造。
本节要点回顾
- 三个反模式:循环内分配、单一形状、忽视预热——分别用缓冲复用、形状分桶轮换、预热轮修复;
- 防优化手段:结果消费(sink 累加)是基准有效性的保险;
- 两种口径:吞吐型看均值与 GC 占比,尾延迟型看 P99 与分布,测量配置随之不同;
- 参考量级的用法:校验自己的测量,不当架构承诺;
- 样本来自生产分布:基准测的是样本不是系统,"慢十倍"的第一嫌疑是样本形状失真。
补一条基准之外的提醒:测量结果要随契约演进持续复测。消息加一个 repeated 字段、值域形状变了、运行时升了一个版本——任何一个变化都让旧基准失效。工程化做法是把基准挂进 CI 的定期任务,每周跑一次与上次结果比对,劣化超过阈值即报警,让仪器校准从一次性的实验变成常态化的监控。
仪器校准完毕,下一节开始分析器物本身:消息设计里的体积陷阱与速度陷阱,每一条都能用第 3 章的机理推出成因。