7.2 消息设计模式对体积与速度的影响
7.2 消息设计模式对体积与速度的影响
本节摘要:消息的体积与编解码速度主要由设计决定而非运行时决定——字段编号的区间选择、嵌套深度、repeated 的元素形状、字符串冗余,每一类影响都能用第 3 章的编码机理推出。本节把散落的机理收拢成一张消息设计检查清单,并用一个真实消息的逐项优化走完全程。读完你应当在写 proto 文件时就预判它的字节形态,而不是等压测报警。
实验室的第二道工序:器物分析。上一节学会了测量,本节回答"测出来不好怎么办"——答案的大头不在运行时调优,而在于消息当初怎么设计的。
体积四陷阱与机理
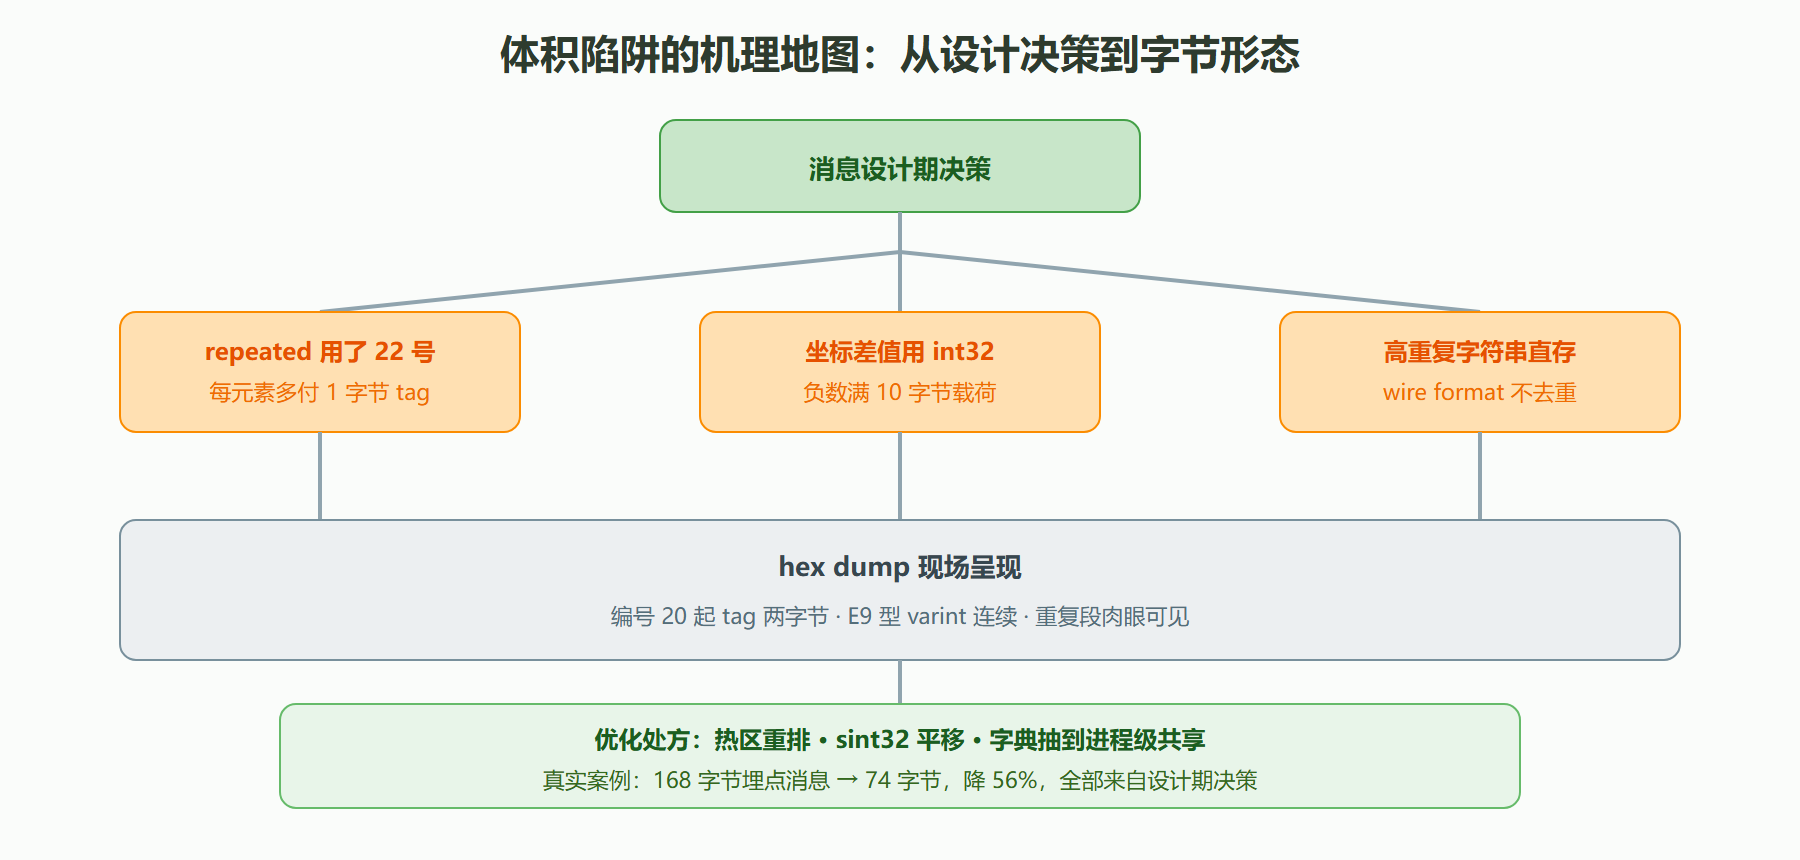
陷阱一:高频字段用冷区编号。 第 2 章立过规矩(repeated 用 1–15),这里补上完整账本:编号 16 起 tag 从 1 字节变 2 字节,对 repeated 字段按元素数放大。一个百万元素的 repeated int32 字段,编号 8 与编号 20 的差距就是整整一兆字节。机理出口:3.1 节的 tag 位运算。
陷阱二:负数进 int 系字段。 一条 -1 的 int32 载荷是 10 字节,一个负数字段占的字节超过其余全部字段之和是真实发生过的案例。机理出口:3.2 节的补码扩展病理。处方:sint 系或业务层平移到非负。
陷阱三:标量嵌套过深。 每层嵌套 message 要付出"tag + 长度前缀"各一组的开销(内外两重)。一个只有两个字段的 message 若被嵌套五层,包装开销可能超过数据本身。机理出口:3.3 节的 LEN 递归与长度前缀。处方:嵌套看语义需要(第 2.3 节的生命周期判据),不为分层而分层。
陷阱四:字符串冗余。 repeated string 里重复出现的相同字符串没有字典压缩——每个元素完整重复。Protobuf 的 wire format 不做任何去重(这是它快的部分原因:无字典维护成本)。高重复场景的处方:把字典抽到消息级(一个 repeated 字典字段加索引引用),或直接评估换专用压缩算法(传输层 gzip、存储层列式压缩)——后者不属于消息设计,但评审时要一起权衡。
速度两陷阱与机理
陷阱五:超大 repeated 的装箱形态。 packed(3.3 节)对数值元素批量省 tag,但解包侧有个隐性成本:packed 载荷必须整段读完才能逐元素展开,无法流式跳过。这对解码不是问题(反正要全解),但对"只读一个字段"的按需访问(第 6.2 节反射路径)是——packed 字段无法跳过只读部分元素。按需访问高频的消息里,packed 与访问模式要做权衡。
陷阱六:map 的隐藏 Entry 层。 map 每个 Entry 是一层完整嵌套(键值各带 tag),大 map 的解码要逐 Entry 分配对象——第 2.3 节"十万键 map 是单字节流风险"的速度面:百万级 map 的反序列化时间与分配压力都远超同体量的 repeated。处方同前:大映射流式化,外层 repeated 包小 message。
图 7-3 体积陷阱的机理地图:从设计到字节的传导链
消息设计检查清单
收拢成 proto 文件评审时可勾的清单:
- 高频与 repeated 字段是否都在 1–15 号?(编号热区)
- 可能出现负数的字段是否用 sint?(负数病理)
- 值域恒大的数值是否考虑 fixed?(varint 反超点)
- 嵌套是否超过语义必要深度?(包装开销)
- 高重复字符串是否评估过字典化?(无去重)
- 大 map 是否流式化拆分?(Entry 层与分配压力)
- 只被按需读取的大字段是否独立成顶层字段?(访问局部性)
- 消息整体是否做过 hex dump 目检?(第 3 章三把尺子的终检)
实战案例:一条监控埋点消息的减脂全程
背景:某监控埋点消息日均 400 亿条,单条 168 字节,带宽与存储成本压力下启动优化。操作:第一步 hex dump 目检——发现三个 repeated 字段占了 140 字节;第二步逐项归因:tag 冷区(两个字段在 22 与 31 号,各元素多付 1 字节)、一个坐标差值字段用了 int32(负数满 10 字节,占单条近 6%)、重复的设备型号字符串(平均每条出现 4 次);第三步逐项修复:编号重排进热区(兼容流程按第 5 章走新编号新字段迁移,旧字段观察期双写)、坐标差值改 sint32(新字段)、设备型号抽到进程级字典由传输层共享(消息里只留索引);第四步复测。结果:单条 168 字节降到 74 字节,降 56%;管道带宽成本同步下降,存储侧节省在列式压缩后进一步放大(基数更小的列压缩率更高)。解读:四项修复全部来自清单的前三条与第六条——没有一个字节是运行时调优省下来的,全部是设计期决策;这也解释了为什么消息评审值得配一名懂数编码机理的人。变式:如果兼容窗口不允许动字段编号,只做 sint 化与字典化也能拿到约三成收益——清单项之间独立可拆。
⚠️ 优化的反向纪律:不要为省字节牺牲演进空间。比如把字段语义塞满每个比特(一条 int32 塞四个字段标志位)是字节级优化、语义级灾难——第 5 章铁律三的违反成本会全部回来。省字节的红线是:字段语义保持原子性。
本节要点回顾
- 体积四陷阱:冷区编号、int 装负数、语义不必要嵌套、高重复字符串无去重——每条有编码机理背书;
- 速度两陷阱:packed 挡按需访问、大 map 的 Entry 层分配压力;
- 八条设计清单:评审时可勾,项间独立可拆、收益可加总;
- 大头在设计期:真实案例 56% 的体积削减全部来自字段与结构决策,无一来自运行时;
- 反向纪律:比特级优化的语义代价不可偿,字段语义保持原子性是红线。
最后补一个体积治理的元方法:给消息做字节预算。团队常见困境是"每个字段加的时候都有理由,加完之后消息不知不觉涨了一倍"——治理方式是把单条消息的字节数当作显式预算(与延迟预算、错误率预算并列的工程指标),新字段入库时评估它对预算的边际占用,超预算走专门的容量评审。hex dump 目检(清单第八项)配合第 6.2 节的通用解析工具,可以把"消息为什么这么大"变成五分钟的例行检查而不是半天的事后考古。预算的数值本身不重要,重要的是让体积从"没人负责的公地"变成"有名有主的资产"。
体积与速度都装进了口袋,最后一节处理实验室的安全角落:恶意消息如何攻击解析器、深度限制怎么配、不信任输入的纵深怎么布。