2.1 VEX 脚本语言
2.1 VEX 脚本语言:逐点并行的主力笔
本节摘要:VEX 是类 C 的编译型表达式语言,在 Attribute Wrangle 里对每个点(或面)各执行一次、自动并行,能以接近手写 C 的速度操纵百万级数据。本节从一行代码写到坡度散布规则,覆盖属性读写、随机与拟合、分支与循环,并给出 VEX 的性能边界。
从一行开始
给山体散布点染上高度渐变色。放一个 Attribute Wrangle 在 Scatter 之后:
@Cd = relbbox(0, @P).y; // 高度归一化 0~1,直接当灰度
视口里点从山脚黑到山顶白。拆开看这行代码的四个零件:
@Cd——@是属性引用,读写都是它;Cd 是颜色;relbbox(0, ...)——输入 0 的整体包围盒,把 P 归一到 0~1;.y——向量取分量;- 整行没有循环——循环是 Houdini 替你做的:Run Over = Points 时,这段代码对每个点各跑一遍。
写规则:只让石头长在陡坡上
换一个更接近真实需求的实验:散布点里只保留坡度 25°~55° 的(太缓是土坡、太陡挂不住石头),并按坡度调尺寸。同一个 Wrangle 改成:
float slope = degrees(acos(clamp(dot(v@N, {0,1,0}), -1, 1))); // 法线与竖直方向夹角 if (slope < 25 || slope > 55) removepoint(0, @ptnum); // 不满足条件:删点 else @pscale = fit(slope, 25, 55, 0.03, 0.12); // 越陡石头越大
运行后视口点数骤减,只剩山腰一圈。注意两件事:第一,筛选本身也是生成规则(呼应 1.4 的"选择必须是规则");第二,@N 前面的 v@——VEX 里向量属性要标类型(v@N、f@、i@、s@ 字符串、p@ 四元数),不标默认按 float 处理会出错。
三件趁手的工具函数
写 VEX 八成时间在用这三个家族:
// 1) 随机:rand 吃 float 出 0~1,稳定可复现(同种子同结果) float r = rand(@ptnum + chi('seed')); // 2) 拟合与区间:把一个量重映射到你想要的区间 @pscale = fit01(r, 0.02, 0.15); // 3) 噪声:连续随机场,3.3 节的主角,先混个脸熟 float n = noise(@P * 0.5 + chi('seed')); @pscale *= 0.5 + n;
chi('seed') 会在 Wrangle 参数面板上自动生成一个可调的 seed 整数参数——把魔法数字变成可调参数,是从脚本到工具的第一步。
逐点之外:元素间访问
VEX 不只能看自己的行,也能查别人的行。
图 2.1-1 一段 VEX 的执行模型
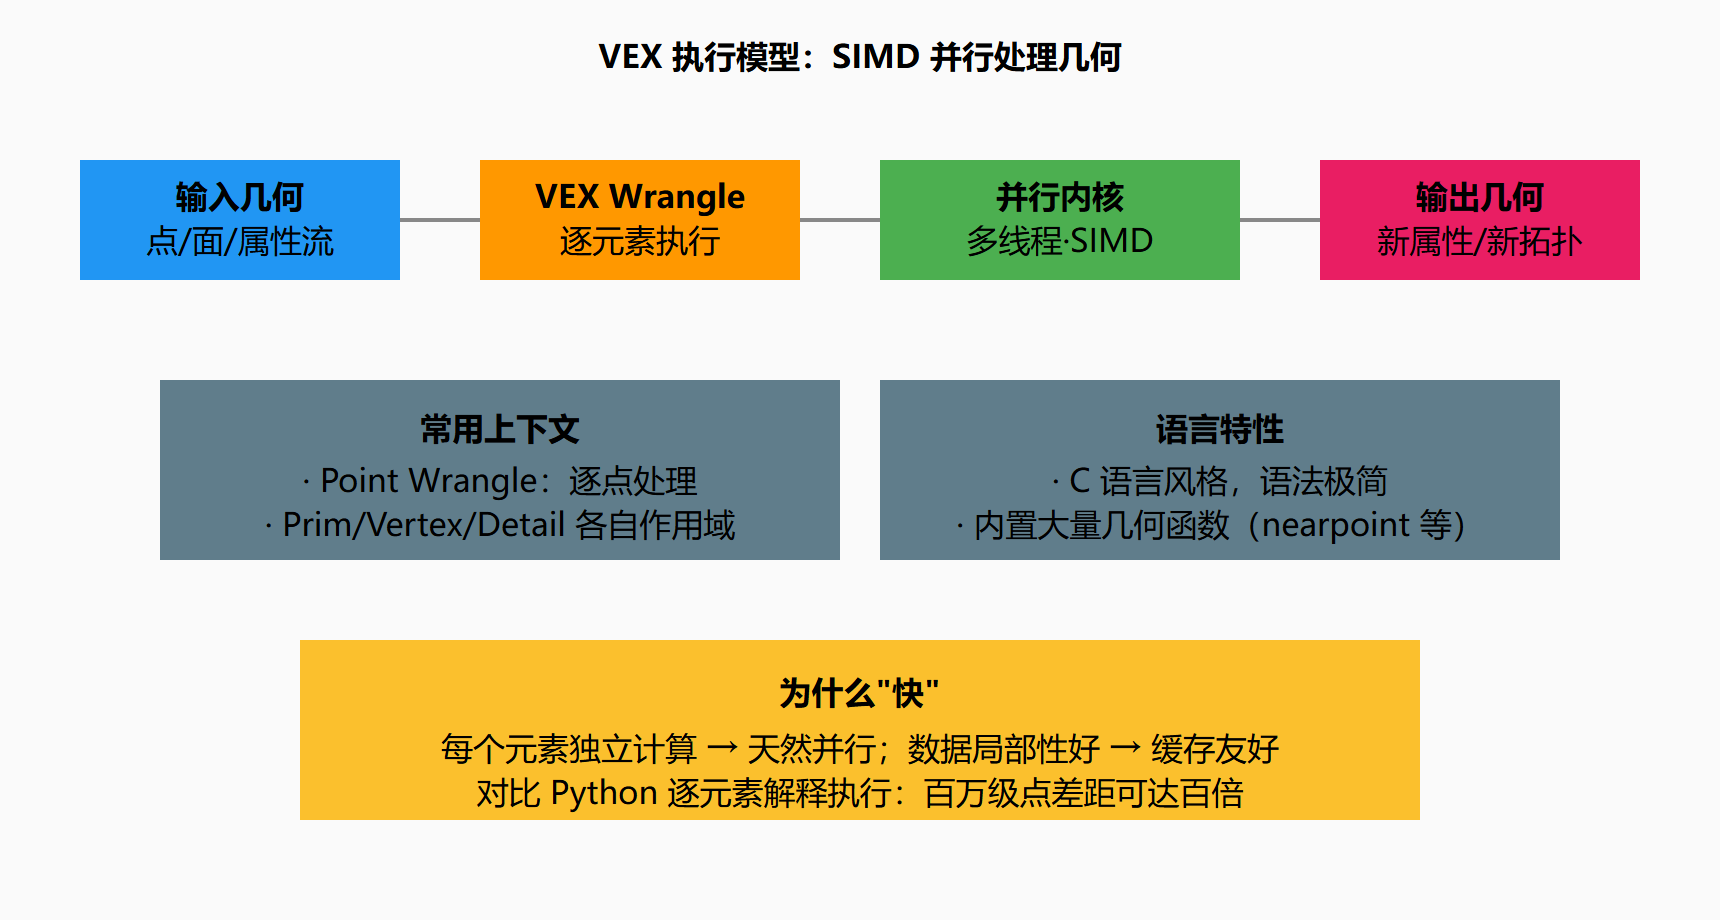
经典实验——每颗石头朝比它高的邻居偏一点(模拟滚落堆积的示意):
int max_iters = 3; for (int i = 0; i < max_iters; i++) { int nears[] = nearpoints(0, @P, 0.4); // 半径内邻居点号数组 vector avg = {0,0,0}; foreach (int pt; nears) { vector p2 = point(0, 'P', pt); // 读别的点的属性 if (p2.y > @P.y) avg += p2 - @P; } if (length(avg) > 0) @P += normalize(avg) * 0.02; }
point(0, 'P', pt) 是跨行查询;nearpoints 建立在空间加速结构上,不致于 O(n²) 全表扫。但注意——每个点都做邻域查询仍然是大头开销,第 8 章优化会回来收拾这类代码。
⚠️ 常见坑:在 Wrangle 里写
@P += @Time;之类依赖时间又依赖自身累积的逻辑。Wrangle 每帧从头求值,不是增量状态机;要累积状态用第 5 章的 Solver。
💡 关键直觉:VEX 的心智模型是数据库的 UPDATE 语句——"对每一行,按公式改若干列"。凡是能这么描述的需求,VEX 都是对的选择。
选型备忘
| 需求特征 | VEX 合适度 | 替代 |
|---|---|---|
| 每点独立计算 | 最佳(SIMD 并行) | — |
| 邻域查询 | 可用但要看数据量 | Point Warp/VDB 类节点 |
| 需要跨节点读写场景 | 不合适 | Python(2.3) |
| 参数间公式 | 杀鸡用牛刀 | HScript 表达式(2.4) |
本节要点回顾
- Run Over 决定循环单位:代码体对每个元素各执行一次,并行免费;
- 属性要标类型:
v@N、f@、i@、s@,不标易踩 float 默认坑; - rand/fit/noise 是出场率最高的三族函数;
- chi()/chf() 参数化让 Wrangle 变成可交接的工具;
- 跨行查询有代价:邻域计算是 VEX 性能的头号账单,留待第 8 章。
下一节把同样坡度规则换成节点外观——VOPs,看两种形态各自的适用面。
延伸:VEX 性能直觉的两条铁律
VEX 是编译型 SIMD 语言,写法差异可以造成十倍以上的性能差。两条铁律值得刻进手指:能向量化的绝不用逐分量;能用一次 nearpoints 解决的绝不在循环里逐个 findattribval 对比。对拍实验:
// 慢: 对每个点遍历全局查找邻居 (O(n^2) 行为) int target = findattribval(0, "point", "cluster", i@my_cluster); // 快: 空间索引一次拿候选 (SIMD 友好) int nbs[] = nearpoints(0, @P, ch("radius"), chi("maxpts")); foreach (int nb; nbs) { if (point(0, "cluster", nb) == i@my_cluster) { v@P += (point(0, "P", nb) - @P) * ch("attract") * 0.5; } }
用 Timing 面板(节点上右键 > Node Info)对比两版的 cook 时间,差距随点数增长而扩大——性能直觉必须靠这种对拍实验养成,而不是背清单。
廕伸:VEX 调试三板斧
// 1. printf 定点侦查: 只打印前5个点, 防止日志洪水 if (@ptnum < 5) printf("p%d v=%v f=%g\n", @ptnum, v@v, f@f); // 2. 把中间值画成颜色, 可视化即调试 @Cd = set(f@weight, 0, 1 - f@weight); // 3. 断言式检查: 早暴露非法数据 if (!(f@weight >= 0 && f@weight <= 1)) error("weight out of range on point %d", @ptnum);
三板斧组合能覆盖九成 VEX 问题:打印看流程、上色看分布、断言守边界。剩下的一成多是类型陷阱(int 除法截断、向量与浮点隐式转换),遇到时优先检查运算两侧类型再查逻辑。