4.1 发射端预编码从线性到非线性
4.1 发射端预编码:从线性到非线性
本节摘要:预编码是发射端在"把数据送上天线之前"做的一次预处理——它根据已知的信道矩阵 H,给每一路数据乘上一个加权向量,让多路信号在空间中尽量互不干扰、或尽量对准目标用户。本节从最朴素的 ZF(零强迫)讲起,到兼顾噪声的 MMSE,再到多用户场景的 BD(块对角化);然后揭示线性预编码的性能天花板,引出 DPC(脏纸编码)与 THP(汤姆林逊-哈拉什玛预编码)两类非线性方案为何能逼近容量界却因复杂度受限;最后落到毫米波最实用的 Kronecker 双维 DFT 基,说明工程如何在"最优"与"可算"之间选落点。
本节目标
阅读完本节,你应当能够:
- 写出 ZF、MMSE、BD 三种线性预编码的设计目标与各自代价
- 解释为什么 ZF 在小区边缘"用力过猛"反而放大噪声
- 说明 DPC/THP 为何属于非线性、为何能逼近容量界但工程落地难
- 描述 Kronecker 双维 DFT 基如何把毫米波预编码拆成"水平角 + 俯仰角"两维可查表
- 用"性能—复杂度"坐标判断一个给定阵列该选哪档预编码
一、预编码在解决什么
接收端面对的是一堆被信道 H 搅在一起的信号:y = H·W·s + n。预编码矩阵 W 就是发射端在 H 已知时,主动把 s 调成 W·s 再发出去,让 H·W 尽可能接近"对角阵"——即每路数据只走自己的子信道、不串到别人那里。这等于把本该由接收端头疼的干扰消除,提前到发射端完成。代价是发射端必须知道 H,而且 W 要随 H 实时变,所以预编码的好坏,直接挂在 CSI 精度(4.3 节)这根线上。
二、线性三兄弟:ZF / MMSE / BD
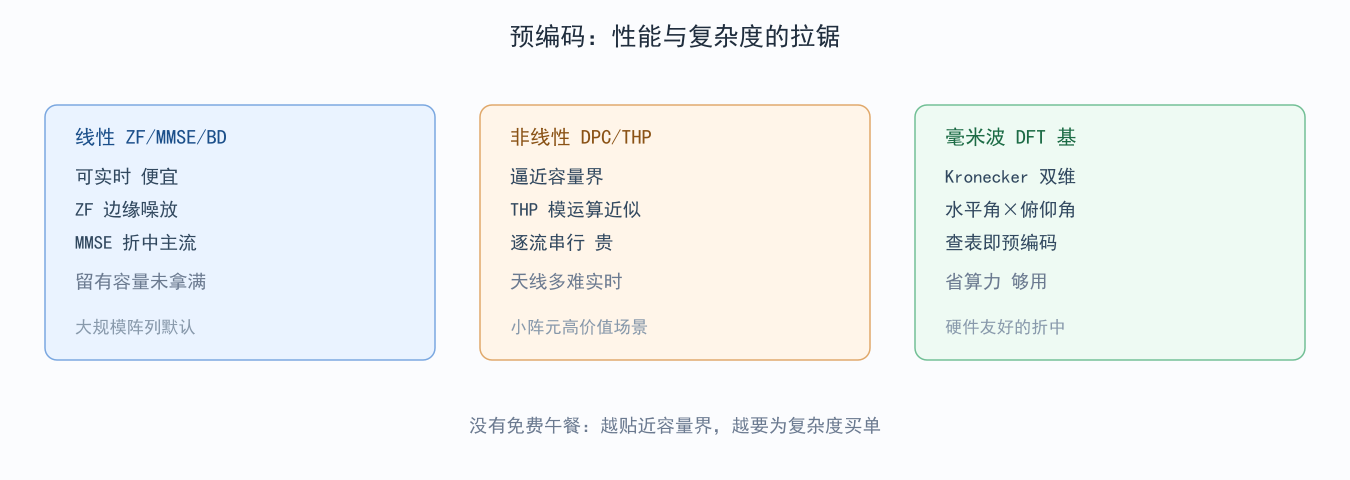
ZF(零强迫) 的目标最直白:让 H·W 严格对角,把用户间、流间干扰彻底逼到零。数学上 W 取 H 的伪逆。问题在它不管噪声——当某子信道增益极低时,伪逆会用一个极大的加权去"硬掰"这条弱路,等于把噪声也同步放大几十 dB。所以 ZF 在信道条件好时干净利落,在小区边缘反而帮倒忙:干扰是消了,信号也被噪声淹了。
MMSE(最小均方误差) 把噪声项拉进目标函数,在"消干扰"和"控噪放"之间取平衡,等效于给 ZF 加了一个正则项。它不再是严格对角,但总体误码率更低,成为绝大多数现网线性预编码的默认选择。一个经验判断:信道好用 ZF 够爽,信道差必须用 MMSE 兜底。
BD(块对角化) 是线性预编码的多用户版本:它把所有非目标用户的信道张成"零空间",把目标用户的数据只投影到这个零空间里,从而让其他用户根本"收不到"本用户的干扰。这是第 5 章 MU-MIMO 干扰消除的数学基础——BD 让"同时服务多用户"在发射端就被预先隔离,而非全压给接收端去分辨。
三种线性预编码的目标与代价可汇总对照:
| 预编码 | 设计目标 | 主要代价 | 典型适用 |
|---|---|---|---|
| ZF | 严格逼零流间/用户间干扰 | 弱信道放大噪声 | 信道条件良好时 |
| MMSE | 消干扰同时控噪放 | 留少量残余干扰 | 现网工程默认 |
| BD | 把数据投影到其他用户零空间 | 需已知他户信道 | 多用户 MIMO 场景 |
用一个 2 发 2 收的具体例子感受 ZF 的代价:假设两条子信道增益分别为 0 dB 和 −15 dB,ZF 为把弱路干扰逼零,会给弱路施加约 15 dB 的发射加权,而这个加权同时把噪声也放大 15 dB——弱路本就信噪比低,再被噪声淹没,反而失真。MMSE 则会主动"放弃"把弱路完全拉平,保留少量残余干扰以控制噪放,总误码率更低。这组对比说明一条工程常识:线性预编码不是"越强越好",而是"刚好够抵消、又不伤噪声"。运维里常看到"信号格满但速率上不去",往往就是 ZF 在边缘把噪声放大、MMSE 没兜底所致,排查时第一反应是看预编码类型与边缘信噪比是否匹配。
三、线性预编码的天花板
线性方案无论怎么调,都受一个根本限制:它只能用"线性变换"去匹配 H,而 H 本身带来的容量界需要更灵活的非线性处理才能贴满。直观地说,当多用户信道高度相关、干扰结构复杂时,线性预编码留着可观的容量没拿到。这就引出非线性预编码。
为什么线性变换够不着容量界?因为多用户容量的来源,是"发射端能针对每个用户将受到的干扰,做随数据变化的预先抵消"——这是一种跨用户、非因果的处理。而线性预编码只能对 H 做一次性的乘法匹配,表达不了"这一路数据要预先抵消另一用户将来会收到的那部分干扰"这种逻辑。换句话说,容量界要求发射端具备"预知并预抵消他人干扰"的表达力,线性矩阵没有这个能力,这正是 DPC 用辅助随机化、THP 用模运算去补上的那块。理解了这点,就不会再问"为何不直接用 ZF 省事"——ZF 省的是算力,丢的是容量界边上那块最肥的性能。
DPC(脏纸编码) 是信息论给出的"神之一手":发射端若已知将叠加到信号上的干扰(对其他用户而言本用户就是干扰),可以不费力气地把它"预先抵消"——就像在写满字的脏纸上写字却能让读者只看到新字。DPC 能逼近多用户 MIMO 的容量界,但它要求发射端做随数据变化的连续辅助随机化,复杂度高到难以实时实现。
THP(汤姆林逊-哈拉什玛预编码) 是 DPC 的可实现近似:它在每一路数据上做模运算把符号约束回星座图内,再施加与 DPC 等价的预抵消。THP 性能接近 DPC、实现比纯 DPC 现实,但仍是逐流串行的非线性处理,天线一多就贵。所以现网里 DPC/THP 主要用于小阵元、高价值场景,大规模阵列基本退守线性。
图 4-1:线性 vs 非线性预编码的取舍空间
四、毫米波的实用骨架:Kronecker 双维 DFT 基
到了毫米波大规模阵列,全数字预编码的射频成本爆炸(第 3 章已讲),工程转向一个巧妙的近似:把阵列响应拆成水平角和俯仰角两个独立维度,每个维度用一组 DFT 波束矢量(离散傅里叶变换基)表示,二者用 Kronecker 积拼成完整预编码。这相当于把"连续角度空间"离散成一张可查表的码本——预编码不再需要实时求解复杂矩阵,而是从表里挑一个最接近最优的波束组合。
好处是算力骤降、天然适配混合波束赋形(第 6 章)的模拟移相器;代价是离散化带来量化误差,波束角度分辨率受阵元数限制。但毫米波本就波束窄、用户少,这种"够用就好"的近似在工程上完全成立。所以你在 5G 基站里看到的预编码,底层往往就是这套 Kronecker DFT 基在查表,而非教科书里那个优美的伪逆矩阵。
DFT 基之所以能用,底层依赖一个物理事实:毫米波信道在"角度域"极度稀疏——用户能量只来自少数几个离开角与到达角,绝大多数 DFT 波束方向上是空的。于是真正有用的预编码只需从码本里挑那几个非零角度方向的波束组合,其余波束天然无关。这种稀疏性让"查表"既省算力又不怎么损失性能:你不需要实时求解完整矩阵,只要知道用户在第几个水平角、第几个俯仰角的波束上即可。反过来,在低频富散射场景角度域不再稀疏,DFT 码本的粗粒度就会明显掉性能——这再次印证"算法选型是场景问题":DFT 基是毫米波的专属红利,不是放之四海皆准的银弹。
五、工程实例:小阵列用非线性、大阵列退回线性
一个真实部署的分工是:微微站配 4 到 8 阵元、服务少数高价值用户,信道相关度高、干扰结构复杂,此时上 THP 能明显吃到容量红利,复杂度也扛得住;宏站配 64 甚至 128 阵元做广覆盖,若上非线性预编码,基带处理时延与功耗直接击穿预算,于是退守 MMSE + BD,把"够用的性能"换成"可规模复制的成本"。这也是产业一贯的务实哲学——算法选型不是追理论最优,而是追"约束下的性价比最优"。把这句话翻译成运维语言就是:评估一套预编码配置值不值,不是看它多接近容量界,而是看它在既定射频预算、时延预算、功耗预算下能稳定兑现几分增益;超出预算的"最优"在网里只是纸面富贵。
⚠️ 常见坑:无脑上 ZF 追求"零干扰"。在小区边缘弱信道处 ZF 会放大噪声几十 dB,误码率反而比 MMSE 差;只有当信道条件整体良好、信噪比充足时 ZF 才是干净利落的选择。
💡 关键直觉:预编码是"把麻烦提前到发射端",但提前得越多(越非线性)越贵;工程落点几乎总在"线性 MMSE/BD + DFT 码本"这个性价比最高、最可复制的区间。
六、常见疑问
为什么 MMSE 比 ZF 在弱信道下更稳?
因为 MMSE 的目标函数里含噪声方差项,它会"宁可留一点残余干扰,也不去放大噪声"。ZF 只看干扰、无视噪声,弱信道下为逼零干扰而施加的巨大加权,把噪声同步放大,等效信噪比反而恶化。所以 MMSE 是带正则化的 ZF,本质是干扰—噪声的折中。
THP 的模运算在干什么?
THP 在发射端对每路符号做模运算(把超出星座图范围的符号"折回"基本区间),使得预抵消后的发送符号仍落在合法星座点内,接收端无需知道辅助随机化也能直接解调。它把 DPC 的"连续辅助随机化"替换成"离散模运算",从而工程可实现,性能接近 DPC 容量。
Kronecker 双维 DFT 基为何适配混合架构?
因为混合波束赋形(第 6 章)的模拟端就是一组移相器,本就只能产生"某个方向"的波束;而 DFT 基的每一列恰好对应一个离散角度的波束矢量,模拟端直接取某一列当移相比特即可,数字端再做粗调。二者在结构上天然同构,所以 DFT 码本成为混合架构的事实标准。
重点提炼
- 预编码=发端先消干扰:W 让 H·W 近似对角,把接收端负担提前消化
- ZF 零干扰但放大噪声:边缘弱信道处反而帮倒忙,MMSE 才是工程默认
- MMSE 是带正则化的 ZF:在消干扰与控噪放之间折中,误码率更低
- BD 是多用户线性预编码:把数据投影到其他用户的零空间,MU-MIMO 基础
- DPC/THP 逼近容量界:非线性、逐流串行、复杂度高,小阵元高价值场景才用
- Kronecker DFT 基是毫米波骨架:水平角×俯仰角查表,省算力适配混合架构
- 算法选型追性价比最优:大阵列退回线性 MMSE/BD,非理论最优
- 预编码挂在 CSI 上:W 随 H 实时变,H 不准则一切归零
下一节转到接收端:当发射端预编码不够完美(或干脆没做),接收端如何用检测把搅在一起的多路重新拆开,又为何越拆越贵。