4.2 接收端检测从ZF到球形译码
4.2 接收端检测:从 ZF 到球形译码
本节摘要:当信号到达接收端,它已经是多路被信道 H 搅拌、被噪声污染后的混合物 y = H·s + n。检测的任务,是从 y 里还原出发送符号 s。本节以理论最优的 ML(最大似然)检测为标杆,揭示其复杂度随天线数指数爆炸的困境;对比 ZF、MMSE、SIC 三类近似检测的代价;重点解释球形译码如何用"只搜信号空间里一个球面内的点"把搜索量从天文数字砍到可计算范围,并说明为何 SIC(逐层干扰抵消)虽有误差传播隐患却是现网最常用的折中。
你能学到什么
阅读完本节,你应当能够:
- 说明 ML 检测为何最优、为何复杂度随天线数与调制阶数指数级增长
- 对比 ZF、MMSE、SIC 三类线性/序贯检测的近似代价与适用边界
- 描述球形译码的核心思想:把全空间搜索收缩到"一个球面内的格点"
- 解释 SIC 误差传播为何是复用系统对 CSI 敏感的根源之一
- 用复杂度—性能坐标判断一个给定规模该选哪档检测
一、检测在解决什么
接收端拿到的是 y = H·s + n。H 是已知的(理想情况下)信道矩阵,s 是待求的发送符号向量(每个元素取自一个有限星座图,如 16-QAM 有 16 个可能值),n 是噪声。检测就是从 y 反推 s。最朴素的解法是直接求逆 ŝ = H⁻¹y,但那忽略了噪声且只适用于方阵满秩——真实 MIMO 是"在噪声里找最接近 H·s 的那个 s",本质是一个带约束的搜索问题。
二、ML:最优但不可承受之重
ML(最大似然)检测 的定义是:遍历 s 所有可能的取值组合,挑出使"H·s 与 y 的欧氏距离最小"的那一组。它给出的误码率在所有检测里最低,是理论最优。但代价是搜索量 =(星座点数)^(流数):16-QAM 单流只有 16 种,两流 256 种,四流 65536 种,八流已经超过 40 亿种。每多一流就乘一个星座点数——这是指数级爆炸。在大规模 MIMO 动辄 16 到 64 流的时代,穷举 ML 在实时性上根本不可能,所以 ML 是"标杆"而非"工具"。
把数字说得更扎心:同样是 16-QAM,单流只需比对 16 种符号,两流 256 种,三流 4096 种,到八流已经超过 42 亿种组合——注意这是"每算一次距离"就要遍历的量。若调制升到 64-QAM,单流就是 64 种,八流直接是 64 的 8 次方、约 2.8×10¹⁴ 种,单帧检测就要做万亿次距离运算,根本不可能实时。这也是为什么"流数越多越想用 ML、却越用不起 ML":最需要最优检测的大规模场景,恰好是 ML 最不可算的场景,逼出了下面所有近似算法。
三、线性检测:ZF 与 MMSE
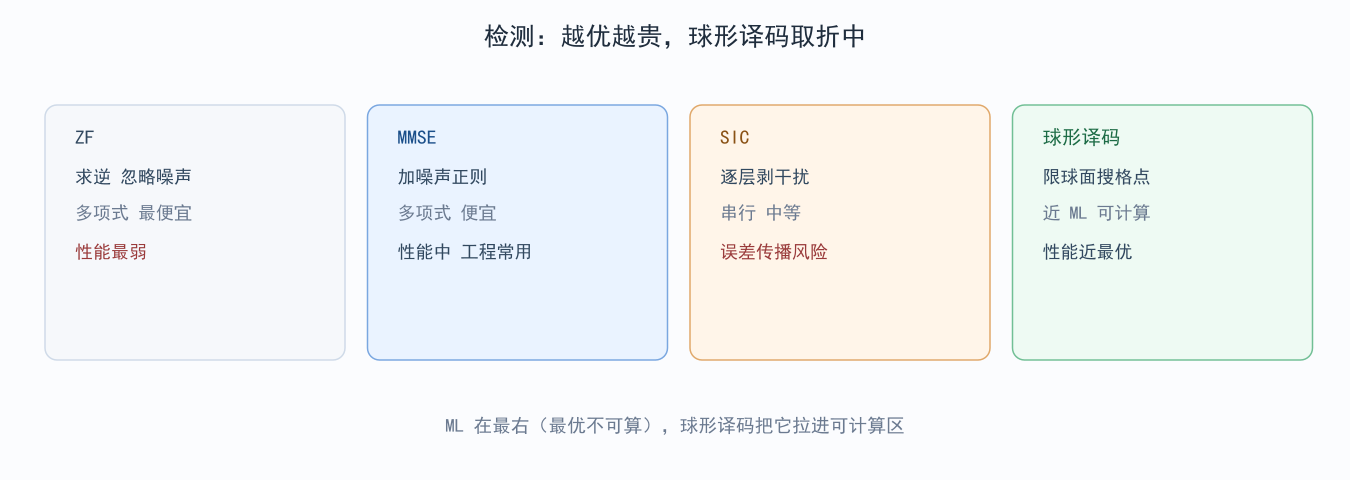
ZF 检测 直接取 H 的伪逆:ŝ = H†·y。实现简单、无搜索,但和发射端 ZF 预编码同源的问题——它无视噪声,弱信道处放大噪声。在检测侧 ZF 的意义更多是"提供一个基线",而非实用方案。
MMSE 检测 在伪逆里加入噪声方差正则,等价于解一个带噪声惩罚的最小二乘问题,误码率明显优于 ZF,复杂度仍是多项式级(主要是一两次矩阵求逆)。它和 MMSE 预编码成对出现,构成线性 MIMO 收发两端最省心的组合——代价是性能停在线性界,离 ML 还有可见差距。
四类检测器的性能—复杂度对照如下:
| 检测器 | 搜索策略 | 性能 | 复杂度 | 典型位置 |
|---|---|---|---|---|
| ZF | 直接求逆 | 最弱 | 最低 | 基线参考 |
| MMSE | 噪声正则求逆 | 中 | 低 | 终端主流 |
| SIC | 逐层干扰抵消 | 中高 | 中 | 复用接收机 |
| 球形译码 | 限球面格点搜 | 近最优 | 中高(平均) | 基站精搜 |
为什么"线性界"和 ML 之间还有可见差距?因为线性检测对每路符号是独立求解的,它不去利用"某一路解出的结果能反过来约束另一路"这种结构化信息;而 ML 是联合搜索所有路的最优组合,天然吃到了符号间的耦合增益。在信道条件好、流间干扰弱时,这种差距不大,MMSE 足够;一旦流间强相关、干扰结构复杂,线性检测"各算各的"的短板就被放大,误码率明显落后于 ML——此时若又受复杂度限制上不了球形译码,就只能在"降流数"和"吞下误码"之间二选一。这再次印证第 3 章的母题:自由度有限,要么用算法(非线性/球形)去抠性能,要么用降流去换可靠。
四、SIC:逐层剥,但有污染
SIC(逐层干扰抵消) 是 V-BLAST(第 3 章)的检测搭档:先解最可靠的一层,把它从接收信号里减掉,再用更干净的信号解下一层,层层推进。它把"同时解 N 层"变成"串行解 N 次单层",复杂度大幅下降,且利用已解层的先验显著改善弱层。问题是误差传播:若某一层解错,减掉的是错误符号,后面所有层都被污染,错误沿层累积——这正是第 3 章说"复用对 CSI 极敏感"的检测侧根源。工程上常用"按信噪比排序先解强层"来缓解,但根因(串行依赖)无法根除。
用一个具体过程体会误差传播:假设四层检测里第二层解错(把符号 A 误判成相邻的 A'),SIC 会把"按 A' 算出的干扰"从接收信号里减掉,可真实信号里混的是 A 造成的干扰,减错的结果让第三、四层看到的"干净信号"里混进了 A 与 A' 的差值噪声。于是第三层在错误的起点上再解,出错概率被放大,第四层雪上加霜。这就是"前层错、后层崩"的链式效应——它解释了为何复用系统宁可让调度器保守降流一次成功,也不赌高流反复重传:流的层数越多,SIC 链条越长,误差传播的风险敞口越大。
图 4-2:检测复杂度的性能—代价光谱
五、球形译码:把天空搜成球面
球形译码(Sphere Decoding) 是 detection 工程里最漂亮的妥协。它观察到:ML 要找的是使 ‖y − H·s‖ 最小的 s,那这个最小距离必然落在某个半径 R 的球内——球外点的距离更大,不必搜。于是搜索从"整个星座空间"收缩到"以 y 为中心、半径 R 的球内格点"。半径选得巧,球内点数从指数级骤降到可枚举量级,性能却几乎等于 ML。
难点在半径 R 怎么定:太大退化成穷举、太小漏掉真解。实际实现用"树搜索"在格点上逐维收紧半径(如 Schnorr–Euchner 枚举),复杂度从硬性的指数变成"平均可算、最坏仍指数"——好在大数信道下最坏情况极少触发,所以球形译码成为追求近 ML 性能又不爆算力的首选。它也是连接"理论最优 ML"与"可落地实现"的桥梁,在 WiFi、蜂窝的接收机里广泛存在。
半径 R 的选取是球形译码的全部艺术:R 太大,球里塞进太多格点,退化回近穷举,复杂度优势尽失;R 太小,真解可能被挡在球外,检测器输出错误结果。工程实现用一个递推技巧动态调整——先从一个较紧的 R 出发,一旦发现球内为空就逐步放大 R,直到搜到至少一个点;搜到后立刻用该点的距离收紧 R,后续搜索只在更小的球里进行。这种"边搜边收口"的策略,让平均复杂度稳定在可计算区,同时保证不漏真解。代价是 R 的调整本身要算,且最坏情况下(信道近奇异、信噪比极低)球仍会胀大——但大数信道下这种坏情况极少触发,所以球形译码成为追求近 ML 性能者的首选。
六、工程实例:复用接收机的现实分层
真实 MU-MIMO 接收机的分工很清晰:终端侧天线少(2 到 4),单纯 MMSE 或低阶 SIC 就够了,省电省算力;基站侧要解几十路用户叠加,且追求近 ML 的吞吐,于是上球形译码配合排序 SIC——先用 SIC 把强层快速剥掉、降维,再对剩余难层用球形译码精搜。这种"粗剥 + 精搜"的两级结构,既控住平均复杂度,又把最棘手的层交给近最优算法。理解了这层分工,就不难明白为何同一套 MIMO 理论,在手机和基站里跑的是完全不同的检测实现。
把这套分工落到排障语言里更有用:当用户投诉"速率忽高忽低、重传多",在基站侧看往往是球形译码在难层(条件数差、信噪比低)频繁退化为高复杂搜索,时延抖动;在终端侧看则多是 MMSE 在弱信道下凭空硬解、误码累积。二者共同指向同一个根因——CSI 质量(4.3 节):信道估不准,检测再巧也是错起点。所以检测算法的选择很少是孤立决策,它和预编码、CSI 是绑定的三联:预编码压不住干扰,检测就累;CSI 不准,预编码和检测一起崩。排障时顺着这条链从 CSI 往上查,比直接调检测参数有效得多。
⚠️ 常见坑:以为 MMSE 检测"够好就不用管 CSI"。检测端再强也救不了 CSI 误差——H 估偏时,MMSE 的正则项基于错误的噪声—干扰比求解,SIC 的"先解强层"排序也会排错,误差传播被放大。检测性能的上限仍由 4.3 节的 CSI 精度封顶。
💡 关键直觉:检测是"把麻烦留到接收端",越想逼近 ML 越贵;球形译码用几何约束把搜索空间从全天空砍到一个球面,是性能与复杂度之间最优雅的那一档折中。
七、常见疑问
球形译码为什么"平均可算、最坏仍指数"?
因为它依赖半径 R 把球内点数压到可枚举。在典型信道(噪声 moderate、格点分布均匀)下,球内点很少,搜索极快;但当信道近奇异(条件数很差)或信噪比极低时,球会膨胀到包住大量格点,退化回近穷举。所以球形译码是"平均情况高效",靠统计性质而非最坏情况保证。
SIC 误差传播能不能根除?
不能根除,只能缓解。缓解手段包括:按后验信噪比排序先解最可靠的层(最强层最先剥、污染最少)、在每层做软输出而非硬判决、或用球形译码替代串行 SIC。但"SIC 链式依赖"的结构性风险始终存在,这也是为什么对 CSI 极度敏感的复用系统要把 CSI 精度当第一优先级。
大规模 MIMO 检测为何更依赖近似算法?
因为流数到了 16、32、64,ML 与球形译码的搜索维度同步爆炸,即便球形译码也难实时。此时工程转向"近似消息传递(AMP)""共轭梯度""基于 Neumann 级数展开"等低复杂度近似检测器,用可控的性能损失换实时性——检测和预编码一样,在大规模场景被迫向复杂度投降。
本章回顾
- ML 最优但指数爆炸:搜索量 = 星座点^流数,是标杆不是工具
- ZF 检测忽略噪声:弱信道处放大噪声,仅作基线
- MMSE 检测加正则:多项式复杂度、工程常用、性能居中
- SIC 逐层剥干扰:复杂度低但有误差传播,复用对 CSI 敏感的根源
- 球形译码限球面搜:把全空间收缩到球内格点,近 ML 可计算
- 粗剥+精搜两级结构:基站侧 SIC 降维 + 球形译码精搜难层
- 检测上限由 CSI 封顶:H 估偏则所有检测退化为错误基准
- 大规模场景被迫近似:AMP/Neumann 级数等低复杂度检测器登场
下一节专门拆开 CSI 这根"总闸门":发射端预编码和接收端检测都依赖 H,而 H 究竟怎么来——TDD 靠互易省反馈,FDD 靠码本量化付出精度代价。