4.3 CSI获取TDD互易与FDD反馈
4.3 CSI 获取:TDD 互易与 FDD 反馈
本节摘要:第 4 章前两节的所有算法——预编码、检测——都建立在一个前提上:收发两端知道信道矩阵 H。本节专门拆这个前提。TDD(时分双工)利用"上下行用同一频段、信道互易"的物理事实,让基站用上行探测信号估出的 H 直接用于下行发射,几乎零反馈开销;FDD(频分双工)上下行频段不同、互易不成立,只能靠终端测下行参考信号、把 H 量化成码本索引回传,必然牺牲精度。最后点出导频开销与信道老化这对贯穿全书工程的永恒矛盾,以及校准如何成为 TDD 互易真正成立的前提。
阅读收获
阅读完本节,你应当能够:
- 解释 TDD 互易性为何能让上行估计的 H 直接服务下行、省掉反馈
- 说明 FDD 为何必须量化反馈、以及量化误差如何限制预编码性能
- 区分"互易性"与"互易性校准":为何硬件不对称会破坏 TDD 互易
- 描述导频开销与信道老化的权衡,以及高速移动场景为何最吃亏
- 用"反馈开销—精度"坐标判断 TDD 与 FDD 各自适合什么场景
一、CSI 是整套算法的总闸门
回看 4.1 和 4.2:预编码要 W=H 的某种逆,检测要 ŝ=H⁻¹y,二者都写满了 H。可以毫不夸张地说,**MIMO 系统 90% 的性能取决于它有多准地知道 H**,剩下 10% 才轮到算法精不精。所以 CSI 获取不是"一个小环节",而是决定第 3 章三种增益能否兑现的"总闸门"。获取方式分两大阵营,根本差异在双工方式。
二、TDD 互易:让上行替下行干活
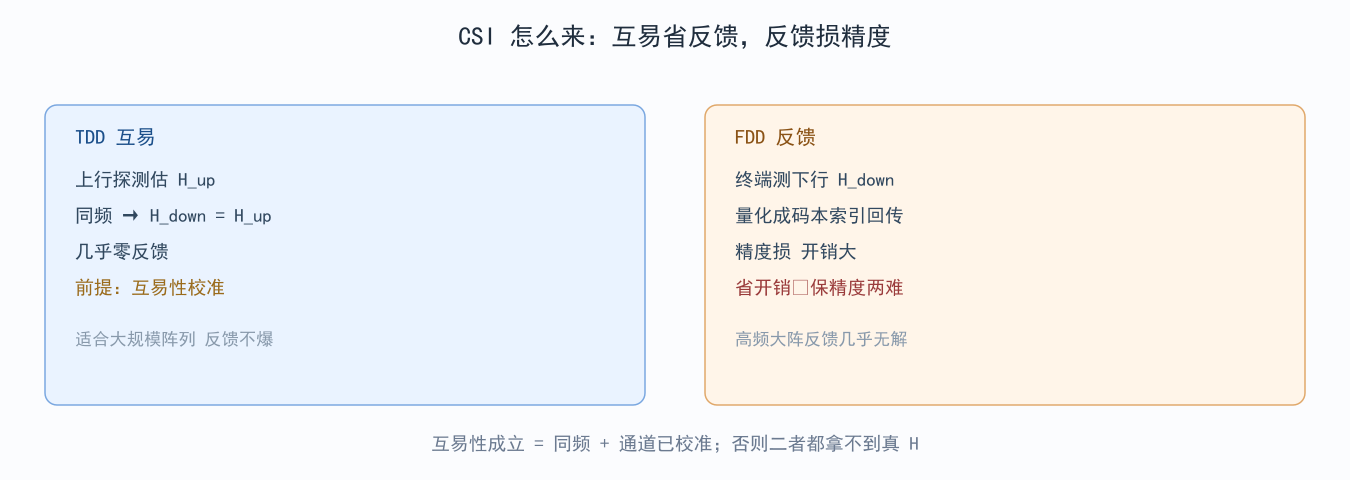
TDD 上下行共用同一频段、靠时隙切换方向。在标定良好的硬件上,同一对天线之间的"上行信道"和"下行信道"是同一个物理信道(互易性):基站收到终端的上行探测(SRS / sounding)后估出的 H_up,因为频率相同,下行用这个 H 发射,电磁波走的仍是同一组路径,H_down ≈ H_up。于是基站不需要终端任何反馈,自己就用上行探测把下行要用到的 H 估出来了——这是 TDD 大规模 MIMO(第 6 章)能上阵元数的关键:反馈开销不随天线数增长,否则 128 根天线各反馈一份完整矩阵会压垮上行。
但互易性有个常被忽视的前提:射频通道对称。基站的发射通道和接收通道经过不同的功率放大器、滤波器、线缆,幅度相位响应并不天然相等;终端亦然。若不校准,H_down 与 H_up 差着一个"收发通道响应比",互易就破了。所以 TDD 互易成立前必须先做互易性校准——估计并补偿收发通道的不对称,让"上行估出的 H"能忠实代表"下行要用的 H"。校准做不好,TDD 大规模 MIMO 的全部增益都建立在沙子上。
用一组具体的不对称数字说明校准有多关键:假设某发射通道比接收通道多 6 dB 增益、且相位偏 30 度(这在未校准的射频里很常见),那么下行实际用的 H 与上行估出的 H 之间就差了这个"6 dB + 30 度"的通道比。预编码按上行 H 算出的波束,下行发射时会被这个偏差扭偏——波束主瓣可能歪出用户方向好几度,阵列增益掉几 dB,等效信噪比直接跌回没赋形的水平。也就是说,互易红利不是"同频自动到账",而是"校准到位才到账";一套 128 阵元的互易系统,只要有几个通道没校准则,整张阵列的赋形精度就被这几根坏通道拖垮。
TDD 与 FDD 在 CSI 获取上的根本差异可汇总对照:
| 维度 | TDD 互易 | FDD 反馈 |
|---|---|---|
| 获取方式 | 上行探测估 H,下行直接复用 | 终端测下行 H,量化回传 |
| 反馈开销 | 近乎零,不随天线数增长 | 随天线数增长,占上行资源 |
| 精度 | 取决于校准质量 | 受码本量化损失 |
| 高速移动 | 稳(无反馈链老化) | 吃亏(反馈链超相干时间) |
| 大规模阵列 | 天然友好 | 反馈近乎无解 |
三、FDD 反馈:不得不量化的无奈
FDD 上下行频段不同(如上行 1.9 GHz、下行 2.1 GHz),信道在不同频率上不互易——下行 H 和上行 H 是两回事,基站没法用上行探测推下行。于是只能让终端测下行参考信号得到 H_down,再想办法告诉基站。终端若回传完整矩阵,开销随天线数爆炸且占上行资源;现实做法是把 H 投影到一套预定义码本(第 7 章 Type I / Type II),只回传"选了码本里第几个向量"的索引(PMI)。
量化的代价是精度:码本永远只是 H 的粗近似,索引越粗、反馈越省,预编码指偏越狠。高频段、大阵列下信道维度高,码本要很密才能逼近,但密码本反馈又变重——FDD 因此陷入"省开销 vs 保精度"的结构性两难。这也是为什么毫米波(本来阵列就大)更偏 TDD:FDD 在那个规模下反馈几乎无解。
把码本量化说得更具体:假设真实最优预编码指向水平角 12.3 度,而码本里只有 10 度、15 度两档可选,终端只能回传"选 15 度"——波束因此偏了 2.7 度。在宽波束低频场景,2.7 度偏差微不足道;但在毫米波窄波束(半功率宽度可能只有 5 度)场景,2.7 度偏差直接让主瓣歪出用户,增益塌掉一大半。所以同一套码本,在低频只是"轻微指偏",到毫米波就是"指不到人"——这正是 FDD 在毫米波规模下几乎无解的量化层面原因:要保精度,码本得细到反馈扛不住;要省反馈,精度掉到链路起不来。
图 4-3:TDD 互易 vs FDD 反馈
四、导频开销与信道老化:永恒矛盾
无论是 TDD 上行探测还是 FDD 下行参考信号,都需要导频(已知发送符号) 让接收端做信道估计——导频占用的时频资源就是"开销"。导频越密,估计越准;但导频越密,能传数据的资源越少,频谱效率下降。这是第一对矛盾:估计精度 vs 开销。
第二对矛盾是信道老化:H 不是静止的,它随移动、绕射实时变。你刚估完的 H,传给预编码用的时候可能已经变了(尤其高速移动、高频段相干时间短)。反馈链路还有时延,FDD 的"终端测→回传→基站用"整条链一旦超过相干时间,H 就过期。所以第 3 章高铁场景为何只能靠开环分集——不是不想要 CSI,是 CSI 在 300 km/h 下根本来不及用。这两对矛盾共同决定了:信道越不稳、移动越快,闭环 MIMO(依赖 CSI)越吃亏,开环方案越稳。
用相干时间把"老化"说成可感知的数字:在 2.6 GHz 载波、300 km/h 高铁场景下,信道的相干时间只有几毫秒;而一段"终端测下行参考信号 → 量化 → 回传基站 → 基站调度用"的 FDD 反馈链,端到端往往要十几到几十毫秒。也就是说,等你把 H 反馈回去,信道早已翻了好几番,用上的 H 是十几毫秒前的旧信道——对高铁这种场景,这等于拿着过期的地图导航。TDD 互易之所以在高速下仍比 FDD 稳,正因为它不需要这条反馈链:上行探测与下行发射间隔极短(同一帧内的时隙切换),H 几乎没老化。所以"选 TDD 还是 FDD"在高速移动场景几乎不是选择题——TDD 互易用"零反馈"换掉了 FDD 那条必然过期的反馈链。
五、工程实例:TDD 大规模 MIMO 的校准日常
真实 5G 大规模 MIMO 基站几乎都跑 TDD(如 2.6 GHz、3.5 GHz 的上下行同频时分),正是为了吃互易红利。但运维里"互易性校准"是开机必做项:基站上电后用内部环路把每通道的收发响应测一遍、算出不对称补偿系数,存进校准表;运行中还会周期性复校,因为温度漂移会让通道响应慢慢变。一旦校准失效(如某通道功放老化未及时发现),互易破掉,下行预编码指偏,表现为"信号格满但吞吐暴跌"——这和第 3 章说的复用悖论同源。运维排障时,校准状态常是第一个要查的开关。把这句话落成巡检清单就是:大规模 MIMO 基站开通必跑互易性校准、运行期周期复校、温度骤变或通道告警后即时复校;任何"信号格满但吞吐掉档"的投诉,先验校准表再谈算法参数——这条经验能省掉大量无效调参。
⚠️ 常见坑:以为 TDD 天然就有完美 CSI。"互易性"是物理事实,但"互易性校准"是工程前提——收发通道不对称不补偿,上行估出的 H 与下行要用的 H 差一个通道响应比,预编码照样指偏。互易红利要先靠校准买来。
💡 关键直觉:CSI 是 MIMO 的总闸门,获取方式由双工方式决定——TDD 用互易换"零反馈但需校准",FDD 用反馈换"精度损与开销"。选 TDD 还是 FDD,本质是选"校准负担"还是"反馈负担"。
六、常见疑问
互易性和互易性校准是一回事吗?
不是。互易性是物理层事实(同频双向信道相同);互易性校准是硬件层操作(补偿收发射频通道的不对称响应)。没有校准,互易性在物理上成立,但在你的设备里"测到的上行 H"和"该用的下行 H"仍差一个通道比,等于互易性在你的系统里没生效。校准是让物理互易性真正可用的钥匙。
FDD 能不能也做大规模 MIMO?
能,但代价高。FDD 大规模 MIMO 必须靠"压缩反馈""基于机器学习的信道外推""角度域稀疏反馈"等先进技术把反馈压下来;或利用信道的"角度域稀疏性"只反馈少数显著路径。这些方案比 TDD 互易复杂且仍有精度损失,所以产业里大规模 MIMO 几乎默认 TDD,FDD 多用于低频广覆盖(阵元少、反馈扛得住)。
导频开销有没有下限?
有理论下限:要估 Nt 根发射天线对应的信道,至少需要 Nt 个正交导频维度(时/频/码),否则各天线信道不可分——这正是第 6 章"导频污染"的根源:太多用户抢同一组正交导频,彼此污染。所以导频开销随用户数和天线数增长是结构性的,省不掉只能优化调度。
要点串联
- CSI 是总闸门:MIMO 九成性能取决于 H 有多准,算法只占零头
- TDD 互易省反馈:同频 H_down≈H_up,上行探测直接服务下行
- 互易需先校准:收发通道不对称不补偿,互易在设备里失效
- FDD 被迫量化反馈:码本索引回传,精度损、开销大、省↔精两难
- 毫米波偏 TDD:大阵下 FDD 反馈几乎无解
- 导频开销 vs 精度:导频越密越准、越占资源,结构性矛盾
- 信道老化坑高速:反馈链超相干时间则 H 过期,闭环吃亏
- 选 TDD 还是 FDD:选校准负担,还是选反馈负担
第 5 章把"知道 H 之后怎么服务多用户"展开:MU-MIMO 如何利用 BD 零空间让多用户互不干扰,调度器又如何在用户间切分第 3 章那笔自由度预算。