5.2 用户配对与调度算法
5.2 用户配对与调度算法
本节摘要:5.1 说清了"多用户能并行的前提是信道正交",这一节回答"怎么在几十上百个候选用户里挑出一组彼此正交、且总吞吐最高的人"。核心是两件事:调度(决定每个时隙服务谁)与配对(决定把哪些人放进同一 MU 组合)。本节讲清比例公平(PF)如何在吞吐与公平间权衡,贪婪配对如何用"每次挑最正交的下一个"逼近最优,以及为什么"穷举所有配对组合"会随候选用户数组合爆炸、逼出启发式算法。
本节地图
阅读完本节,你应当能够:
- 说明比例公平(PF)调度的核心思想,及其为何兼顾吞吐与公平
- 描述贪婪配对的步骤,解释它为何是"次优但可行"的实用解法
- 解释配对复杂度为何随候选用户数组合爆炸
- 区分"正交度门限筛除"与"最优配对搜索"两阶段工作的关系
- 用"吞吐—公平—复杂度"三角判断一个调度器设计的取舍
一、调度在决定"服务谁"
基站每个时隙的时频资源有限,不能服务所有用户。调度器要决定:这一刻把资源给谁?若只追总吞吐,会永远服务信号最好的那几个用户,边缘用户永远饿死;若只追公平,总吞吐会被差用户拖垮。这是个经典的多目标权衡,5G 调度器用比例公平(PF) 来折中。
PF 的核心很巧妙:它给每个用户算一个"瞬时速率 / 历史平均速率"的比值,优先服务比值最高的用户。信号好的用户瞬时速率高、但历史平均也高,比值未必最高;信号差的用户一旦信道变好,瞬时速率相对自己的历史平均骤升,比值反而领先、被优先服务。于是好用户不会被饿死、差用户也有机会——既保证总吞吐接近最优,又维持长期公平。这把"公平"从"均分资源"变成"按机会均分",是无线通信调度最经典的智慧。
三种基础调度哲学的差异可汇总对照:
| 调度策略 | 目标 | 总吞吐 | 公平性 | 适用 |
|---|---|---|---|---|
| 轮流服务 | 资源均分 | 差 | 高 | 教学示例 |
| 最大载干比 | 只顾吞吐 | 高 | 差(饿死边缘) | 纯吞吐场景 |
| 比例公平 | 机会均分 | 近最优 | 中高 | 现网默认 |
二、配对:从子集里挑组合
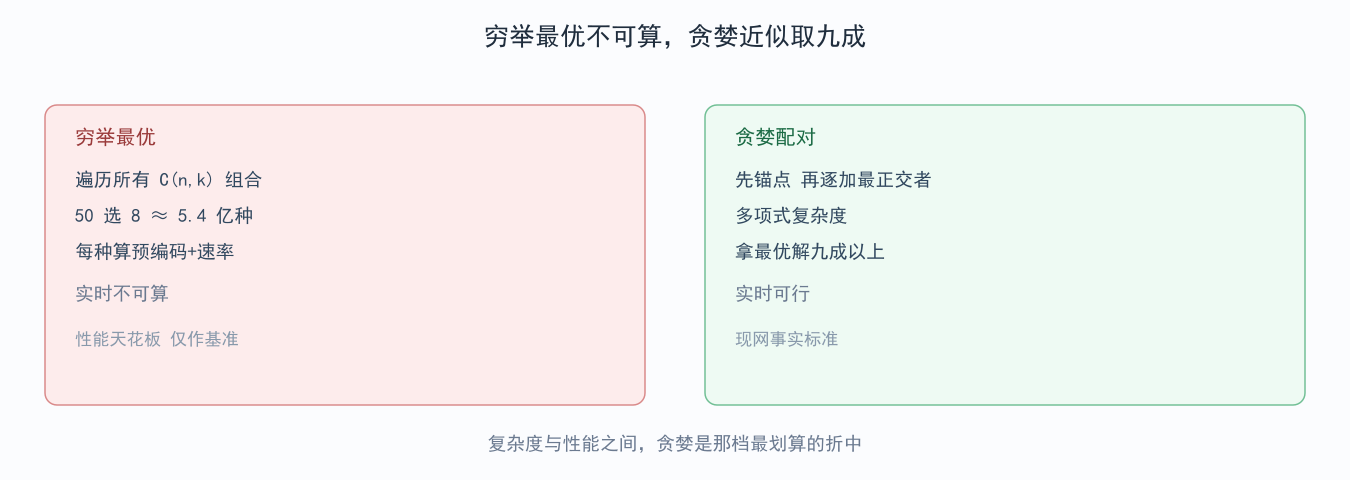
配对是调度的下游:在"已通过正交度门限"的候选子集里,挑出一组能同时服务、且总吞吐最大的用户组合。理想解法是穷举所有组合、对每组算可达和速率、取最大——但组合数是 C(n, k)(从 n 个候选挑 k 个同时服务),随 n 和 k 指数增长。一个小区若有 50 个候选、要挑 8 个同时服务,组合数约 5.4×10⁸,每个还要算一次预编码与速率,实时根本算不过来。这就是配对复杂度的结构性瓶颈。
三、贪婪配对:次优但可行
工程上几乎都用贪婪配对逼近:先挑一个"信道条件最适合当锚点"的用户(如信噪比高、信道方向典型),再逐个考察剩余候选,每次挑"与已选组合信道最正交(IUI 最小)、且能带来最大边际吞吐"的那一个加入,直到达到可服务用户数上限或边际增益可忽略。它不保证全局最优,但每次只做"局部最优的下一步",复杂度从组合爆炸降到多项式,实测吞吐通常能拿到最优解的九成以上。
贪婪配对的质量高度依赖"锚点怎么选"和"正交度怎么度量"。常见做法是用信道向量的夹角(或相关矩阵)做快速内积筛选:先排除明显相关的(呼应 5.1 门限),再在剩余里按夹角最大贪婪叠加。这套"先门限筛、再贪婪配"的两段式,正是现网调度器最普遍的实现骨架。
把贪婪配对走一遍具体步骤更直观:假设候选池甲、乙、丙、丁四人,信道方向分别近似 10 度、15 度、80 度、95 度。先选甲(信噪比高、方向典型)当锚点;考察乙与甲夹角仅 5 度(高度相关),跳过;丙与甲夹角 70 度(近乎正交),加入组合;丁与甲夹角 85 度、且与丙夹角 15 度(和丙相关),但丁与甲仍正交,若组合只要求两两正交、丁与丙的相关在容忍内,则丁也可加入。最终组合可能是甲+丙(+丁),乙因太靠近甲被排除。这个"每步只挑当下最正交的下一个"的过程,复杂度只是线性的几次内积,却往往拿到接近最优的总吞吐——它把原本要算几亿种组合的问题,压成几次向量点积,正是工程智慧的缩影:不追全局最优,追"每一步都不傻"的近似最优。
图 5-2:配对复杂度与贪婪近似
四、正交度门限与最优搜索的两段式
把两件事分清很有必要:第一段是"正交度门限筛除"(5.1),用低复杂度的内积/角度快速把明显相关的用户踢出,缩小候选池;第二段才是"配对搜索",在缩小后的池里用贪婪(或受限穷举)挑组合。门限设得越合理,第二段搜索空间越小、越不容易掉进坏组合。二者是上下游:门限是粗筛、配对是精挑,合起来构成调度器的决策链。
一个常被忽视的点:门限和配对都要随 CSI 实时更新。用户移动、转身、被遮挡都会改变信道相关性,上一时隙的正交组合这一时隙可能已高度相关——所以调度器每个周期重算,而非一配了之。这又回到第 4 章的母题:CSI 不准,相关性判断就错,配对自然配错。调度器的智能,建立在 CSI 的准确之上。
把这段决策链落到排障语言里:当用户投诉"速率忽高忽低、MU 配对时好时坏",第一反应不是调配对算法本身,而是查 CSI——相关性判断错了,门限筛和贪婪配都会在错误的输入上做正确的事,结果自然是坏组合。一个实用的排查顺序是:先看 SRS/参考信号质量(CSI 来源,第 4、7 章),再看来波角估计算法是否把用户方向算偏,最后才怀疑门限与配对参数。这条"先查 CSI、再查算法"的链路,和检测侧排障(4.2 节)同源——它们都指向第 4 章那根总闸门。调度器再聪明,喂给它错误的信道,它也只能配出错误的组合。
五、工程实例:高密场景调度器的真实取舍
某商场小区有 80 个活跃用户,基站 64 阵元。调度器每毫秒做一次决策:先用门限筛掉彼此相关系数超 0.7 的用户(约剔掉三成),在剩余 ~56 人里以 PF 定优先级,再贪婪配出最多 8 个同时服务的 MU 组合。高峰时段为拉总吞吐,门限略放宽、PF 的公平权重略降;边缘用户多的时段则反向收紧,保单用户可靠。运维平台上看的不是"配了几个用户"这个绝对值,而是"配对成功率""IUI 残留功率""PF 公平性指数"三条曲线——它们才是判断调度器有没有在吞吐与公平间站对位置的依据。
把这三条曲线翻译成排障动作:配对成功率持续低,说明候选用户普遍高度相关(场地同向人群多)或门限过严,优先查用户分布而非算法;IUI 残留功率偏高,说明 BD 预编码没压干净,根因多半在 CSI 不准(回第 4 章);PF 公平性指数掉档,说明公平权重被吞吐目标压太低,边缘用户被饿,应上调公平权重。三条曲线各自指向不同环节,排障时按曲线分层定位,比蒙头调参数高效得多——这再次印证"先看数据、再调算法"的方法论,而这套方法论的更上游,是始终盯住第 4 章那根 CSI 总闸门:调度器的每一步聪明,都建立在信道估计准确这个前提之上,数据错了,算法再优也只是把错误放大得更整齐。
⚠️ 常见坑:用"同时服务的用户数"衡量 MU-MIMO 好坏。用户数多不代表吞吐高——若为了多塞人放宽门限,IUI 残留暴涨,单用户速率崩塌,总吞吐反而可能低于少配几个干净用户。真正的指标是配对后的小区和速率与 IUI 残留功率,而非用户数本身。
💡 关键直觉:调度器是小区吞吐的操盘手,它在"吞吐—公平—复杂度"三角里找落点;贪婪配对用"次优但实时"换来了 MU-MIMO 的可落地,穷举最优只是纸面基准。
六、常见疑问
比例公平为什么比"轮流服务"聪明?
轮流服务(纯公平)让差用户长期占用资源、总吞吐惨淡;纯最大载干比(纯吞吐)让好用户霸屏、差用户饿死。PF 用"瞬时/历史平均"比值,让差用户在其信道变好的短暂窗口被优先服务,既保总吞吐接近最优、又给差用户按机会均分资源。它把公平定义成"机会公平"而非"资源均分",是吞吐与公平兼得的关键。
贪婪配对会漏掉真正最优组合吗?
会,这是它"次优"的本质。贪婪是局部贪心,可能先选了一个看似好的锚点,导致后面无法凑出全局更优的组合。但实测中这种损失通常很小(最优解的九成以上),且复杂度从指数降到多项式,实时性收益远大于那点性能损失。工程上也有"多锚点重启贪婪"等改进,跑几次取最好,进一步逼近最优。
配对和预编码谁先谁后?
通常先配对、再对配好的组合做 BD 预编码(第 4 章)。因为 BD 零空间的结构依赖于"这一组合里有哪些用户",用户组合定了,零空间才定。但更高级的联合优化会把"配对"和"预编码权值"一起迭代求解——代价是复杂度更高,只在小规模或离线规划里用,实时调度仍以"先配后编码"为主。
一节小结
- PF 调度兼顾吞吐与公平:用瞬时/历史平均比值,把公平变成机会均分
- 配对=从子集挑组合:目标总吞吐最大,但组合随候选数爆炸
- 贪婪配对次优但可行:先锚点再逐加最正交者,拿最优九成以上
- 复杂度组合爆炸:50 选 8 约 5.4 亿种,穷举仅作基准
- 两段式:门限筛 + 贪婪配:粗筛缩池、精挑定组合,构成决策链
- CSI 驱动重算:用户移动改相关性,调度每周期重配,根在 CSI 准
- 用户数多≠吞吐高:IUI 残留才是真指标,门限放宽反伤总吞吐
- 调度器是吞吐操盘手:在吞吐—公平—复杂度三角找落点
下一节把这套能力固化进标准:5G NR 用 Type I / Type II 码本与 SRS 反馈,让终端把多用户信道高效报给基站,把本章的配对从"理论可能"变成"标准可实现"。