6.2 混合波束赋形架构设计
6.2 混合波束赋形架构设计
本节摘要:6.1 说大规模下简单算法就够,但"够"的前提是几百根天线都接了射频链路——全数字架构意味着每根天线一套完整射频(含 DAC/ADC、功放、移相),64 阵元就是 64 套,功耗成本爆炸。混合波束赋形是产业的回答:用"少量数字通路 + 大量模拟移相器"两级处理,把射频成本压下来。本节对比全连接与子连接(部分连接)两种结构,用 URA(均匀矩形阵列)8×8=64 阵元讲子阵如何划分,说明工程如何在性能与射频成本间取平衡——这正是第 3 章"模拟/数字/混合三角张力"的落地。
读前必看(上)
阅读完本节,你应当能够:
- 解释为什么全数字大规模阵列在功耗成本上不可承受,引出混合架构
- 区分全连接与子连接(部分连接)混合结构及其自由度差异
- 用 URA 8×8=64 阵元说明子阵划分方式
- 联系第 3 章三角张力,说明混合架构是"成本—灵活性"的落点
- 判断给定阵元数与功耗约束下该选哪种连接结构
一、为何不能全数字:射频爆炸
回顾第 3 章的架构三角张力:全数字最灵活(每天线独立基带加权、可多波束),但每路一套完整射频。到了大规模 MIMO,这个代价从"几套"变成"几十上百套"——64 阵元的全数字基站,光射频前端功耗就以百瓦计、物料成本以千元计,体积散热在 AAU(有源天线单元)里不可接受。所以产业几乎一致转向混合:数字端只做"粗调"(少量通路),模拟端用便宜的移相器做"细扫"(大量阵元),两级合力逼近全数字性能、成本却骤降。
混合的本质是把预编码拆成两层:数字预编码(在基带、维度=射频通路数,较小)负责多用户/多流间的粗隔离,模拟波束赋形(在射频移相器、维度=阵元数,很大)负责把能量聚焦到角度。第 4 章的 Kronecker DFT 基(水平角×俯仰角)正是为模拟端查表而生的骨架。
把混合架构的"两级"和第 3 章三角张力对应起来更清晰:数字端那"少量通路"决定了多用户隔离的上限——通路越少,能同时干净服务的用户数越少,但每路射频成本省;模拟端那"大量移相器"决定了角度聚焦的精度——移相器越多、相位越细,波束越准,但硬件与校准越重。所以混合架构不是"全数字的廉价版",而是把第 3 章"性能—成本—灵活"三角重新切在"数字级+模拟级"两个尺度上:数字级管用户间、模拟级管角度内。理解这一层,才不会把混合波束赋形误读成"退而求其次的妥协",它是大规模下唯一能平衡三角的现实结构,全数字在功耗上根本走不通。
二、全连接 vs 子连接
混合架构按"模拟端怎么连"分两类,构成功率、成本、自由度的新三角:
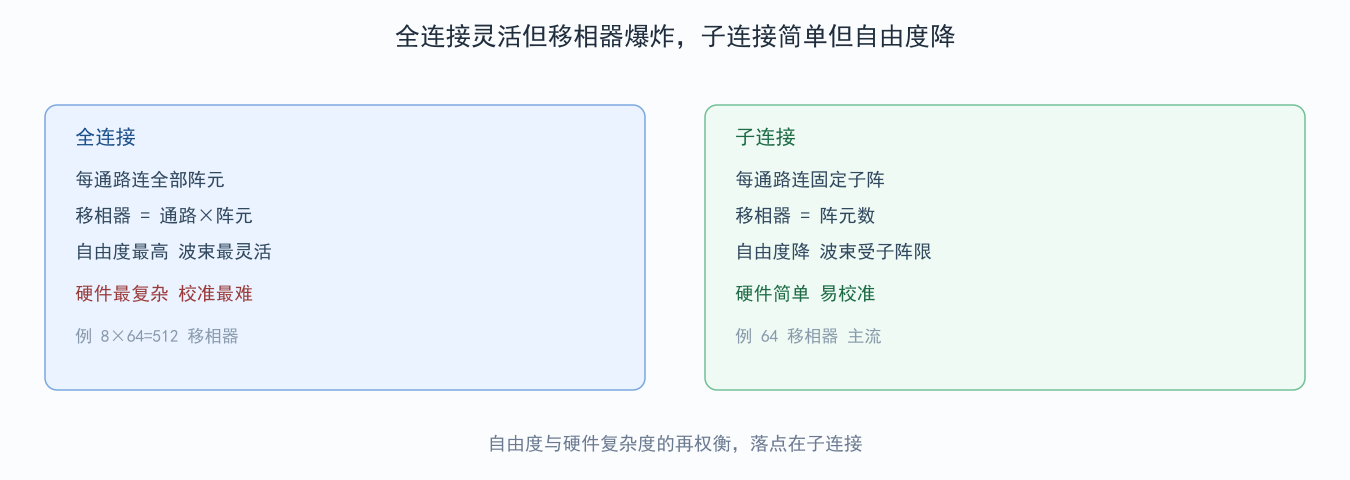
全连接(fully-connected):每个射频通路通过移相器连到所有阵元。自由度最高——任意通路能驱动任意阵元的任意相位,波束最灵活,最接近全数字;但移相器数量 = 通路数 × 阵元数(如 8 通路 × 64 阵元 = 512 个移相器),硬件最复杂、损耗最大、校准最难。
子连接(partially-connected / 子阵):每个射频通路只连到一个子阵(一组固定阵元),通路间不交叉。移相器数量 = 阵元数(64 个),硬件简单、损耗低、易校准;代价是自由度下降——波束只能在该子阵内形成,跨子阵的精细赋形做不到,边缘波束灵活性受限。工程上这是最主流的折中。
子连接之所以成为主流,除了硬件简单,还因为它把校准复杂度从"全连接的全对全"降到"每子阵内部"——每个子阵只需校准自己那组通道,互不牵连,整阵校准可并行、可局部复校,这对几十子阵的大规模阵列是决定性优势。全连接要一次性校准所有"通路×阵元"的交叉响应,参数量与互耦复杂度都高一个量级,量产与运维都头疼。所以"子连接主流"不单是省移相器,更是省校准——而校准(6.3 节)恰恰是大规模阵列最硬的瓶颈之一,谁能把校准做简单,谁的结构就赢。这再次印证架构选择是"牵一发而动全身"的系统决策,不是单看波束灵活度。
图 6-2:全连接与子连接的结构差异
三、URA 8×8=64 的子阵划分
工程上阵元常排成 URA(均匀矩形阵列),如 8 行 × 8 列 = 64 阵元。子连接结构下,这 64 阵元被切成若干子阵,每个子阵由一路射频通路驱动。常见切法:切成 8 个子阵(每子阵 8 阵元,如一列 8 个),则 8 路射频通路各管一列;或切成 4 个子阵(每子阵 16 阵元),4 路通路各管一个 4×4 块。子阵越大,单路驱动阵元越多、波束越窄越聚焦,但跨子阵灵活性越低;子阵越小,灵活性越高、但通路数越多、成本回升。
子阵划分是混合架构最常被调的旋钮:低频广覆盖可用较大子阵(少通路省成本),毫米波窄波束需较小子阵(多通路保灵活)。它把第 3 章"模拟/数字/混合三角张力"落到了"子阵尺寸"这一个可量化参数上——架构选择不再是抽象哲学,而是"子阵切几乘几"的具体决策。
用一个具体切法感受子阵尺寸的影响:同样 64 阵元 URA,若切 4 个子阵(每子阵 4×4=16 阵元),需 4 路射频通路,每个子阵内波束只能在 4×4 的口径内形成,波束较宽、跨子阵无法协同;若切 16 个子阵(每子阵 2×2=4 阵元),需 16 路通路,单子阵口径小但整体可拼出更精细的波束方向,灵活度升、成本也升。工程折中常落在 8 子阵(每列 8 阵元、8 路通路)附近——既让每路驱动一列(波束在水平向有一定指向性),又把通路数控制在可承受范围。这个"几乘几"的选择,本质是前面三角张力在硬件上的最终落点,规划阶段就要按频段与覆盖目标定,而非出厂后随意改。
两类结构的工程取舍可汇总:
| 维度 | 全数字 | 全连接混合 | 子连接混合 |
|---|---|---|---|
| 射频通路 | N(全) | 少(数字端) | 少(数字端) |
| 移相器数 | 0 | 通路×阵元 | 阵元 |
| 自由度 | 最高 | 高 | 中 |
| 功耗成本 | 爆炸 | 高 | 中(主流) |
| 校准难度 | — | 最难 | 易 |
四、工程实例:AAU 里的子连接现实
现网 5G AAU(有源天线单元)几乎都是子连接混合:一个 64 阵元 URA 切 8 个子阵、8 路射频通路,每路带一组移相器。数字端做多用户粗隔离(呼应第 5 章 MU 配对),模拟端把能量按 DFT 码本聚焦到用户角度(呼应第 4 章)。这种结构让整块 AAU 功耗控制在几十瓦、成本可控、校准可工程化。若强行全数字,同样 64 阵元功耗翻数倍、AAU 根本装不上铁塔。所以"混合 + 子连接"不是技术退而求其次,而是让大规模 MIMO 能真正商用的唯一现实路径——它把第 3 章那张三角张力图,焊进了每块基站硬件里。
补充一个排障视角:子连接架构下若某子阵的移相器批量失效(如一个子阵整列失配),该子阵覆盖角度的信号会塌掉,表现为"特定方向用户集体掉速"。这类故障在传统全数字下不会集中爆发,但在子连接下因"子阵=故障单元"而呈区块化——运维要学会按"掉速用户的空间方位"反推是哪个子阵出问题,而非笼统查整机。混合架构把故障也"区块化"了,排障逻辑随之改变,这是子连接结构带来的新运维特征,也是架构选择影响运维方式的一个具体例证:你选的不仅是波束性能,还有未来怎么修。
⚠️ 常见坑:用低频"加天线=提速"的直觉看混合架构。子连接下子阵切大虽省成本,但跨子阵自由度丢失,若用户恰需跨子阵的精细波束(如两个用户分处子阵边界角度),性能会掉;不是天线多就一定灵活,灵活度受"子阵怎么切"约束,架构选择要按场景订。
💡 关键直觉:混合波束赋形是大规模 MIMO 能商用的关键——用"少量数字通路 + 大量模拟移相器"两级处理,把全数字的射频爆炸压下来;子连接是成本与灵活性的最现实落点,子阵尺寸是那根可量化旋钮。
五、常见疑问
全连接自由度更高,为何不都用全连接?
因为移相器数量随阵元数线性爆炸(通路×阵元),64 阵元下就 512 个,且每个移相器有插入损耗、每个连接增加校准难度。全连接的理论自由度红利,常被硬件损耗与校准误差吃掉,实测未必优于精心设计的子连接。所以除非对波束灵活性有极致要求(如高频高精度感知),否则子连接是性价比赢家。
子阵切大切小怎么定?
看频段与场景:低频(如 3.5 GHz)波束较宽、用户方向分散度低,可用较大子阵省通路;毫米波(如 28 GHz)波束极窄、需精细角度控制,子阵宜小以保灵活。本质是"子阵尺寸 ↔ 波束自由度 ↔ 通路成本"的权衡,常以覆盖仿真定边界,再留余量。
混合架构和数字预编码、模拟赋形怎么分工?
数字预编码在基带、维度=通路数,负责多用户/多流间的干扰粗隔离(维度低、做得到);模拟赋形在射频移相器、维度=阵元数,负责能量角度聚焦(维度高、只能做相位)。二者级联:数字先分好"谁和谁互不干扰",模拟再把每路能量对准角度。第 4 章 BD 零空间多在数字端做,第 3 章阵列增益多在模拟端拿。
本章回顾
- 全数字射频爆炸:每阵元一套射频,64 阵元不可承受,引出混合
- 混合=数字粗调+模拟细扫:少量通路做多用户隔离,大量移相器做角度聚焦
- 全连接最灵活最贵:移相器=通路×阵元,自由度最高但硬件最难
- 子连接最现实:每通路管固定子阵,移相器=阵元,自由度降但易校准
- URA 8×8=64 切子阵:子阵尺寸是架构旋钮,低频大、毫米波小
- 子连接是商用落点:AAU 几乎全子连接,让大规模 MIMO 可上塔
- 架构选择按场景订:不是天线多就灵活,受子阵约束
- 混合=三角张力的焊接:把模拟/数字/混合权衡焊进硬件
下一节点出即便混合架构落地,仍有三把刀悬头顶:导频污染限速、低精度 ADC 换功耗、校准是开机硬前提——它们定义了大规模 MIMO 的规模上限。