2.1 MJCF结构详解:从worldbody到可运行模型
2.1 MJCF 结构详解:从 worldbody 到可运行模型
本节摘要:MJCF 是 MuJoCo 的原生建模语言,一份文件从外到内分四层:根元素 mujoco 之下,compiler 管单位与资源解析,option 管求解器行为,asset 存放可复用的网格与材质,worldbody 承载全部物理实体。更关键的是加载环节——引擎不是简单读 XML,而是跑一条「语法扫描、语义绑定、引用解析、拓扑验证、参数归一化」的编译流水线,把文本固化成内存中的确定性结构。看懂这四层与这条流水线,读任何现成模型都不会迷路,报错也能对号入座。
上一章我们把 MuJoCo 选定了,这一章开始造样机;而造样机的第一步,是看懂样机的图纸格式。本节是全章的地基:2.2 讲的树、2.3 讲的执行器、2.4 的完整实战,全都安放在本节铺垫的分层结构里。
学习目标
阅读完本节,你应当能够:
- 说出 MJCF 四大组成块各自管什么,拿到任意文件能快速定位关键配置;
- 描述加载编译的五道关卡,把常见报错映射到具体关卡;
- 亲手加载第一个模型并跑通一百步仿真,确认环境就绪。
一、先跑通第一个模型
工具学习的惯例是先见到活的再谈理论。装好官方绑定后,用官方模型库里任意一个模型验证环境,十几行足够:
import mujoco # 加载模型文件,得到只读的模型对象 model = mujoco.MjModel.from_xml_path("arm.xml") # 创建与模型配套的状态容器 data = mujoco.MjData(model) # 看几个关键规模:自由度、刚体数、执行器数 print("自由度 nv =", model.nv) print("刚体数 nbody =", model.nbody) print("执行器数 nu =", model.nu) for i in range(100): mujoco.mj_step(model, data) print("100 步后仿真时间 t =", data.time)
如果这段代码打印出了三个正整数和一个等于步长一百倍的时间,说明绑定、模型、求解器整条链路是通的。这个验证脚本的另一个价值是示范了命名习惯:model 开头的是「不随时间变的属性」,data 开头的是「每步都在变的状态」——这对搭档第三章会正式介绍,先混个脸熟。
二、四层结构:一份 MJCF 的解剖
MJCF 用 XML 语法书写,但它的组织逻辑不是「标签的堆叠」,而是「权限的分层」。一份典型文件长这样:
<mujoco model="demo_arm"> <compiler angle="radian" meshdir="meshes/"/> <option timestep="0.002" integrator="implicitfast"/> <asset> <mesh name="link1" file="link1.stl"/> <texture name="grid" type="2d" builtin="checker" rgb1="0.2 0.3 0.4" rgb2="0.3 0.4 0.5" width="300" height="300"/> <material name="mat_grid" texture="grid" texrepeat="8 8"/> </asset> <worldbody> <light pos="0 0 3" dir="0 0 -1"/> <geom name="floor" type="plane" size="5 5 0.1" material="mat_grid"/> <body name="base" pos="0 0 0.1"> <joint type="free"/> <geom type="capsule" fromto="0 0 0 0 0 0.2" size="0.05" mass="1.0"/> </body> </worldbody> </mujoco>
第一层:根元素与 compiler。 mujoco 根元素之下,compiler 是「宪法」级配置——angle 决定全文件角度单位按弧度还是度书写(注意:只是书写格式,加载后内存里永远是弧度,Python 里读到的一律是弧度);meshdir 与 texturedir 声明资源文件的查找根目录,建模逻辑与文件位置因此解耦,换资源目录只需改这一处。它还有一个高频属性 autolimits,打开后关节写了 range 就自动带限位,省掉成对的 limited 标记,新版模型几乎都用它。
第二层:option。 这里放的是「求解器怎么干活」:timestep 是仿真步长,默认半毫秒级的安全值,接触密集的场景常取千分之二秒;integrator 选积分格式,implicitfast 是新版默认,对关节阻尼做隐式处理,稳定性明显好于朴素欧拉;iterations 与 tolerance 控制约束求解的迭代预算。这一层的参数在第六章排错时会反复回来调,现在先知道「它们存在且影响数值行为」即可。
第三层:asset。 物料库。网格、纹理、材质这些「可复用、与位置无关」的定义都住在这里,worldbody 里的实体通过名字引用它们。这一层的价值在复用:一个材质定义可以贴给十个 geom,一份网格可以被两个模型 include 共享。material 有个容易忽略的细节——它除了视觉属性还能携带摩擦系数,引用它的 geom 会继承这组物理参数,所以「换个材质顺便换了摩擦」这种隐蔽 bug 并不少见,排查接触问题时要记得看 geom 最终生效的摩擦组合。
第四层:worldbody。 唯一的世界体,全部物理实体的根。光源、地面、每个 body 及其内部的 joint、geom、site 都嵌套在这里。它的嵌套深度就是运动学树的深度,这是下一节的主角。
图 2-1 一份 MJCF 的四层解剖与各层职责
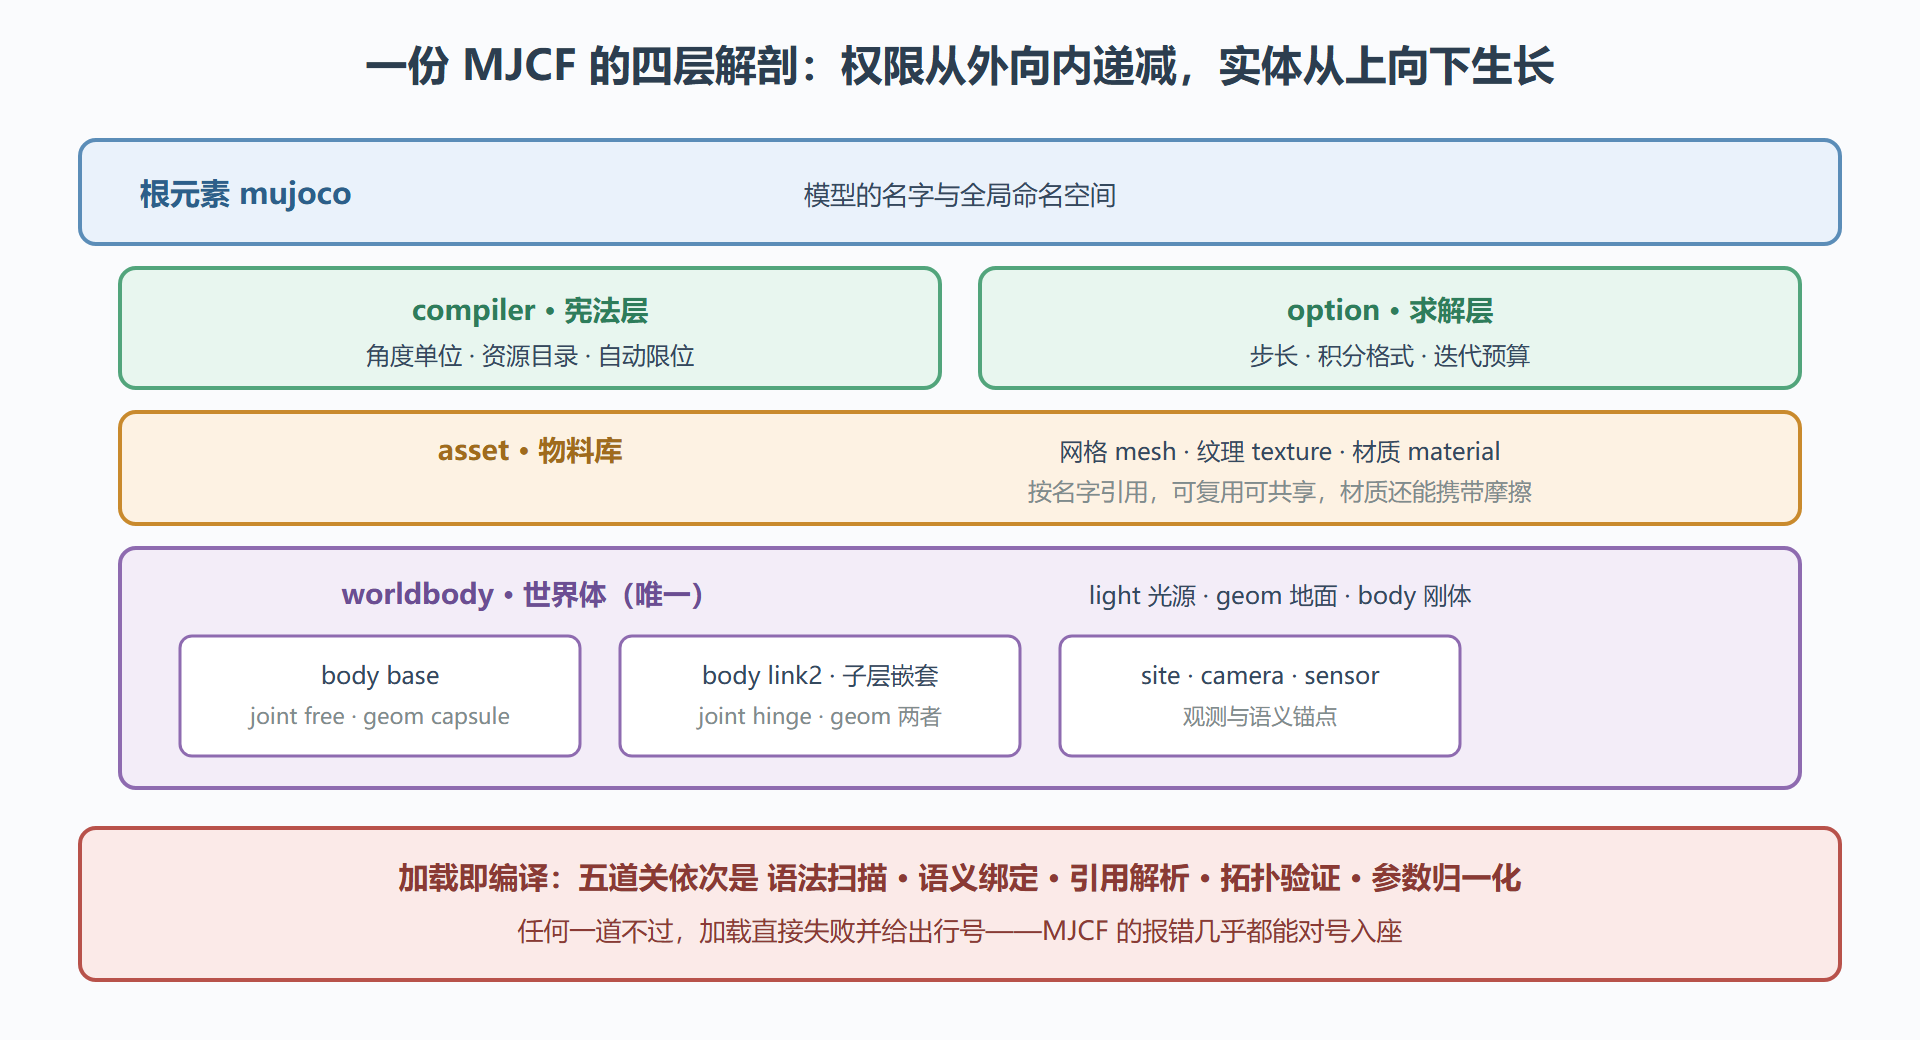
这张解剖图的用法:拿到任何一份现成模型,先扫 compiler 确认单位与资源目录,再扫 option 确认步长与积分器,然后进 worldbody 画树,最后按需查 asset。四层的阅读顺序也是排查问题的顺序——结构错误在编译期暴露,参数错误在仿真期暴露,先排前者再查后者,能省大量时间。
三、加载流水线:引擎怎么「读懂」你的文件
from_xml_path 这一行背后是一条五阶段流水线,每一阶段都可能把你的文件打回来:
- 语法扫描:标签拼写、嵌套合法性——joint 出现在 asset 里这种结构性错误在此出局;
- 语义绑定:属性值翻译成内部枚举与数值,类型不对、必填缺失在此暴露,比如 capsule 没给 size;
- 引用解析:geom 引用的 material、body 引用的 mesh,都要在 asset 里找到本尊,找不到就报「未知引用」;
- 拓扑验证:世界体唯一、body 连接无环、自由体必带 free 关节等结构约束在此把关;
- 参数归一化:角度统一转弧度、默认值填充、惯性参数计算,最终固化成内存里的只读模型对象。
这条流水线解释了 MJCF 的一个脾气:它宁可加载失败,也不带着可疑参数运行。惯量太小、关节轴为零向量、执行器范围倒置,都会在第五关被拦下。初学阶段这是最好的老师——报错信息带行号、带参数名,比仿真跑到一半发散了再回头找原因仁慈得多。
一个真实案例。某团队把 SolidWorks 导出的机械臂网格直接搬进 MJCF,加载报错「球面惯性半径过小」。排查路径:先看第五关的语义——引擎要求每个动体有正定惯量张量;再查网格,发现 CAD 导出单位是毫米,模型按米解析后连杆细得像头发,算出的惯量小到低于引擎下限。修复只需在 mesh 标签加 scale 属性统一缩放。这个案例的教训值得抄在建模笔记本第一页:CAD 数据进 MJCF,第一件事核对单位制,第二件事核对惯性是「算出来的」还是「填出来的」——两者的可信度天差地别。
四、写文件的三个工程习惯
习惯一:从最小可运行模型开始生长。 先写一个地面加一个自由落体的方块,跑通;再加第一个关节,跑通;逐步长成完整模型。每加一小块就加载一次,报错永远是最新引入的那一块的问题。相反,一次性写两百行再调试,报错会像开盲盒。
习惯二:给所有关键元素起名字。 body、joint、geom、site 都有 name 属性,全都认真起名。命名的回报在调试期:引擎报错会点名,传感器读数要按名索引,训练日志里的异常关节也要靠名字定位。匿名模型的调试体验,和在机场找回一件没有托运标签的行李差不多。
习惯三:用 include 拆文件。 场景、机器人、被操作物件分开成文件,主文件用 include 组装。机械臂模型被五个项目共用时,你会感谢当年的拆分——改夹爪不用碰机械臂本体,版本管理也干净。
本节要点回顾
- 四层结构:compiler 立规矩、option 管求解、asset 备物料、worldbody 装世界,阅读与排查都按这个顺序;
- 加载即编译:五道关卡把文本固化成确定性结构,MJCF 宁可拒绝加载也不带病运行,报错带行号可直接定位;
- 单位陷阱:文件里可按度书写,内存里永远是弧度;CAD 网格进 MJCF 先核对单位制;
- 工程习惯:最小模型起步、关键元素全命名、include 拆文件,三条都是/debug 效率投资。
下一节进入 worldbody 内部:刚体为什么必须长成树、自由度怎么数、惯性参数怎么填才可信。