3.4 mjModel与mjData:引擎的两本账
3.4 mjModel 与 mjData:引擎的两本账
本节摘要:MuJoCo 运行期的一切状态都装在两个结构体里:mjModel 是只读账本,记模型「是什么」——尺寸、质量、参数、连接关系,加载后不变;mjData 是流水账,记仿真「怎么样」——位置、速度、接触清单、传感器读数,每步都在刷新。「改模型动 model、改状态动 data」这条铁律背后,是引擎内存预分配与零拷贝设计;分清两本账,随机化、重置、并行复制这些工程操作才不会踩坑。
前三节讲的是「算什么」,本节讲「算的东西放在哪」。数据结构这一节看似工程琐碎,实则是第五章大量工程操作的根据所在:RL 环境重置靠 data、域随机化靠 model、大规模并行靠复制两者的姿势。
两本账各记什么
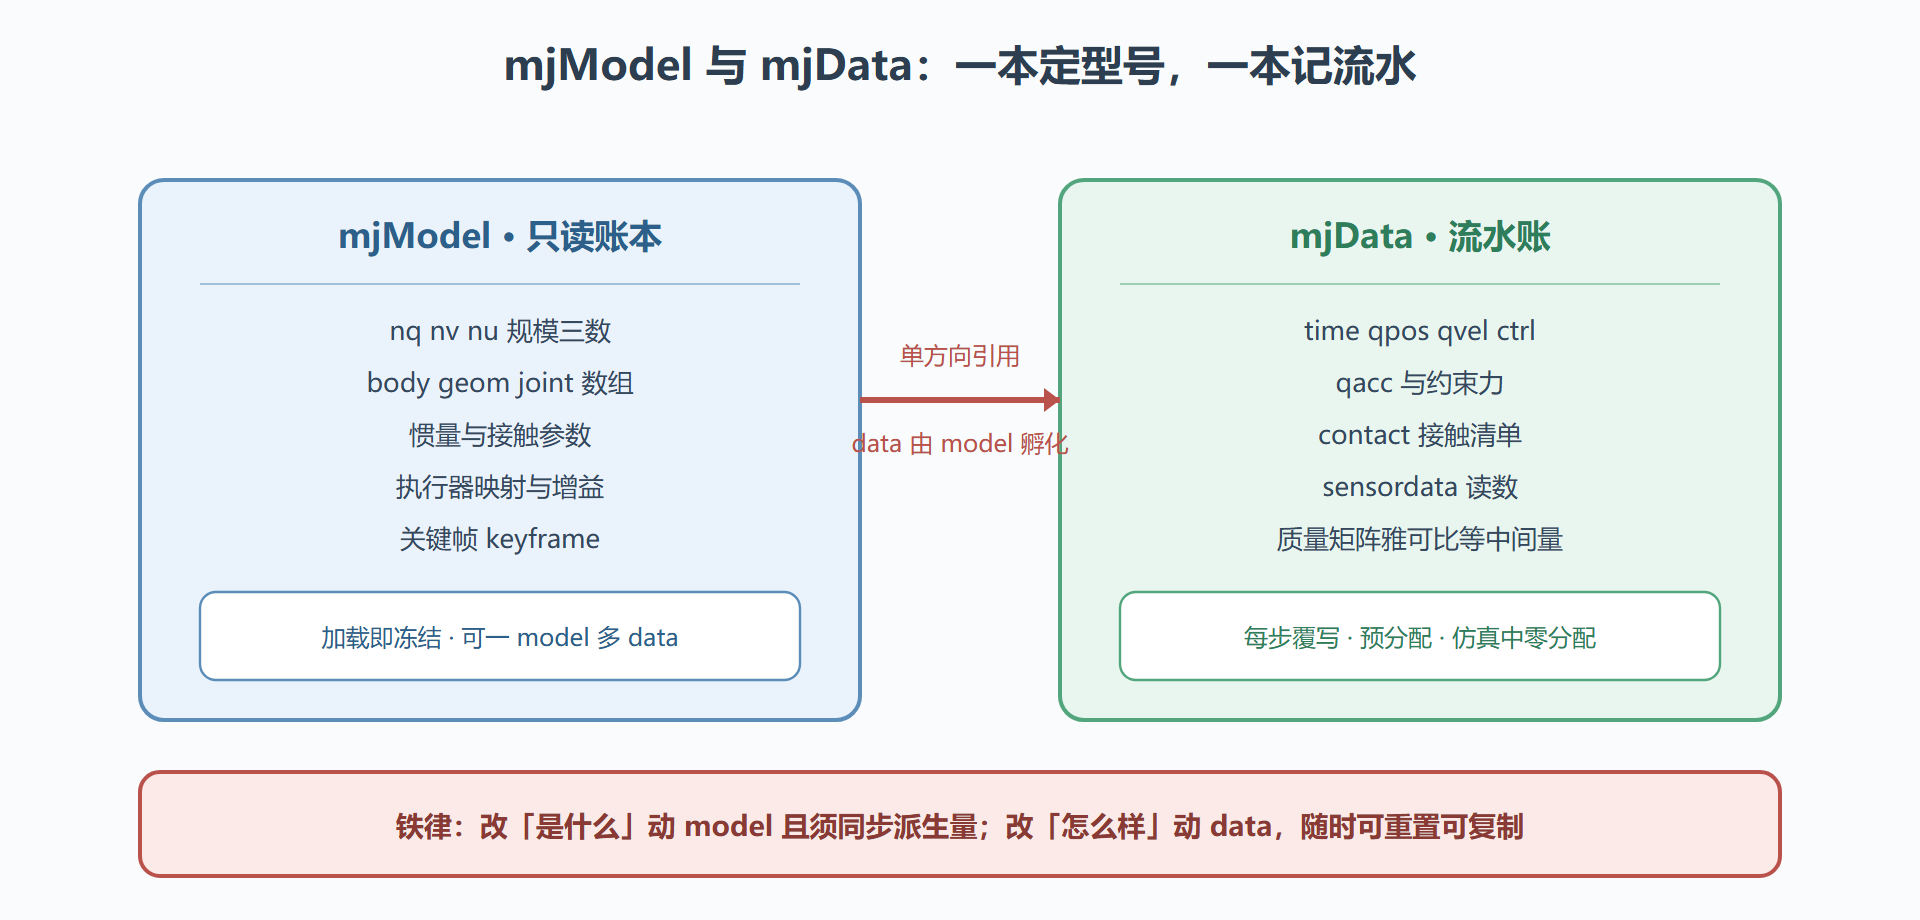
mjModel:一本不重印的账本。 MJCF 编译的产物。自由度数、刚体数组、每个 geom 的类型尺寸、接触参数、执行器映射、传感器定义——凡是你写在 XML 里的,最终都以扁平数组的形态住在这里。它的关键属性是加载即定、运行只读:引擎不为它做任何写保护仪式,但任何运行期改动都是「改账本」,改完必须自己负责同步派生量。它另一个隐含承诺是内存布局可复制——同一份 model 可以安全地喂给多个独立的 data,这是并行环境的根基。
mjData:一本每步重写的流水账。 当前时间、广义坐标 qpos、速度 qvel、控制 ctrl、加速度 qacc、接触数组 contact、约束力 efc_force、传感器读数 sensordata,加上一堆中间量(质量矩阵、雅可比、约束行)也在这里。它由 model「孵化」——MjData(model) 按模型的规模一次性分配好全部数组,之后每步只是覆写,整个仿真过程零内存分配。实时仿真的延迟确定性,一半功劳在这。
两本账的关系可以这么记:model 是「这台机器的体检报告」,data 是「今天的运动记录」。体检报告决定能做什么运动,运动记录绝不反过来改体检报告。
图 3-3 两本账的分工与引用方向
一、改账本的正确姿势:模型与派生量
运行期改 model 是合法的,但有一条纪律:改了「源头」要同步「派生」。引擎在加载时预计算了一批派生量(如体素级的惯量相关矩阵),你直接改了质量数组,派生量不会自动跟着变,动力学结果就会「账实不符」。常规套路是改完调用引擎提供的重算函数,或者干脆改 MJCF 重新加载——后者慢,但零心智负担。
哪些改动安全、哪些危险,给一张实用的分级清单:
import mujoco import numpy as np model = mujoco.MjModel.from_xml_path("arm6.xml") # 低风险:改参数值,不改变结构,重启仿真即生效 model.geom_friction[0] = np.array([1.4, 0.008, 0.008]) # 地面摩擦 model.dof_damping[:] *= 1.2 # 全关节阻尼上调两成 model.actuator_gainprm[:, 0] *= 0.9 # 执行器增益微调 # 中风险:改质量类参数后,需要引擎重算派生的常量 model.body_mass[3] = 1.5 scratch = mujoco.MjData(model) # 重算接口需要一个临时 data mujoco.mj_setConst(model, scratch) # 按新质量刷新模型常量 # 高风险:改结构类字段(连接关系、数组长度),官方不支持运行期改动 # 需要不同结构时,正确做法是生成新 XML 重新加载
低风险区的三种改动,恰好就是第五章域随机化的主力动作——摩擦、阻尼、增益在训练中随机抖动,model 原地改值即可,开销几乎为零。高风险区唯一正确的路是重加载,这也是「环境工厂」每次建环境都重新编译一遍 XML 的原因。
二、data 的日常操作:重置、注入与读出
重置:环境回到初始状态,RL 每个回合开头都要做。裸 reset 只清零,配合 keyframe(关键帧)可以一键摆到预存的姿态——第二章验收脚本里的 resetKeyframe 就是它。更讲究的「随机重置」:重置后在合理区间内扰动 qpos 与 qvel,防止策略只会应付单一初始状态,这是第五章环境构建的标配动作。
注入:直接往 data 里「手工摆状态」常用于热启动与故障复现——把上次发散前一步的 qpos、qvel 原样拷贝回来,加同样的 ctrl 重跑,数值发散是可以精确复现的(引擎的确定性在这里帮大忙)。做故障复现实验室时的口诀:存全量、按原序、同版本。
读出:训练观测与日志全部从 data 读。三个高频字段——qpos 与 qvel 是本体状态,contact 是接触清单(注意每步都变,跨步引用其中的元素前要先拷贝),sensordata 是传感器切片(按第二章的名字寻址法取用)。中间量如雅可比矩阵也开放读取,做自定义控制器时可直接取用引擎算好的雅可比,不必自己重算。
三、两本账之上的三个工程模式
模式一:环境工厂。 每个并行环境一份 model 加一份 data。model 可以共享吗?CPU 版可以多环境共享同一 model(各 data 独立),但一旦要做域随机化就得一人一份 model——随机化改的是 model。第七章 GPU 路线则是把成千上万份「结构相同、参数不同」的 model 堆叠成批量数组,两本账的分离让这种堆叠在数学上是干净的。
模式二:影子仿真。 对同一个 data 想比较「如果刚才用了另一个 ctrl 会怎样」?开一个影子 data 拷贝当前状态去试,主 data 不受污染。MPC 的多候选轨迹评估就是这样组织的:一份主账,若干影子账,各自推演,择优执行。
模式三:检查点。 把 qpos、qvel、time(必要时加 ctrl)存档,未来任意时刻恢复。注意 model 与 data 必须同源同版本——用今天的 model 读上周的 data 快照,字段语义可能已经漂移。检查点文件里同时存模型的哈希,是廉价而有效的防呆。
本节要点回顾
- 两本账铁律:model 记「是什么」只读为主,data 记「怎么样」每步覆写,引用单方向;
- 改 model 分级:改参数值低风险,改质量要重算派生,改结构必须重加载;
- 零分配设计:data 按模型规模预分配,每步纯覆写,实时延迟确定性的底气;
- 三个模式:环境工厂、影子仿真、检查点,第五章与第七章都要回来取用;
- 接触清单当步有效:跨步使用 contact 信息前先拷贝。
两本账已在手,最后一节把它们串成一条完整的流水线:一次 mj_step 的前后半步,各自发生什么、什么时机读数安全。