6.1 计算性能优化实战
6.1 计算性能优化实战
本节摘要:性能优化的第一课不是改参数,是测量——先给仿真做「性能画像」,搞清楚时间花在物理求解、碰撞检测、传感器还是渲染,再对症下杠杆。本节给出画像的测量方法、五大优化杠杆(步长、condim、碰撞配对、隔离接触、渲染降载)各自的原理与代价,以及一条从真实项目提炼的优化实录。多数「慢」的病根不在引擎,在无意识的配置浪费。
调校的第一站是速度。仿真太慢的后果不只是等得烦:训练吞吐减半、MPC 控制频率上不去、批量化实验排期翻倍。而「优化」最大的浪费是改错地方——把一个渲染瓶颈的模型调了半天物理参数。本节的方法论就从这里开始:先画像,后动刀。
学习目标
阅读完本节,你应当能够:
- 用计时分段的方法给仿真做性能画像,说出时间花在哪个阶段;
- 按性价比顺序使用五大优化杠杆,并说明每个杠杆的原理与代价;
- 判断自己的任务是否已经接近引擎的物理极限,该转投 GPU 路线还是继续榨 CPU。
一、先画像,后动刀
画像的意思是把每步仿真的耗时拆成阶段:物理推进、碰撞检测、传感器结算、渲染(如果有)。方法朴素但有效——分段计时加统计:
import mujoco import time import numpy as np model = mujoco.MjModel.from_xml_path("scene_big.xml") data = mujoco.MjData(model) # 粗画像:整步耗时 与 纯 forward 耗时 对比 t0 = time.perf_counter() for _ in range(1000): mujoco.mj_step(model, data) full = (time.perf_counter() - t0) / 1000 t0 = time.perf_counter() for _ in range(1000): mujoco.mj_forward(model, data) fwd = (time.perf_counter() - t0) / 1000 print(f"整步 {full*1e3:.2f} 毫秒 | 前向 {fwd*1e3:.2f} 毫秒") print(f"接触数均值参考: {data.ncon}")
对结果的读法有一条经验分界:如果 forward 占整步的九成以上,瓶颈在物理(继续往下读杠杆一至四);如果整步远大于 forward,多出来的时间在传感器结算、渲染或你自己的环境代码(跳到杠杆五)。还有一个常被忽略的宏观账:用时间除以步长算「仿真与实时的倍速」——两毫秒步长每步花四毫秒,就是半倍速,训练吞吐的账要按这个倍速算,不能按单步毫秒数自我安慰。
二、五个杠杆:按性价比排序
杠杆一:condim 降维。 3.2 讲过 condim 决定每个接触算几个方向的力,这里兑现它的性能含义:约束行数随 condim 线性增长,全场从六降到三,约束求解的开销近乎减半。排查法是把模型的 condim 分布打印出来——某分拣项目全场默认六维,其实只有夹爪指腹需要高维,统一降到三加局部六维后吞吐涨了六成。代价:滚转扭矩类交互失真,按任务需要给关键 geom 单独升回。
杠杆二:碰撞配对裁剪。 碰撞检测的成本在候选对数量。contype 与 conaffinity 的位掩码机制(2.2 埋的伏笔)让「某些组之间永不互检」成为一行配置:颗粒与颗粒之外的所有物体、视觉件与一切、静态场景件彼此之间——这些配对默认都在白白检测。裁剪原则一句话:只为「可能产生有意义的力」的物体对保留碰撞检测。大场景(颗粒、多物体货架)的优化里,这一杠杆经常是单项收益最大的。
杠杆三:步长与迭代预算的再平衡。 步长翻倍,每秒物理量直接减半——前提是 3.3 的收敛性检查通过(步长加倍结论不变)。迭代预算同理:3.2 的体检单显示求解器常常三五次就收敛,而预算给了一百次——预算砍到实际用量的三倍,不影响结果只影响兜底。这两个杠杆改动成本为零,属于「白捡」类,但必须配验证实验,否则是在省性能的名字下偷精度。
杠杆四:隔离接触与模型分层。 物理上不相干的部分互相喂约束是大场景通病:机械臂的精细接触与远处静态货架的粗糙接触搅在同一个求解器里。解法是模型分层:静态环境做成「不动件」(或干脆无碰撞的视觉件),只在机械臂工作空间内布置精细碰撞几何;活动物体按需启用。极端场景还可以用多模型分时段仿真——只仿真当前交互区域,远处用低频或冻结。
杠杆五:渲染与传感器降载。 4.3 给过三招(降分辨率、降频采样、合批),这里补一条宏观判断:视觉观测任务的瓶颈几乎总在渲染侧,物理侧再怎么优化也无感。先画像确认,再决定是减载还是直接转 GPU 路线。
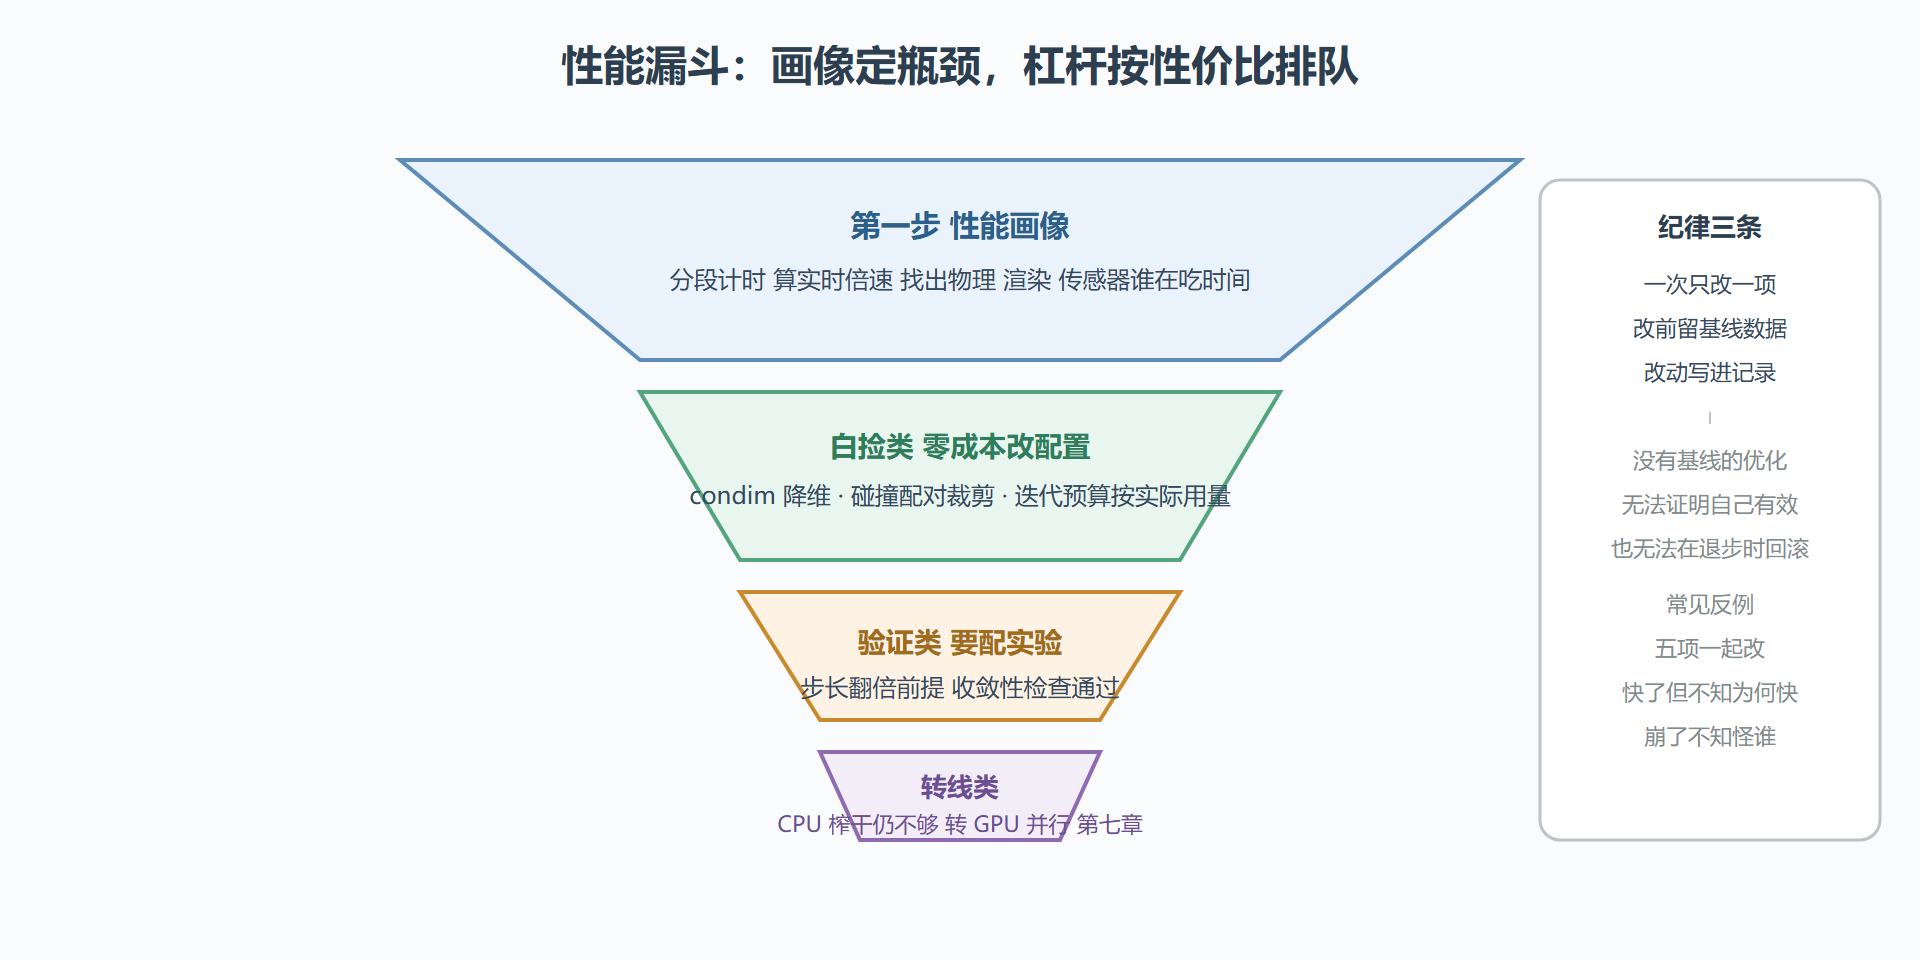
图 6-1 性能优化漏斗:先测量,再按性价比动刀
三、一条优化实录:从半倍速到三点五倍速
背景:某仓储分拣仿真,机器人加传送带加约两百件包裹,实时倍速零点五,训练排期不可接受。操作:先画像——forward 占整步百分之九十四,瓶颈在物理;打印 condim 分布,全场六维;数碰撞配对,包裹与包裹之外大量无效检测;查求解器体检单,迭代用量峰值十七次而预算一百。第一步全场 condim 降到三(指腹局部升六),倍速零点五到零点九;第二步裁剪包裹与传送带框架的碰撞、关闭视觉件碰撞,零点九到一点六;第三步迭代预算一百砍到六十、步长经收敛性检查翻倍到四毫秒,一点六到三点一;第四步把远处静态货架改成无碰撞视觉件,三点一到三点五。结果:七倍提速,任务成功率统计在优化前后差异小于百分之一。解读:四步杠杆全部来自本节的清单,没有一行「黑魔法」——性能问题绝大多数是配置税,不是引擎税。变式:如果画像显示瓶颈在渲染(视觉任务),同样的纪律换到 4.3 的三招;如果物理侧榨干仍不达标(画像确认、杠杆全用完),那是任务规模越过了 CPU 边界,正确动作是第七章的 MJX 路线,而不是继续在配置里找补。
本节要点回顾
- 画像先行:分段计时加实时倍速,先确认瓶颈在物理、渲染还是环境代码;
- 五杠杆按性价比:condim 降维、配对裁剪、步长与预算再平衡、模型分层、渲染降载;
- 白捡与验证分层:配置类改动零成本先做,步长类改动必须带收敛性检查;
- 三条纪律:一次改一项、留基线、写记录,没有基线的优化无法自证;
- 知道何时收手:CPU 榨干仍不够,转 GPU 路线是正解,不是配置的失败。
速度治好了,下一节治「行为不对」——接触与摩擦的参数病是试车场里最高发的故障,下一节用一整份实录讲透它。