7.1 MJX与GPU大规模并行仿真
7.1 MJX 与 GPU 大规模并行仿真
本节摘要:MJX 是把 MuJoCo 引擎用加速器友好的方式重写、编译到 GPU 与 TPU 上批量化执行的官方路线:成千上万份结构相同的环境被打包成一批数据,一次内核调用推演所有环境的同一个阶段。它没有改变物理,改变的是「物理的执行方式」——环境吞吐从个位数并行跳到五位数并行。本节讲清这条路线的工作原理、从 CPU 迁移的决策清单,以及三类典型的迁移坑。
第一章的选型矩阵里,「并行吞吐」一列是 MuJoCo 的短板;本节讲官方怎么补齐它——不是优化 CPU 内核的多线程,而是换一条执行路线。
学习目标
阅读完本节,你应当能够:
- 解释 MJX「编译成批计算」的技术路线与经典 CPU 引擎执行方式的本质区别;
- 用迁移决策清单判断自己的任务该留在 CPU 还是上 GPU 路线;
- 识别迁移时的三类典型坑:分支发散、单环境调试退化、与渲染管线的对接成本。
一、路线原理:把「循环调函数」变成「一批数据过内核」
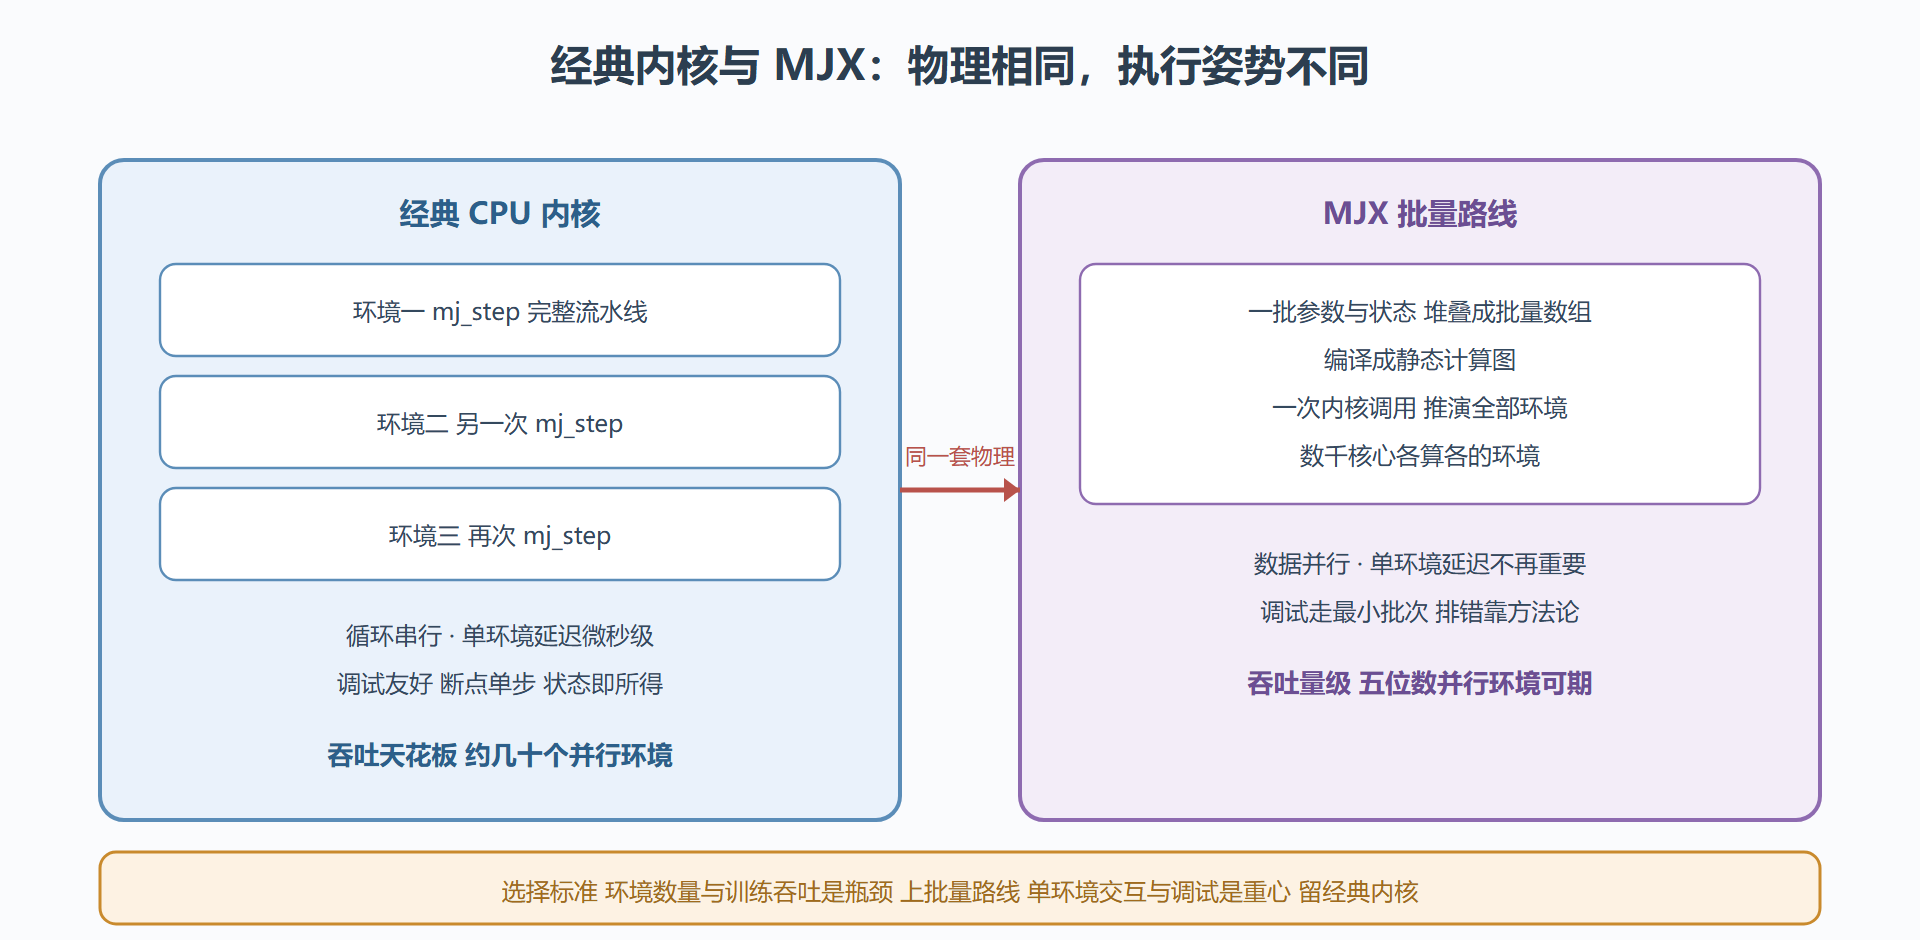
经典 CPU 引擎的执行姿势是「一个环境一个状态机」:for 循环里反复调用 mj_step,每步串行跑完碰撞、约束、积分全流程。这个姿势对单环境延迟极友好(3.1 的微秒级),对吞吐极不友好——开一百个线程各跑一个环境,内存与调度的开销很快吃掉收益。
MJX 换了个抽象:把引擎的计算写成纯函数——输入全部模型参数与状态,输出下一步状态——然后把「一份模型的计算」泛化成「一批模型的计算」。一千个结构相同、参数各异的模型参数与状态堆叠成批量数组,交给加速器一次推演;GPU 上数千个计算核心同时处理批里的不同环境,吞吐的规模化来自数据并行,而不是任务并行。
这个抽象是第七章导语里「没改变物理」的含义:MJX 跑的还是同一套软约束动力学、同一个求解器思想(3.2),模型的 MJCF 语法也基本通用。改变的是三件工程事实:第一,计算图要静态——环境的数量与结构在编译期定死,运行期不能随行为变化;第二,精度与速度的权衡点移动——加速器偏爱半精度与规则计算,某些求解器配置在 GPU 上要重新调;第三,调试方式改变——断点单步执行对批计算不再友好,排错回到第六章的「最小复现」方法论,只是复现场景从十行代码变成最小批次。
图 7-1 两条执行路线:串行状态机与批量纯函数
二、迁移决策:谁的账本上批量路线划算
值不值得迁移,三问定案。一问:环境数量真的上千吗? 任务复杂、每环境重(人形全身、密集接触),CPU 内核加几十个进程并行可能就够了,迁移的工程成本换不来量级收益;采样型 RL(需要海量短交互)与大规模随机化筛选,批量路线的主场。二问:瓶颈确认在物理吗? 用 6.1 的画像先验明正身——视觉任务的瓶颈常在渲染,物理侧上了批量,渲染侧不跟上等于白迁。三问:模型「批量友好」吗? 结构统一、参数化的模型族批量效率高;大量运行期分支(不同环境走完全不同的逻辑)会破坏静态计算图,批内「最慢的环境」拖累全体。
迁移清单之外,三类坑提前点名。坑一:分支发散。 批内环境如果各自触发不同的控制逻辑(if 环境一抓到了就走分支甲),加速器要为所有分支付费。处方是把行为逻辑做成「无分支的数学」——用掩码与加权代替条件跳转,第五章的 MPC 混合架构要迁移就得先做这层改写。坑二:调试退化。 批计算里找不到「第几号环境」的现场,处方是批大小收到最小(比如八)复现问题,配合第六章的最小复现四步;GPU 上的数值病诊断(能量账本、体检单)照搬 CPU 的方法,读数从单环境变成批统计。坑三:渲染没跟上。 物理千环境配渲染单环境是常见断点,视觉任务的完整方案要等渲染侧的合批能力(4.3 提过),或接受「物理批量、观测降频」的折中。
一条真实的迁移记录可以让清单落地。某六足地形适应任务:CPU 内核加八进程并行,训练到可用策略要十一天;迁批量路线,两千零四十八环境批跑,同阶段压到六小时——收益的绝对主角不是单核变快,而是「域随机化(5.3)的参数族从十六份抽样变成两千份覆盖」,随机化越宽、策略越钝,Sim-to-Real 的成功率直接受益。这个案例的推广价值在提醒:批量路线改变的不只是速度,还有「随机化预算」这个训练质量的隐形变量。
三、生态位:批量路线与它的高层封装
MJX 之上已经长出几层封装:把「环境批量加 RL 算法」打包的训练框架、把常见任务(运动、操控)预置成开箱环境的任务库、以及与主流学习框架的无缝互操作——批量引擎本质上是学习框架计算图里的一个算子,物理数据与神经网络参数在同一个设备、同一个图里流转,数据搬运的开销趋近于零。这层「物理成为学习栈原生组件」的地位变化,比任何单点速度数字都更深远:过去是「训练框架调用引擎」,现在是「物理住在训练框架里」。
迁移之后,性能工作换了一套记账口径,值得单独交代。CPU 时代的画像单位是「单步毫秒」,批量时代的对应物是「每秒环境步数」(每秒推演的环境步总量)——批大小乘以步频的乘积才是吞吐的真数;「批内最慢环境」取代「单环境最坏情况」成为新的短板定义:两千个环境里只要有一个触发超长接触链,整批都要陪它跑完。所以批量时代的模型健康标准要从「个体健康」升级为「分布健康」——用批统计(接触数分布、迭代数分布)代替单环境读数,6.1 与 6.2 的体检工具全部平移成批量版即可,方法不用重学。
选型上的落地建议:新项目从任务出发——交互频繁、单环境复杂的操控与验证,经典内核;采样海量、随机化驱动的运动与泛化任务,批量路线;两条路线共用同一份 MJCF 资产,先在 CPU 上把模型调健康(第六章的纪律),再迁批量放大——这个「先调健康、再上规模」的次序,是本册全书都在重复的那句话在 GPU 时代的最新版本。
本节要点回顾
- 物理不变,执行变:MJX 把引擎写成纯函数编译成批计算,吞吐换轨到数据并行;
- 三问定迁移:环境数量、瓶颈归属、批量友好度,三问有一问不过就先留在 CPU;
- 三类坑:分支发散改掩码、调试退回最小批次、渲染侧必须同步跟上;
- 随机化红利:批量路线的隐性收益是参数族覆盖变宽,Sim-to-Real 直接受益;
- 次序纪律:先在 CPU 调健康,再上规模放大——旧纪律在新路线下依然不便宜。
物理可以被批量执行,也可以被求导。下一节看另一条延伸:当梯度流经引擎,模型与策略都能被「算」出来。