1.1 ONNX 格式与导出链路
1.1 ONNX 格式与导出链路
本节摘要:ONNX 是以 Protocol Buffers 序列化的计算图 IR:Node 是算子调用,Edge 是张量流,Graph 描述数据依赖。导出链路的核心是把框架动态图「固化」为可移植的
.onnx,并通过 checker 与 ORT 试跑验证。
从一次导出失败说起
生产里最常见的第一封工单:「PyTorch 本地 inference 正常,导出 ONNX 后 ORT 报错 Unsupported operator 或 shape 不匹配。」根因往往在导出阶段,而非 ORT 本身。导出是一个不可逆的"降维"过程:PyTorch 的 nn.Module 带有类结构、方法栈与 Autograd 元信息,tracer 只保留运行时实际走过的张量算子序列,其余信息全部丢弃。这意味着 export 时的输入 shape、控制流分支、甚至 model.eval() 是否调用,都会凝固进文件。
2018 年微软《AI Deployment Friction Report》曾统计:企业 AI 项目约 47% 工时耗在部署,其中 63% 用于框架转换与兼容性。把导出参数一次配对,是缩短这段工时的最直接手段。
ONNX 文件的三层结构
.onnx 是 Protocol Buffers 二进制,顶层是 ModelProto,往下是 GraphProto,再往下是节点与张量。理解这三层,报错时才能定位是"整个文件坏了"还是"某个节点不受支持"。
| 层级 | 内容 | 排查要点 |
|---|---|---|
| ModelProto | opset_import、producer_name、metadata_props | opset 版本是否被目标 EP 支持 |
| GraphProto | node 列表、initializer、input/output、value_info | 节点输入是否都有定义 |
| NodeProto | op_type、domain、attributes、input/output 名 | 算子在当前 opset 下的 schema 是否存在 |
| TensorProto | 权重数据与 dtype | 权重是否过大、是否可被 INT8 压缩 |
一个典型的 MLP 导出后只有几十个节点,而带控制流或 nn.Sequential 深层嵌套的模型可能展开成数百个节点。用 onnx.helper.printable_graph(g) 或 onnxruntime.tools 里的可视化工具,能快速把图"读"出来。
torch.onnx.export 关键参数
导出函数的核心参数决定图的形态。三个参数最容易踩坑:opset_version、dynamic_axes、input_names/output_names。
| 参数 | 作用 | 高频错误 |
|---|---|---|
| opset_version | 声明模型遵循的算子规范版本 | 目标 EP 不支持过高/过低版本 |
| dynamic_axes | 声明哪些维度可变 | 漏声明导致 batch 固定、服务端拒绝变长输入 |
| input_names/output_names | 为输入输出张量命名 | 名字与调用端 input_feed 不一致 |
| do_constant_folding | 导出期预折叠常量 | 与 ORT 加载期折叠重复但不算错 |
import torch import torch.nn as nn class MLP(nn.Module): def __init__(self, in_dim, hidden, out_dim): super().__init__() self.fc1 = nn.Linear(in_dim, hidden) self.act = nn.GELU() self.fc2 = nn.Linear(hidden, out_dim) def forward(self, x): return self.fc2(self.act(self.fc1(x))) model = MLP(256, 512, 10).eval() dummy = torch.randn(1, 256) torch.onnx.export( model, dummy, "mlp.onnx", opset_version=17, input_names=["input"], output_names=["logits"], dynamic_axes={"input": {0: "batch"}, "logits": {0: "batch"}}, )
dynamic_axes 声明后,导出图里的 batch 维会用符号名 batch 表达,运行时才绑定具体数值。不声明则被 tracer 固化为 1,换 batch 直接报 shape 错误。GELU 这类新算子依赖较高 opset,若目标设备只支持 opset 13,需要把 GELU 改写为近似实现或升级 ORT。
双重验证:checker + ORT 试跑
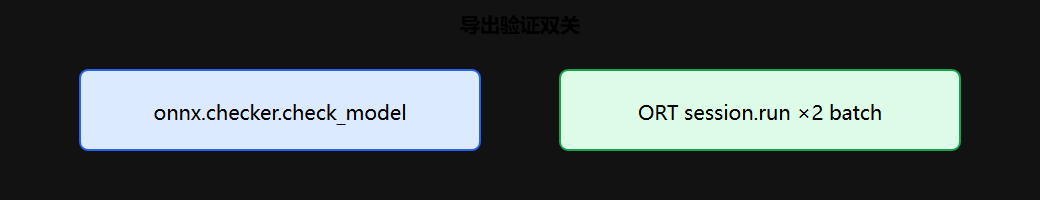
导出不等于可用。最小门禁是两步:先 onnx.checker 校验结构合法性,再用 ORT 用两种输入 shape 各跑一次,确认静态 shape 与动态 shape 都正确。
import onnx import onnxruntime as ort import numpy as np onnx.checker.check_model("mlp.onnx") # 结构合法性 model_onnx = onnx.load("mlp.onnx") onnx.checker.check_model(model_onnx) # 加载后再次校验 sess = ort.InferenceSession( "mlp.onnx", providers=["CPUExecutionProvider"], ) x1 = np.random.randn(1, 256).astype(np.float32) y1 = sess.run(None, {"input": x1})[0] x2 = np.random.randn(8, 256).astype(np.float32) # 换 batch 验证 dynamic_axes y2 = sess.run(None, {"input": x2})[0] print(y1.shape, y2.shape)
# 导出期的 shape 检查:用 checker 自带 shape_inference 看中间张量 inferred = onnx.shape_inference.infer_shapes(model_onnx) for vi in inferred.graph.value_info: print(vi.name, [d.dim_value if d.dim_value else "?" for d in vi.type.tensor_type.shape.dim])
checker 通过只说明文件语法与结构合法,不保证目标 EP 支持每个算子。真正决定"能不能跑"的是后续 Session 创建时的 EP 分区,那是第2章与第3章的主场。此处只需要确认:结构合法、静态与动态 shape 均可 run。
把导出与验证串成一个脚本,便于在 CI 里复用:
import torch import onnx import onnxruntime as ort def export_and_verify(model, dummy, path, opset=17): # 1) 导出:eval 模式 + 固定输入名 + 动态 batch model.eval() torch.onnx.export( model, dummy, path, opset_version=opset, input_names=["input"], output_names=["logits"], dynamic_axes={"input": {0: "batch"}, "logits": {0: "batch"}}, ) # 2) 结构校验:语法 + 形状推断 m = onnx.load(path) onnx.checker.check_model(m) inferred = onnx.shape_inference.infer_shapes(m) # 3) ORT 双 shape 试跑:静态(1) 与动态(8) sess = ort.InferenceSession(path, providers=["CPUExecutionProvider"]) for batch in (1, 8): x = torch.randn(batch, dummy.shape[1]) out = sess.run(None, {"input": x.numpy()})[0] assert out.shape[0] == batch, f"batch 维度未生效: {out.shape}" return sess mlp = MLP(256, 512, 10) sess = export_and_verify(mlp, torch.randn(1, 256), "mlp.onnx")
这段脚本把本节全部要点收进一个函数:eval 模式、opset、dynamic_axes、checker、shape_inference、双 batch 试跑。把它放进 CI 的模型导出阶段,任何破坏 ONNX 兼容性的改动都会在这里提前暴露。
常见导出错误对照
| 报错 | 根因 | 处置 |
|---|---|---|
| Unsupported operator | opset 内无此算子 | 升级 opset / 改写算子 / Custom Op |
| Shape mismatch on input | dynamic_axes 漏声明 | 补声明或固定 batch |
| No registered kernel | 算子无对应 EP kernel | 检查 EP 支持列表 |
| Error in constant folding | 常量子图含副作用算子 | 关闭 do_constant_folding 后重导 |
| NaN in output | tracer 捕获了非训练路径分支 | 确保 eval 模式与正确分支 |
⚠️ 注意:model.train() 状态下导出会把 dropout/batchnorm 的训练行为烙进图里,推理输出直接漂移。导出前务必 model.eval()。
本节要点
- opset + dynamic_axes 是高频参数
- checker + 双 shape 试跑 是最小门禁
- 导出是降维过程,分支与模式(eval/train)会固化进文件
- 结构合法 ≠ 目标 EP 可跑,后者交给 Session 与分区
下一节看 InferenceSession 如何接管这张图。