1.2 ORT 架构与 Session 模型
1.2 ORT 架构与 Session 模型
本节摘要:ORT 通过 Graph Processing Engine、Execution Provider 与 Runtime 层执行 ONNX。InferenceSession 是模型生命周期的主权容器——加载、优化、分配、执行都在 Session 内完成。
同一份模型为何行为不同
「同一份 ONNX,同事机器快、我机器慢」——常见原因是 SessionOptions 或 providers 不同,而非模型本身。InferenceSession 并不是一个轻量句柄,它创建时完成的工作量很大:解析模型、形状推断、图变换、EP 分区、kernel 选择、内存规划,每一步都受配置影响。两个人用不同版本的 ORT、不同的 graph_optimization_level、不同的 providers 顺序,得到的执行计划可以完全不同。
ORT 2018 年目标:让 PyTorch 模型在 Windows CPU 上无缝高性能运行;2020 年前后引入 EP 插件架构,把硬件差异隔离到插件层。这解释了为什么同样一个 .onnx,在 CPU 上走的是一条路径,在 CUDA 上是另一条路径——图优化和 kernel 选择都是 EP 感知的。
ORT 四层结构
| 层级 | 职责 | 主要组件 |
|---|---|---|
| 模型层 | 持有 ONNX 图与权重 | Graph、Initializer |
| 优化层 | 融合、常量折叠、布局改写 | Graph Optimizer |
| 执行层 | 硬件原生 kernel、子图接管 | EP:CUDA/TRT/DML/CPU |
| 运行时层 | Arena、线程、profiling | Allocator、ThreadPool |
四层之间是"向下委托"的关系:模型层是纯数据,优化层负责改图,执行层决定 kernel 落在哪块硬件,运行时层提供跨 EP 的基础设施。分层带来的直接收益是可替换性:芯片厂商只实现 EP 接口,就能让全球 ONNX 模型用上自己的硬件;框架方只关心导出,不需要了解任何 CUDA 细节。
Session 生命周期时序
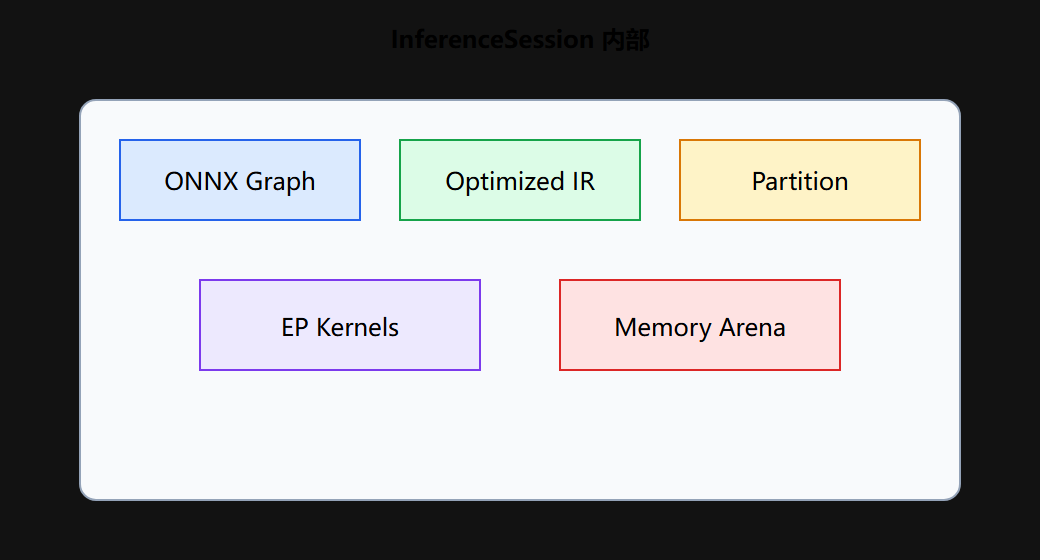
一个 InferenceSession 从创建到执行,内部依次完成六个步骤:
- 步骤 1:
onnx::ModelProto反序列化,语法与结构校验 - 步骤 2:静态形状推断,把
?维度解析为符号表达式 - 步骤 3:按
graph_optimization_level跑融合、折叠、布局改写 - 步骤 4:按各 EP 的
GetCapability()把图切成若干子图 - 步骤 5:每个节点在所属 EP 的注册表里选 kernel
- 步骤 6:Arena 依据 shape 与生命周期规划内存,静态 shape 下可复用同一块缓冲
对应到 Python 代码,只有两行,但背后就是上面整条流水线:
import onnxruntime as ort so = ort.SessionOptions() so.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_EXTENDED sess = ort.InferenceSession( "mlp.onnx", sess_options=so, providers=[ "CUDAExecutionProvider", # 优先级最高,能接管的先接管 "CPUExecutionProvider", # 兜底 ], )
providers 列表的顺序即优先级:ORT 按顺序询问每个 EP 能否接管某个子图,先声明者先挑。GPU 场景务必把 CUDA/TensorRT 放在 CPU 之前,否则图会被 CPU 全量接管。用 sess.get_providers() 确认实际激活列表,而不是凭想象。
混合执行与模型序列化
EP 不支持某算子时,ORT 不会报错,而是让该节点回退到 CPU kernel——这叫混合执行。好处是复杂图总能跑,代价是 CPU/GPU 边界会引入拷贝。混合执行是否成立取决于每个节点是否有至少一个 EP 提供 kernel,若整张图都没有,Session 创建即失败。
Session 创建是耗时的,尤其在大模型上。ORT 支持把优化后的图导出为 .ort 文件:
so.optimized_model_filepath = "mlp_opt.ort" # 创建后即写入优化图 sess = ort.InferenceSession("mlp.onnx", sess_options=so) # 下次直接加载 .ort,跳过步骤 2-6 sess2 = ort.InferenceSession("mlp_opt.ort", providers=["CPUExecutionProvider"])
.ort 文件已含优化后的图与内存规划,冷启动可降至亚毫秒级。部署多副本时先把 .ort 烘焙好再分发,能省掉每实例重复的优化开销。
混合执行与模型序列化
混合执行的粒度是节点级还是子图级,取决于 EP 的实现方式。CUDA EP 通常是节点级:每个受支持的算子单独映射到 CUDA kernel;TensorRT EP 则是子图级:整段子图被交给 TRT 编译成一个 engine。前者灵活但边界多,后者高效但编译慢。这也是为什么第2章的分区结果、第3章的 EP 选型会直接决定最终延迟——它们改变的是"哪些节点挨在一起跑、边界在哪里拷贝"。
用一张表格理解四层协同
| 场景 | 模型层 | 优化层 | 执行层 | 运行时层 |
|---|---|---|---|---|
| CPU 部署 | FP32 权重 | 融合 Conv+BN+ReLU | CPU EP / MLAS | Arena + 多线程 |
| GPU 部署 | FP32 权重 | 布局改写 NHWC | CUDA EP / cuDNN | CUDA Arena |
| 低延迟 | 静态 shape | 常量折叠 + 融合 | TensorRT EP | mem_pattern |
| Windows 桌面 | 任意 shape | EXTENDED | DirectML EP | 缺省线程 |
同一份 ONNX,四层各做各的事:模型层只提供数据,优化层决定图长什么样,执行层决定算子在哪个设备上算,运行时层决定内存与线程怎么分配。改动任何一层,最终行为都会变——这就是"同一份模型不同行为"的完整解释。
判断直觉与常见误区
💡 先 diff SessionOptions 与 providers,再查模型。两个环境行为不一致时,对比这四项:ORT 版本、graph_optimization_level、providers 顺序、是否加载了 .ort。多数"同样代码不同结果"都是这四项的差异。
⚠️ run 之间 Session 必须复用。每请求新建 Session 等于把图优化与内存规划重跑一遍,P99 直接失控。正确做法是服务启动时建一个 Session 池,run 只做张量搬运与计算。
⚠️ intra_op_num_threads 不等于进程内线程上限。它只控制单个算子内部的并行度,在 GPU 场景下基本被忽略,盲调到 16 只会让 CPU 在空转中争抢资源——第4章会专门展开。
Session 的生命周期可以总结为"创建重、运行轻":创建时把图优化、分区、内存规划全部做完,运行时就只剩 kernel 执行与张量搬运。因此服务架构上的铁律是 Session 复用、模型权重只加载一次。若内存允许,还可以用 create_session 的序列化能力把 .ort 缓存在磁盘,多副本共享,进一步压低冷启动。
核心回顾
- Session 持有优化图与内存
- 混合执行 保证复杂图可跑
- providers 顺序 决定 EP 优先级
- Session 创建 = 图优化 + 分区 + 内存规划,成本高昂
.ort序列化可省掉重复优化,冷启动亚毫秒
下一节:把 EP、Kernel、OrtValue 三个名词落在代码与报错里。