2.1 图加载与常量折叠
2.1 图加载与常量折叠
本节摘要:ORT 解析 GraphProto、Initializer 与 value_info 构建内部 IR。常量折叠在加载期计算纯常量子图,减少 run 时算子数。
加载时发生了什么
.onnx 文件只是一段 Protocol Buffers 序列化数据,ORT 拿到它之后要做的事远不止"读文件"。加载阶段按顺序做四件事:解析(把二进制还原为 ModelProto/GraphProto/NodeProto 三层对象)、校验(语法、图结构、算子语义三层过滤)、形状推断(把 ? 维度解析成符号表达式并写回 value_info)、索引构建(生成输入到节点、节点到输出的映射与拓扑序)。任何一层失败,Session 创建直接报错。
校验的严格程度是设计权衡。ORT 默认只拦截必然崩溃的错误(空输入名、非法枚举值),把"可能低效但语义可行"的情况交给形状推断处理——这样既保证鲁棒,又不扼杀探索性模型的调试空间。常见的 Unsupported operator 报错就发生在语义校验阶段:该 op 在当前 opset 的 Schema Registry 里没有注册。
三类输入信息
| 信息源 | 内容 | 用途 |
|---|---|---|
| GraphProto.node | 算子节点列表 | 构建拓扑序与执行计划 |
| GraphProto.initializer | 权重常量 | 内存规划、常量折叠候选 |
| value_info | 张量类型与形状声明 | 类型检查、形状推断起点 |
权重以 initializer 形式内嵌,不参与运行时计算。加载期会统计全部 initializer 的总字节数并向内存管理器发预分配提示,这决定了权重落在 Arena 的哪个区间。
常量折叠的原理
图上常残留纯常量路径:Shape 对一个常量 shape 的输入取维度、Gather 从常量表查索引、Cast 把常量 FP32 转 INT64。这些节点输入全是 initializer,输出不依赖任何运行时输入,理论上可以在加载期就算完。常量折叠把这些节点替换成结果常量,run 阶段直接少执行一串算子。
# 折叠前:Shape -> Gather -> Unsqueeze 一串节点 # 折叠后:直接是一个 int64 常量 import onnx m = onnx.load("model.onnx") # 用 onnx 自带优化器模拟折叠意图(ORT 内部逻辑等价) from onnx import optimizer passes = ["extract_constant_to_initializer", "eliminate_duplicate_initializer", "eliminate_deadend"] m = optimizer.optimize(m, passes)
模型 500MB 但首帧慢,一个高频根因就是残留 Shape/Gather 常量链:本可在加载时折叠掉,却留到每次 run 都执行一遍。折叠的收益不只是省时间,还让图变小、节点数变少,后续融合 pass 的目标更干净。
优化级别与配置
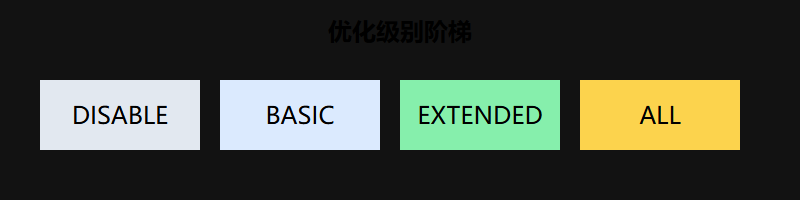
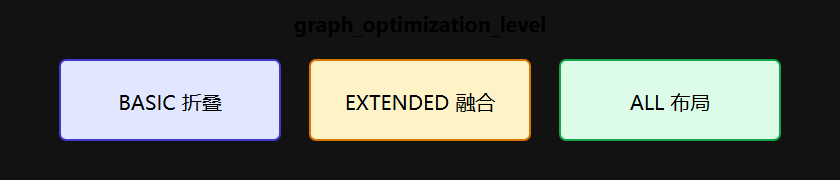
ORT 把优化 pass 打包成三档级别,越往上 pass 越多、越激进,同时创建耗时越长、语义风险越高:
| 级别 | 典型 Pass | 适用 |
|---|---|---|
| ORT_ENABLE_BASIC | 常量折叠、冗余消除 | 调试、快速验证 |
| ORT_ENABLE_EXTENDED | + 融合、布局改写 | 生产默认 |
| ORT_ENABLE_ALL | + 实验性 Pass | 压榨极致性能 |
import onnxruntime as ort so = ort.SessionOptions() so.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_EXTENDED so.optimized_model_filepath = "model_opt.ort" # 导出优化后图 sess = ort.InferenceSession("model.onnx", sess_options=so, providers=["CPUExecutionProvider"])
# 命令行对比不同级别下的创建耗时与首帧延迟 ORT_LOG_LEVEL=VERBOSE python run_bench.py --level BASIC ORT_LOG_LEVEL=VERBOSE python run_bench.py --level EXTENDED
形状推断:图活化的第一步
静态形状推断在加载期沿着图做符号化传播:已知输入形状作初始条件,逐节点用算子的 shape inference function 计算输出形状。对 Conv 来说,输出高度满足 H_out = floor((H + 2p - K)/s) + 1;对动态维度,ORT 把 ? 映射成符号变量(如 N)并支持代数运算,concat 两个形状为 N×1024 与 N×512 的分支可安全推断为 N×1536。
# 在导出侧先做一次 shape inference,尽早发现维度歧义 import onnx m = onnx.load("model.onnx") inferred = onnx.shape_inference.infer_shapes(m) for vi in inferred.graph.value_info: dims = [d.dim_value if d.dim_value else d.dim_param or "?" for d in vi.type.tensor_type.shape.dim] if "?" in dims: print("未推断维度:", vi.name, dims)
形状推断完成后,所有张量的秩与维度符号表达式成为图的不变量——后续任何融合、布局变换都必须保持该不变量。这也是"优化安全"的基石:没有形状稳定性,就没有优化可信度。动态 shape 模型的推断结果带符号变量,后续内存规划只能按最大档位预分配,这是第4章 mem_pattern 失效的根源之一。
验证优化是否生效
优化级别不是配置了就一定生效。用三种手段确认:
import onnxruntime as ort so = ort.SessionOptions() so.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_EXTENDED so.optimized_model_filepath = "opt.ort" sess = ort.InferenceSession("model.onnx", sess_options=so, providers=["CPUExecutionProvider"]) # 1) 优化后图导出到 opt.ort,对比节点数 # 2) 日志级别 VERBOSE 打印每个 pass 的命中情况 # 3) 记录 Session 创建耗时,对比不同级别
# 统计优化前后节点数变化 python -c " import onnx for p in ['model.onnx','opt.ort']: m = onnx.load(p) print(p, len(m.graph.node)) "
节点数明显下降说明折叠与融合在生效;若几乎没变化,要么模型本身不含可优化模式,要么优化级别被 providers 配置压低了(某些 EP 会限制 pass 集合)。
判断直觉与常见误区
⚠️ INT8 QDQ 图用 EXTENDED 可能错误融合——Q/DQ 与相邻算子的融合规则在不同版本间有行为差异,量化模型先用 BASIC 验证精度,再用 EXTENDED/ALL 提速,分两步走。
💡 首帧慢先对比 BASIC vs EXTENDED 创建时间。若 EXTENDED 创建耗时是 BASIC 的数倍且 run 收益不明显,说明优化 pass 在无效图上空转,考虑降低级别或用 .ort 缓存跳过重复优化。
重点提炼
- 加载 = 解析 + 校验 + 形状推断 + 索引构建,任一环节失败即创建失败
- 常量折叠 消除 Shape/Gather/Cast 常量链,减少 run 节点数
- 优化级别 是收益与风险的权衡旋钮,生产默认 EXTENDED
- INT8 QDQ 模型先 BASIC 验证再提速
.ort序列化跳过重复优化,压低冷启动- 首帧慢优先怀疑折叠不彻底或级别配置不当
下一节:算子融合与布局改写——把相邻算子合并成单个 kernel。