2.2 算子融合与布局改写
2.2 算子融合与布局改写
本节摘要:Graph Optimizer 将 Conv+BN+Relu、MatMul+Add+Gelu 等合并为单 kernel,减少 launch 与带宽。布局改写对齐 EP 偏好的 NCHW/NHWC。
为什么融合能带来数量级收益
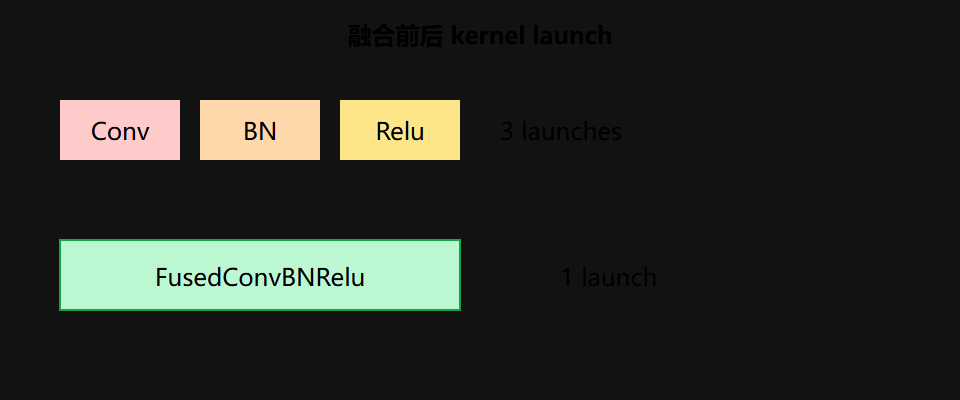
Profile 里 Conv、BN、Relu 各占 8%,看起来都不大,但三者合并后往往只剩一个 kernel——这是图优化里最直观的收益来源。融合省掉的不只是三次 kernel 启动的开销,还有每两次算子之间的一整轮"写全局内存 + 再读回":BN 的中间结果和 Relu 的中间结果都不需要落盘,直接在寄存器或共享内存里流转。对带宽受限的模型,这种中间张量消除往往比计算本身的优化更值钱。
融合的数学前提是语义等价。以 Conv+BN+ReLU 为例:BN 的推理公式是 y = gamma * (x - mean) / sqrt(var + eps) + beta,对固定权重来说可以展开成 y = a * x + b,其中 a = gamma / sqrt(var + eps),b = beta - a * mean。展开后 BN 就变成一个逐元素仿射变换,可以吸收进 Conv 的权重与偏置:
# 融合前:Conv(weight, bias) -> BN(gamma, beta, mean, var) # 融合后:Conv(weight', bias') # weight' = weight * a # bias' = (bias - mean) * a + beta # 其中 a = gamma / sqrt(var + eps)
ReLU 只是逐元素 max(x, 0),与 Conv 组合后也可以折叠进同一个 kernel 的末尾计算。于是三个算子变成一次 CUDA kernel launch。注意这里的关键前提:BN 在推理时用的是训练期累积的统计量,不是 batch 内的实时统计——导出模型时 BN 已经被算子序列展开,融合 pass 才能识别并吸收。
融合的收益机制
| 层面 | 未融合 | 融合后 |
|---|---|---|
| kernel launch | 3 次 | 1 次 |
| 中间张量 | 2 个完整张量写入显存再读回 | 0 个 |
| 寄存器复用 | 无 | Conv 输出直接喂给激活 |
| 调度开销 | 3 次排队 | 1 次入队 |
对 GPU 而言,launch 与同步的开销通常在微秒级,真正的收益来自省掉的中间张量读写。对 CPU 而言,融合还能提升 cache 命中率:小张量完全待在 L1/L2 里不落地。
常见的可融合模式
ORT 的 fusion pass 覆盖一组高频模式,识别它们就知道模型有没有被正确优化:
| 模式 | 融合后节点 | 说明 |
|---|---|---|
| Conv + BatchNorm + Relu | FusedConv | 数学吸收,最经典 |
| MatMul + Add + Gelu | FusedGelu / FastGelu | Transformer 高频 |
| LayerNorm 七步拆解 | FusedLayerNorm | ReduceMean/Sub/Pow 合并 |
| Attention 的 QKV 拼接 | FusedAttention | 单 kernel 内完成 |
| Embedding + LayerNorm | FusedEmbedLayerNorm | 省两次全局内存读写 |
以 BERT 为例,ORT 的 FusedEmbedLayerNorm 把 Embedding 查表、LayerNorm 归一化、QKV 线性变换流水化进一次 kernel,实测在 V100 上吞吐提升约 2.3 倍——这是"跨层协同"的典型收益,比单纯换 CUDA 版本来得更猛。
布局改写:对齐 EP 的偏好
同一份张量,数据可以按 NCHW 或 NHWC 排列。cuDNN 对卷积通常偏好 NHWC,MLAS 在 CPU 上偏好 NCHW。布局改写 pass 会把张量在算子边界上转成目标 EP 更快的布局,代价是在转变处插入一个 Transpose。收益是否为正,取决于"省下的计算时间"是否大于"转置的搬运时间"。
# ORT 允许按 EP 选择是否开启 layout 优化 so = ort.SessionOptions() # NHWC 优化在 CPU/GPU EP 上默认开启,极端小模型可关闭对比
融合的语义等价验证
融合不是"看着像就合",每类融合都有严格的等价前提。以 Conv+BN 为例,吸收公式成立的条件是:BN 处于推理模式(使用累积统计量)、eps 大于零、卷积无特殊 dilation 导致边界行为变化。ORT 的 pass 会做静态检查,命中不了就保持原样——这通常不是 bug,而是保守。
# 手工验证一个融合候选是否等价(以 Conv+BN 吸收为例) import torch import torch.nn as nn torch.manual_seed(0) conv = nn.Conv2d(4, 8, 3, padding=1) bn = nn.BatchNorm2d(8) bn.eval() x = torch.randn(2, 4, 16, 16) with torch.no_grad(): y_ref = bn(conv(x)) # 手工吸收 with torch.no_grad(): a = bn.weight / torch.sqrt(bn.running_var + bn.eps) b = bn.bias - a * bn.running_mean w_f = conv.weight * a.view(8, 1, 1, 1) b_f = (conv.bias - bn.running_mean) * a + bn.bias y_fused = torch.nn.functional.conv2d( x, w_f, b_f, stride=1, padding=1) print("max diff:", (y_ref - y_fused).abs().max().item())
输出应该接近 1e-6 量级——吸收在数学上等价,残差仅来自浮点运算顺序。这类验证脚本值得沉淀进团队工具库,每次怀疑"融合是否改变了语义"时跑一遍。
布局改写与 Transpose 成本
布局改写的收益需要量化。对一个 N×C×H×W 的特征图,NCHW→NHWC 的转置是完整的张量重排,代价是 N*C*H*W*4 字节的读写。当算子本身计算密集(大卷积核、大通道数)时,转置成本占比小、收益为正;当模型是纯逐元素算子链时,转置往往得不偿失。
判断方法:导出优化后图,统计 Transpose 节点数量与位置。若 Transpose 密集出现在小特征图之间,考虑在导出侧直接用 channels_last=True 让 PyTorch 一开始就产出 NHWC,从源头消掉转置。
融合失败的排查
融合不总是成功。常见原因:输入 shape 动态导致无法静态证明等价;BN 的 eps 或算子属性不匹配;中间节点被其它算子消费导致无法吸收;Q/DQ 量化节点的插入把模式切碎。排查办法是把优化后的图导出,逐个核对模式是否仍在:
so.optimized_model_filepath = "model_opt.ort" sess = ort.InferenceSession("model.onnx", sess_options=so) # 用 onnx 工具加载 model_opt.ort,检查是否还有独立的 BN/Relu 节点
判断直觉与常见误区
💡 融合收益先看带宽不看计算。如果模型中间张量巨大(比如分割模型的高分辨率特征图),融合省下的读写才是大头;小模型反而可能被融合 pass 的元数据开销拖累。
⚠️ 融合只保证语义等价,不保证逐 bit 相同。吸收 BN 后浮点运算顺序变化,误差在 1e-7 量级正常;如果对 bit 级一致性有强制要求,需要固定 BASIC 级别并接受性能损失。
本章回顾
- 融合 降 launch 与带宽,最大收益来自省中间张量
- 布局改写 服务 EP 偏好,代价是边界 Transpose
- 语义等价 ≠ 逐 bit 相同,验收按业务指标
- 融合失败先查动态 shape 与 QDQ 插入点
- 导出优化后图做模式核对,是最直接的融合审计
- 高频模式(Conv-BN-ReLU、FusedGelu、FusedLayerNorm)需熟记
下一节:图分区——融合完的图如何切给多个 EP。