3.1 EP 接口与优先级策略
3.1 EP 接口与优先级策略
本节摘要:每个 EP 实现 GetCapability、kernel 注册与设备内存管理。providers 列表顺序即优先级:前者先接管节点。
配置了 CUDA 却仍走 CPU
最常见的 EP 事故:代码里写了 CUDAExecutionProvider,日志或耗时显示模型仍然在 CPU 上跑。排查顺序固定为三步——第一,确认装的是 onnxruntime-gpu 而不是 CPU 版 wheel;第二,确认 CUDA/cuDNN 版本与 ORT 的兼容矩阵匹配;第三,打印 sess.get_providers() 看实际激活列表。多数情况下前两步之一就是答案,不必深挖模型。
EP 是 ORT 的"硬件外交官",它只承诺三件事:声明能力、注册 kernel、管设备内存。理解这三件事的边界,就不会在"配置了但没生效"上浪费太多时间。
EP 的三项核心职责
| 职责 | 接口 | 失败表现 |
|---|---|---|
| 声明能力 | GetCapability() | EP 不接管任何节点 |
| 注册 kernel | RegisterOps() | 节点找不到 kernel,回退 CPU |
| 设备内存管理 | Allocate/Free | 张量无法跨 device 搬运 |
GetCapability() 是分区器的输入:它返回该 EP 能接管的节点集合与约束(类型、shape、domain)。RegisterOps() 把 EP 的 kernel 实现登记进全局注册表。两者都正常,节点才会真正落在该 EP 上。
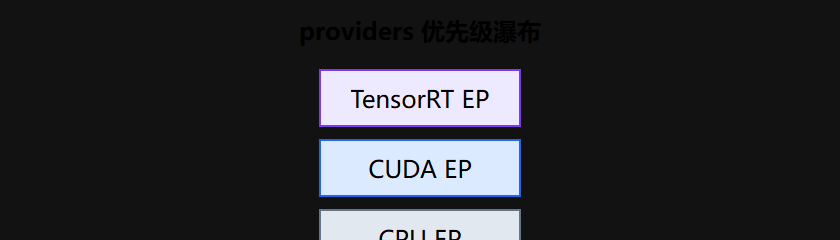
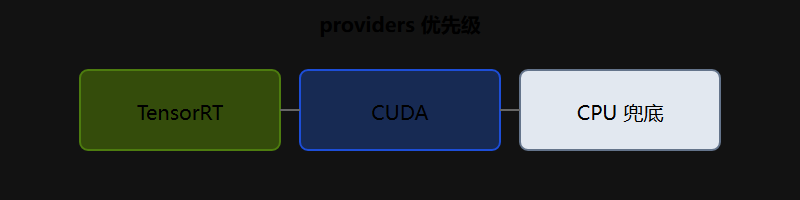
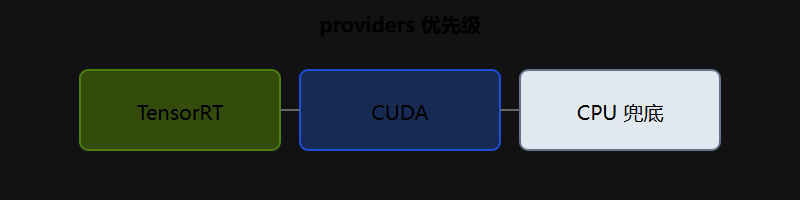
providers 顺序即优先级
ORT 按 providers 列表顺序询问 EP 能否接管子图,先声明者先挑。顺序不对是最隐蔽的坑:把 CPU 放前面,整图被 CPU 全量接管,GPU 白配。
import onnxruntime as ort # 正确:GPU 在前,CPU 兜底 sess = ort.InferenceSession( "model.onnx", providers=[ "TensorrtExecutionProvider", "CUDAExecutionProvider", "CPUExecutionProvider", ], ) # 验证实际激活列表 print(sess.get_providers()) # 输出形如: ['TensorrtExecutionProvider', 'CUDAExecutionProvider', 'CPUExecutionProvider'] # 查看每个节点最终落在哪个 EP(结构化诊断) # 开启 verbose 日志,日志会打印 subgraph 到 EP 的映射
get_providers() 返回的是"已激活"的 EP,不是"配置了"的 EP。CPU 版 wheel 即使配置 CUDA,列表里也只有 CPU——这一行输出直接暴露环境问题。
配置与验证的完整流程
import onnxruntime as ort import numpy as np def build_session(model_path, providers): so = ort.SessionOptions() so.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_EXTENDED sess = ort.InferenceSession(model_path, sess_options=so, providers=providers) return sess sess = build_session("model.onnx", [ "CUDAExecutionProvider", "CPUExecutionProvider", ]) # 运行前验证 EP 生效 assert "CUDAExecutionProvider" in sess.get_providers(), "CUDA EP 未激活" # 用 IO Binding 确认张量落在 GPU x = np.random.randn(1, 3, 224, 224).astype(np.float32) out = sess.run(None, {"input": x})[0] print("shape:", out.shape)
若 CUDA EP 激活但运行耗时没下降,再查分区日志确认 backbone 是否真的被 CUDA 接管——GPU 只跑了一个 Reshape、其余全在 CPU 的情况完全可能发生。
常见场景的 providers 配置
| 场景 | providers 顺序 | 备注 |
|---|---|---|
| 云 A100 | TensorRT → CUDA → CPU | TRT 编译子图,CUDA 兜底 |
| 开发/调试 | CPU only | 免环境依赖 |
| Windows 桌面 | DirectML → CPU | 无 CUDA 也能用 GPU |
| Jetson 边缘 | CUDA → CPU | 板载 GPU,TRT 按需 |
判断直觉与常见误区
⚠️ CPU 版 wheel 传 CUDA provider——silent fallback。不报错、不警告,get_providers() 里就是没有。装包时确认 onnxruntime-gpu 的版本与 CUDA 版本配套。
💡 get_providers() 返回实际激活列表。任何"配置了 EP 但怀疑没生效"的疑问,先跑这一行,再谈别的。
配置 EP 的黄金流程:装对 build → 核对版本矩阵 → 顺序写对 → 打印激活列表 → 查分区日志。五步走完,EP 相关的坑基本清空。
要点速记
- GetCapability 决定接管范围,RegisterOps 决定 kernel 可用性
- providers 顺序即优先级,GPU 必须排在 CPU 前
- get_providers() 是验证唯一入口
- CPU 版 wheel 会静默回退,先查环境
- 激活了不等于接管了,分区日志做二次确认
EP 激活的完整诊断脚本
把"配置了 EP 但没生效"的排查固化成脚本,部署时直接跑:
import onnxruntime as ort def diagnose_ep(model_path, desired): print("ort version:", ort.__version__) print("device:", ort.get_device()) # GPU 还是 CPU sess = ort.InferenceSession(model_path, providers=[*desired, "CPUExecutionProvider"]) active = sess.get_providers() print("desired:", desired) print("active :", active) missing = [d for d in desired if d not in active] if missing: print("NOT ACTIVE:", missing) print("检查: 是否装了 onnxruntime-gpu / 版本兼容矩阵 / CUDA 驱动") else: print("全部激活 OK") return active diagnose_ep("model.onnx", ["CUDAExecutionProvider"])
脚本把三个最容易混淆的状态分开打印:版本、设备、激活列表。get_device() 返回 "GPU" 只说明 wheel 是 GPU 版,不代表 EP 就绪——EP 激活还依赖运行时库与驱动。
常见问题速查
| 症状 | 直接原因 | 处置 |
|---|---|---|
| get_providers 无 CUDA | CPU 版 wheel | 装 onnxruntime-gpu |
| get_providers 有 CUDA 但慢 | backbone 未被接管 | 查分区日志 |
| 启动报 cudnn 错误 | 库版本不匹配 | 对齐兼容矩阵 |
| TRT EP 不激活 | TRT 库缺失或版本旧 | 升级 TRT 并缓存 engine |
| 首次请求超时 | TRT 编译 | 启用 engine 缓存 |
EP 与图优化的联动
EP 不只是执行者,它还会反过来影响图优化。某些 EP 注册时会声明"我能处理融合后的算子",ORT 的优化 pass 才敢做对应的融合;反之,EP 能力窄时,优化 pass 会保守处理。这就是为什么同一个模型在 CPU EP 下融合得好、在 DML EP 下却出现碎片化小算子。
# 观察 EP 对优化行为的影响 import onnxruntime as ort for providers in (["CPUExecutionProvider"], ["DmlExecutionProvider"]): so = ort.SessionOptions() so.graph_optimization_level = ort.GraphOptimizationLevel.ORT_ENABLE_EXTENDED so.optimized_model_filepath = "opt_" + providers[0] + ".ort" try: sess = ort.InferenceSession("model.onnx", sess_options=so, providers=providers) print(providers[0], "->", sess.get_providers()) except Exception as e: print(providers[0], "创建失败:", e)
同一模型导出两份优化图,用 onnx.load 对比节点数,就能看出 EP 对融合 pass 的实际影响。这也是"同一个模型在不同 EP 上延迟不同"的第三个解释维度:除了 kernel 速度与分区边界,还有融合程度差异。
下一节:CUDA、TensorRT 与 DML 三选一。