3.2 CUDA、TensorRT 与 DML 选型
3.2 CUDA、TensorRT 与 DML 选型
本节摘要:CUDA EP 通用;TensorRT EP 编译整图获低延迟;DirectML EP 在 Windows 通过 DX12 用 GPU,无需 CUDA。
三个 EP 三套取舍
选 EP 不是"哪个快用哪个",而是先画三根线:部署平台(Linux/NVIDIA、Windows 桌面、ARM 边缘)、延迟预算(毫秒级还是几十毫秒)、构建成本(CUDA 环境 vs 无驱动依赖)。三个 EP 代表三种完全不同的执行模型,配置代码只差一行,行为却大相径庭。
| 维度 | CUDA EP | TensorRT EP | DirectML EP |
|---|---|---|---|
| 依赖 | CUDA + cuDNN | + TensorRT 库 | DX12,无需 CUDA |
| 接管粒度 | 节点级 | 子图编译 | 节点级 |
| 首启成本 | 低 | 高(编译 engine) | 低 |
| 精度选项 | FP32/FP16 | FP32/FP16/INT8/TF32 | FP32/FP16 |
| 适用 | 通用 GPU 推理 | 极致延迟 | Windows 笔记本 |
CUDA EP 是"翻译官":每个算子直接映射到 cuDNN/cuBLAS 调用,灵活、首启快、适配任何图。TensorRT EP 是"编译器":整段子图被编译成优化 engine,做层融合与 kernel 自动调优,同模型同硬件往往比 CUDA 再快 20%~50%,但编译一次可能耗时数分钟。DirectML 是 Windows 的"通用钥匙":通过 DX12 用任何 GPU(NVIDIA/AMD/Intel 核显),不必装 CUDA 栈,适合 Windows 桌面与笔记本。
CUDA EP 配置
import onnxruntime as ort cuda_opts = { "device_id": 0, "cudnn_conv_algo_search": "HEURISTIC", # 或 EXHAUSTIVE(首帧更慢) "arena_extend_strategy": "kSameAsRequested", } sess = ort.InferenceSession( "model.onnx", providers=[("CUDAExecutionProvider", cuda_opts), "CPUExecutionProvider"], ) print(sess.get_providers())
CUDA EP 的选项集中在三处:选哪张卡(device_id)、卷积算法怎么搜(cudnn_conv_algo_search)、显存池怎么扩(arena_extend_strategy)。HEURISTIC 用启发式选算法,EXHAUSTIVE 逐个试最优但首帧能慢几十秒——服务端首次请求会直接超时。
TensorRT EP 配置与 engine 缓存
trt_opts = { "trt_fp16_enable": True, "trt_int8_enable": False, "trt_max_workspace_size": 2147483648, "trt_engine_cache_enable": True, # 缓存编译结果 "trt_engine_cache_path": "./trt_cache", # 下次直接加载 } sess = ort.InferenceSession( "model.onnx", providers=[ ("TensorrtExecutionProvider", trt_opts), ("CUDAExecutionProvider", {}), "CPUExecutionProvider", ], )
⚠️ TRT 首启编译 10 分钟+——需缓存 engine。不启用 trt_engine_cache_enable 的话,每次进程重启都要重新编译,部署时首帧直接超时。缓存路径要与模型版本绑定,模型一变缓存作废,靠 CI 的哈希命名来管。
💡 开发用 CUDA,上线 TRT 压延迟。CUDA EP 调试方便、报错清晰;确认模型与精度后切 TRT,用同一套 IO Binding 代码,配置层面只改 providers。
DirectML EP 配置
# Windows 上无 CUDA 环境也能用 GPU sess = ort.InferenceSession( "model.onnx", providers=["DmlExecutionProvider", "CPUExecutionProvider"], )
DML 的优势是"零安装":Windows 自带 DX12 驱动,不需要装 CUDA、cuDNN、TensorRT。代价是性能通常弱于 CUDA EP(尤其对 FP16),且算子支持列表略窄,复杂图会更多回退 CPU。它的定位是让 Windows 桌面应用快速获得 GPU 加速,而不是替代专业推理服务。
MLPerf 与收益量级
2023 MLPerf:ORT+TensorRT EP 的 ResNet-50 在 A100 上相对 PyTorch 功耗降约 37%、延迟降约 42%(产业基准,以你的模型为准)。这个数字的意义不是"一定能复现",而是说明引擎选型 + 图优化的联合收益是数量级的——比单纯升硬件更值得先做。自己验证时用同一模型、同一 batch、同一精度,分别跑 CPU EP、CUDA EP、TRT EP,记录 P50/P99 与功耗。
# 快速对比三个 EP 的延迟 python bench_eps.py --model model.onnx --providers cpu python bench_eps.py --model model.onnx --providers cuda python bench_eps.py --model model.onnx --providers tensorrt
判断直觉与常见误区
⚠️ DirectML 上 IO Binding 语义与 CUDA 不同——device 枚举与内存类型别照抄 CUDA 的代码,DML 有自己的 OrtDevice 映射。
💡 CPU→CUDA→TRT 的收益通常是递增但边际递减。先拿到 CUDA EP 的稳定基线,再评估是否值得为 TRT 引入编译缓存与版本管理的复杂度。
一节小结
- CUDA 通用,TRT 极致,DML 覆盖 Windows
- TRT 需 engine 缓存,否则首帧超时
- CUDA 调 conv algo 影响首帧,生产用 HEURISTIC
- DML 免驱动安装,性能弱于 CUDA
- MLPerf 案例说明级联价值,自己用 bench 验证
- 选型先画平台/延迟/构建成本三根线
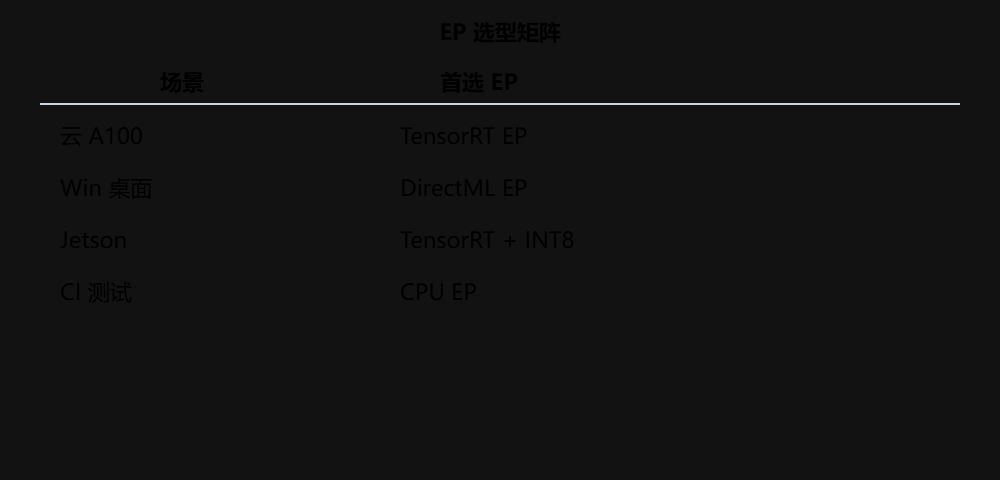
三 EP 的精度与验收差异
切 EP 之后精度可能变化,验收要按 EP 分层做。CUDA EP 默认 FP32,与 CPU FP32 基线几乎一致;TRT 开 FP16 后误差到 1e-3 量级;DML 的 FP16 实现因厂商而异。选型文档里应写明每个 EP 的精度模式与验收阈值,避免"换 EP 后指标波动"被误判为模型问题。
| EP | 默认精度 | 误差量级 | 验收注意 |
|---|---|---|---|
| CUDA | FP32 | 1e-7 | 与 CPU 基线对齐 |
| CUDA+TF32 | TF32 | 1e-3 | 明确是否开启 |
| TensorRT | FP32/FP16/INT8 | 1e-3~1e-2 | 敏感层排除 |
| DirectML | FP32/FP16 | 视厂商 | 逐算子对比 |
# 换 EP 后快速验收:同一输入对比 FP32 CPU 基线 import numpy as np import onnxruntime as ort def verify_eps(model, feeds, ep_providers): base = ort.InferenceSession(model, providers=["CPUExecutionProvider"]) y_base = base.run(None, feeds)[0] for name, provs in ep_providers.items(): sess = ort.InferenceSession(model, providers=provs) y = sess.run(None, feeds)[0] err = np.abs(y.astype(np.float64) - y_base.astype(np.float64)).max() print(f"{name}: max_err={err:.2e}")
换 EP 的迁移清单
从 CUDA 换 TRT、或从 TRT 换 CUDA,不只是改 providers 一行代码:
- 确认模型 opset 被目标 EP 支持(TRT 对某些新算子支持滞后)
- 精度验收:FP32 基线对比,敏感层记录误差
- 首启成本:TRT 需 engine 缓存路径与版本命名
- 内存策略:TRT 的 workspace 与 CUDA Arena 不共享
- CI 更新:get_providers 断言改为目标 EP
迁移完成的标准不是"能跑",而是"延迟、精度、内存三项都有基线对比记录"。
下一节:标准算子覆盖不了时,Custom Op 出场。