3.3 自定义算子扩展
3.3 自定义算子扩展
本节摘要:当 OpSet 无法表达领域算子(点云 Voxelization、B 样条、FlashAttention 变体)时,通过 Custom Op 三层契约(图/执行/内核)注册到 EP,由 Kernel Factory 分离算法与设备逻辑。
遇到标准之外的算子
导出 ONNX 报 Unknown operator: com.mycompany::SparseConv3d——标准 OpSet 没有该算子。改写成 20 个基础 Op 会丢性能且难维护;正确路径是 Custom Op + 目标 EP 原生 kernel。Custom Op 不是补丁,而是 ORT 可编程性接口:在 ONNX 静态拓扑上注入可验证、可调度的计算单元,同时遵守标准图的优化纪律。
Custom Op 与 Experimental Op 的分工要分清:Experimental Op 是 ONNX 官方/ORT 主干里"灰度验证"的新算子,随版本演进;Custom Op 是用户自己的 domain 下的算子,完全由用户维护契约与 kernel。前者等官方转正,后者自建体系。
三层契约
| 契约层 | 约束 | 失败表现 |
|---|---|---|
| 图层 | domain、name、I/O、attributes | checker 拒绝加载 |
| 执行层 | CreateKernel、Compute、GetSupportedDeviceTypes | EP 不接管 |
| 内核层 | Layout、DataType、in-place 规则 | Compute 入口报错 |
图层契约决定图是否合法:domain、算子名、输入输出数量与类型、attributes 必须与导出侧声明一致,任何不一致都在加载期暴露。执行层契约决定 EP 是否愿意接管:GetSupportedDeviceTypes 声明算子能在哪些设备上跑,分区器据此决定子图归属。内核层契约决定计算是否正确:Compute() 里处理张量、调用设备代码,布局与类型假设错了就在运行时炸。
C++ 侧注册与实现
Custom Op 的核心在 C++:定义一个继承自 Ort::CustomOp 的类,实现 CreateKernel、GetName、GetExecutionProviderType,再用 Ort::CustomOpDomain 注册进全局 domain:
#include <onnxruntime_cxx_api.h> struct SparseConv3dKernel { void Compute(OrtKernelContext* ctx) { // 取输入输出,调用目标 EP 的原生实现(CUDA kernel / CPU 实现) } }; struct SparseConv3dCustomOp : Ort::CustomOpBase<SparseConv3dCustomOp, SparseConv3dKernel> { void* CreateKernel(const OrtApi&, const OrtKernelInfo*) const { return new SparseConv3dKernel(); } const char* GetName() const { return "SparseConv3d"; } const char* GetExecutionProviderType() const { return "CUDAExecutionProvider"; } }; // 注册入口 Ort::CustomOpDomain domain{"com.mycompany"}; domain.Add(&sparse_conv_op); Ort::SessionOptions so; so.AddCustomOpDomain(domain);
关键点:GetExecutionProviderType() 决定该 kernel 挂到哪个 EP,返回 "CPUExecutionProvider" 则只在 CPU 注册,返回 CUDA 则需要同时提供设备端 kernel 与内存管理。多 EP 支持就是注册多个实例。
Python 侧加载
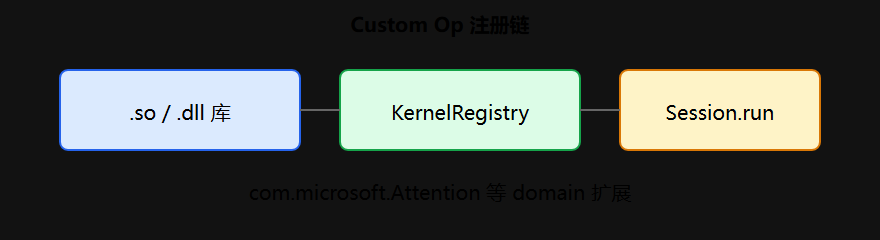
编译产物(.dll / .so)通过 register_custom_ops_library 一行加载,Python 侧无需重写任何算法逻辑:
import onnxruntime as ort so = ort.SessionOptions() so.register_custom_ops_library("libmy_custom_ops.so") sess = ort.InferenceSession( "model_with_custom.onnx", sess_options=so, providers=["CUDAExecutionProvider", "CPUExecutionProvider"], )
加载顺序有讲究:先注册 library,再建 Session。library 未注册时 Session 创建直接报 Unknown operator——与导出侧报错不同,这里是"图里有,运行时没有实现"。
工程实践要点
- 导出时在 ONNX 保留
domain与版本属性,与 C++ 注册的 domain 严格一致 - 为 Custom Op 单独维护 EP capability 文档:哪些设备支持、精度要求、shape 约束
- 与 2.3 图分区联调:Custom 子图须整段由支持 EP 接管,否则边界拷贝吃掉收益
- CI 里编译 custom library 并跑目标 EP 的 smoke test,避免"本地能跑、部署不能跑"
- 版本管理:domain 版本与算子 schema 一起升,破坏性变更走新版本号
判断直觉与常见误区
⚠️ Custom Op 节点会被图优化 pass 谨慎对待——ORT 对自定义 domain 的节点不套标准融合规则,优化收益需要自己用原生 kernel 实现来保证,别指望自动融合。
💡 能用标准算子组合解决就不要上 Custom Op。Custom Op 引入编译、分发、版本三份维护成本;只有标准组合带来不可接受的性能损失时才值得。
核心回顾
- 三层契约 保证图合法、EP 调度、内核语义
- Factory/Instance 分离算法与系统
- register_custom_ops_library 加载扩展
- CI 须含目标 EP + custom 库
- 标准滞后时的正规扩展路径
- domain/版本与 schema 一致是加载成功的前提
调试 Custom Op 的标准步骤
Custom Op 出问题时,报错集中在三个阶段,按阶段收窄:
| 阶段 | 报错特征 | 检查点 |
|---|---|---|
| 加载 | Unknown operator | domain/name 拼写、库已注册 |
| 分区 | EP 不接管 | GetSupportedDeviceTypes 返回值 |
| 运行 | Compute 内异常 | 张量 shape/type 假设、设备内存 |
import onnxruntime as ort # 加载阶段排查:先注册再建 Session,并捕获明确错误 so = ort.SessionOptions() try: so.register_custom_ops_library("libmy_custom_ops.so") sess = ort.InferenceSession("model.onnx", sess_options=so, providers=["CUDAExecutionProvider"]) except Exception as e: print("加载失败:", e) # 运行阶段:用小输入触发,观察 Compute 内是否抛错 import numpy as np try: out = sess.run(None, {"input": np.random.randn(1, 3, 64, 64).astype(np.float32)}) print("OK", [o.shape for o in out]) except Exception as e: print("运行失败:", e)
一个高频坑:Custom Op 输出 shape 与导出侧声明不一致。图里的 value_info 在加载期推断 shape,运行期实际输出对不上会直接报错——C++ 侧 CreateKernel 里务必按 schema 声明初始化输出维度。
Custom Op 与性能审计
Custom Op 的性能表现要单独审计,因为标准融合 pass 不碰它。审计三件事:kernel 本身的吞吐、它所在子图的边界拷贝、以及与相邻标准算子的数据搬运。三个信号对应三个动作:
| 信号 | 含义 | 动作 |
|---|---|---|
| 算子耗时长 | kernel 实现效率问题 | 优化内核 / 换算法 |
| 前后大量拷贝 | 边界过多 | 扩大 Custom 子图 |
| 与相邻算子无融合 | 无匹配融合规则 | 手动合并进 kernel |
# 用 Profile 对比"有无 Custom Op"两版模型的延迟分布 # 若 Custom 引入后总延迟反而上升,优先查边界拷贝 import onnxruntime as ort import numpy as np so = ort.SessionOptions() so.register_custom_ops_library("libmy_custom_ops.so") so.enable_profiling = True sess = ort.InferenceSession("model.onnx", sess_options=so, providers=["CUDAExecutionProvider"]) x = np.random.randn(1, 3, 64, 64).astype(np.float32) for _ in range(30): sess.run(None, {"input": x}) print("profile:", sess.end_profiling())
审计结论要写进 Custom Op 的维护文档:性能基线、精度基线、支持设备。否则半年后没人记得这个算子当初为什么存在、它能达到什么水平。
下一章:执行流与 Arena 内存。