5.1 PTQ 与 QAT 工具链
5.1 PTQ 与 QAT 工具链
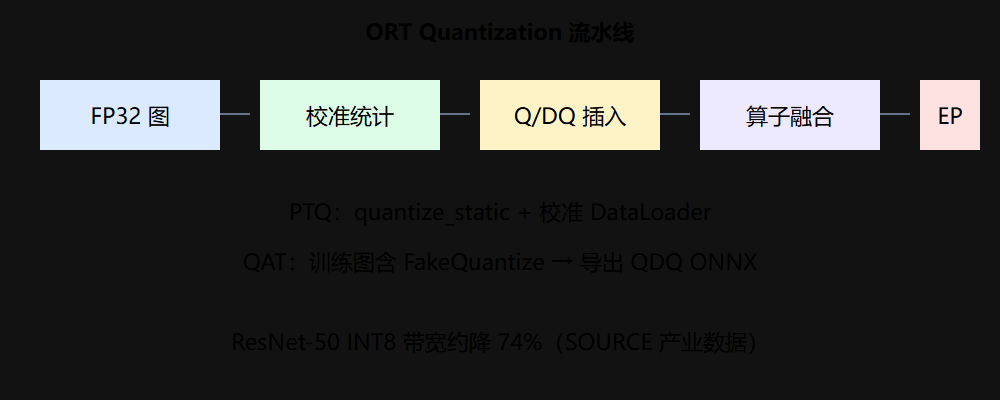
本节摘要:ORT Quantization 把量化视为图重写:识别 Conv/Gemm/MatMul,插入 QuantizeLinear/DequantizeLinear,再融合为 QLinearConv 等。PTQ 用校准集统计激活范围;QAT 在训练期模拟量化,适合 ViT/LLM 等 PTQ 易崩模型。
同一套量化,CNN 和 LLM 冰火两重天
ResNet INT8 掉 0.1% 精度,换 LLM 掉 9 点 MMLU——不是工具坏了,是激活分布太尖峰。量化误差的根源是"用有限档位表示连续范围":CNN 的激活分布近似高斯,铺得开;Transformer 的激活在少数维度上极大、多数维度趋近 0,量化网格要么被极端值拉宽(细节全部丢失),要么截断极端值(信息损失)。这就是为什么同样的 quantize_static 在两类模型上结果天差地别。
ORT 1.16+ 支持混合精度调度:BN 保留 FP32,Conv 走 INT8。这把"全图量化"拆成"按算子选精度",为尖峰分布模型留出一条中间路。
量化的数学基础
对称量化的映射为 Q(x) = clip(round(x / s)),其中 s = max(|x|) / 127;非对称量化带零点:Q(x) = clip(round(x / s) + z),s = (max - min) / 255。ORT 的量化流程本质是图重写:
- 语义审计:识别哪些算子适合量化(Conv/MatMul/Gemm),哪些必须排除(Softmax、LayerNorm)
- 校准:统计每张激活的 min/max 或分布,确定 scale 与 zero_point
- 插入 Q/DQ:在量化算子前后插入 QuantizeLinear/DequantizeLinear 节点
- 融合:Q->Conv->DQ 融合成 QLinearConv,去掉中间的浮点往返
quantize_static 完整流程
from onnxruntime.quantization import quantize_static, QuantType, QuantFormat from onnxruntime.quantization import CalibrationDataReader class CalibReader(CalibrationDataReader): def __init__(self, calib_loader): self.data = iter(calib_loader) self.input_name = "input" def get_next(self): batch = next(self.data, None) if batch is None: return None return {self.input_name: batch.numpy()} calib_reader = CalibReader(calib_loader) # 校准集加载器,覆盖线上分布 quantize_static( model_input="model_fp32.onnx", model_output="model_int8.onnx", calibration_data_reader=calib_reader, weight_type=QuantType.QInt8, quant_format=QuantFormat.QDQ, op_types_to_quantize=["Conv", "MatMul", "Gemm"], extra_options={"ActivationSymmetric": False}, )
CalibrationDataReader 决定校准集喂入方式:一次一个 batch,ORT 逐层记录激活分布。校准集必须是线上真实分布的代表——用训练集可能高估动态范围,用纯噪声则低估,两者都会让线上掉点。
PTQ 与 QAT 的取舍
| 方法 | 训练成本 | 精度 | 适用 |
|---|---|---|---|
| PTQ | 低 | 中 | CNN、稳定分布 |
| QAT | 高 | 高 | Transformer、尖峰激活 |
PTQ 只有校准集这一份数据成本,几十分钟出结果,适合快速迭代;QAT 把"伪量化"嵌入训练循环(forward 里插入 fake quant 节点),模型在训练中学会适应量化噪声,精度上限高,代价是要重训。判断公式:PTQ 掉点超过业务红线 → 先用混合精度调度(敏感层保留 FP32)→ 还不够 → 上 QAT。
工程实践要点
- 校准样本 ≥ 100–500 覆盖场景,包含边界 case
- 导出 QDQ 模型与 TRT EP trt_int8_enable 联调
- ORT Quantization 2.0 统一 PTQ/QAT API(1.16+ 演进方向)
- 每次量化产出必须带一份逐算子 diff 报告,别只看整体指标
- 量化模型同样走图优化,融合 pass 对 Q/DQ 图的行为要验证
判断直觉与常见误区
⚠️ 校准集与线上分布不一致——INT8 线上崩而离线指标正常。离线用测试集验证是"自我感觉良好",线上才是真相;解决靠对齐校准集与线上采样。
💡 LLM/ViT 先 QAT 或混合精度,CNN 先 PTQ 快试。这条直觉帮你把有限调参时间花在对的地方。
要点速记
- 量化 = 图重写 + 校准 + 融合
- quantize_static 是 PTQ 主入口
- QAT 嵌入训练循环,成本高精度高
- 校准集代表线上分布,否则白校准
- CNN 与 Transformer 量化策略不同
- 混合精度调度是尖峰分布的中间路
下一节 INT8 算子与校准细节。
量化结果的验收流程
量化完不算完,验收要过四关:结构(INT8 图可加载)、数值(逐算子 diff)、性能(延迟/带宽收益)、业务(端到端指标)。前两关自动化,后两关按场景定阈值。
import numpy as np import onnxruntime as ort def verify_quant(fp32_model, int8_model, feeds): sess_fp32 = ort.InferenceSession(fp32_model, providers=["CPUExecutionProvider"]) sess_int8 = ort.InferenceSession(int8_model, providers=["CPUExecutionProvider"]) y_fp32 = sess_fp32.run(None, feeds)[0] y_int8 = sess_int8.run(None, feeds)[0] diff = np.abs(y_fp32.astype(np.float64) - y_int8.astype(np.float64)).max() rel = diff / (np.abs(y_fp32).astype(np.float64).max() + 1e-8) print(f"max abs diff = {diff:.4e}, rel = {rel:.4e}") return rel # 多组输入取最差,而不是单组碰运气 worst = 0.0 for feed in test_feeds: worst = max(worst, verify_quant("fp32.onnx", "int8.onnx", feed)) print("worst rel diff:", worst)
验收的另一半是逐算子对比:对中间节点逐个输出 diff,找到误差爆炸的那一层。这一步决定"是校准问题还是算子不可量化",也是 5.2 建立排除清单的依据。
QAT 的落地要点
如果 PTQ + 排除集仍掉点,上 QAT。落地三件事:训练侧插入伪量化节点(PyTorch 的 torch.ao.quantization 或 ONNX 导出前的 fake quant)、训练时冻结 BN 统计、导出后仍需走一遍 ORT 的图重写。QAT 的高成本主要在训练时间与调参,模型结构不用大改,但对敏感层(Softmax 前、长尾注意力)收益明显。经验上 CNN 用 PTQ 足够,Transformer 直接预留 QAT 预算。
常见问题速查
| 症状 | 根因 | 处置 |
|---|---|---|
| 整体掉点 0.5% | 校准集偏差 | 对齐线上采样 |
| 单层误差爆炸 | 该层不可量化 | 加入 nodes_to_exclude |
| 量化后没提速 | EP 无 INT8 kernel | 换支持 EP |
| QDQ 融合失败 | 图结构不匹配 | 提高优化级别 |
| 线上比离线差 | 分布漂移 | 监控 + 重校准 |
校准数据集与误差分析
PTQ 的质量高度依赖校准数据。校准集应覆盖真实部署数据的分布:分类任务每类至少几十张代表性样本,检测任务要包含不同目标尺寸与光照。校准样本过少会导致激活值范围估计偏差,量化后精度大幅抖动;样本过多则校准耗时且收益递减,工程上常用 200~1000 张图像或 1000~5000 条文本批次。
# calibration.py —— 收集激活统计并评估量化误差(示意) import onnxruntime as ort def collect_activations(session, inputs): stats = {} for name, arr in inputs.items(): lo, hi = arr.min(), arr.max() stats[name] = {"min": float(lo), "max": float(hi)} return stats def report_error(metric_q, metric_fp): rel = abs(metric_q - metric_fp) / abs(metric_fp + 1e-9) print(f"相对误差 {rel*100:.2f}%") return rel < 0.05 # 5% 以内认为可接受
误差分析时逐层对比 FP32 与 INT8 输出,定位精度掉得最狠的层:通常是第一个卷积/嵌入层(输入分布宽)与最后的全连接层(对 logits 精度敏感)。针对这些层可退回 FP16 或保留 FP32,实现"混合精度微调"。