5.2 INT8 算子与校准
5.2 INT8 算子与校准
本节摘要:ORT 支持 QLinearMatMul、QLinearConv 等量化算子,校准可选 min-max、Entropy(KL)等方法。权重常用对称量化,激活常用非对称;Attention 的 Softmax 前 logits 对 scale 极敏感。
Attention 输出为何乱码
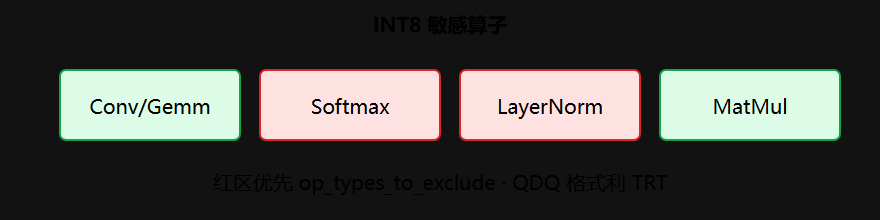
INT8 模型 Conv 正常、Attention 输出乱码——Key scale 偏差 0.3% 即可让 Llama-2-7B 在 MMLU 掉约 9.2 点(SOURCE 引用的 ICLR 2024 类研究量级)。根因是 Softmax 前的 logits 对 scale 极敏感:logits 经过指数运算后被放大,scale 的一点误差会在指数域指数级传播。这类敏感层不能硬量化,需对敏感层保留 FP16 或跳过量化。
这引出一条量化的基本纪律:量化粒度不是"全图开关",而是"逐算子决策"。先量化粗粒度算子(Conv/MatMul/Gemm),用逐算子 diff 找出误差最大的节点,再决定哪些层排除或换精度。
对称与非对称
| 对象 | 常用策略 | 原因 |
|---|---|---|
| 权重 | 对称 per-channel | 分布较稳,范围窄 |
| 激活 | 非对称 per-tensor | 动态范围大,带偏移 |
| Softmax 前 | 常保留 FP16 | 指数放大误差 |
对称量化让零映射到零(适合权重,乘法语义简单),非对称用 zero_point 表示偏移(适合激活,因为 ReLU 后激活非负)。per-channel 与 per-tensor 是量化粒度:per-channel 逐输出通道一个 scale,精度高但计算复杂;per-tensor 整张一个 scale,实现简单。权重用 per-channel、激活用 per-tensor 是经验默认值。
校准方法对比
| 方法 | 特点 | 适用 |
|---|---|---|
| MinMax | 快,易被 outlier 拉宽 | 分布平稳、无极端值 |
| Entropy/KL | 更准,算力稍高 | 一般首选 |
| Percentile | 截断极端值 | 存在少量 outlier |
MinMax 直接用 min/max 定 scale,若激活里有几个极端 outlier,scale 被拉大,正常范围的精度全丢。KL 散度法找"截断到哪个阈值时分布损失最小",自动处理 outlier。Percentile 则是手工截断:99.9 分位以内保留,以外舍弃。选型建议:默认 KL,异常值多时试 Percentile,MinMax 只用于快速原型。
Q/DQ 的数据流
QuantizeLinear 把 FP32 压成 INT8,计算在 INT8 域进行,DequantizeLinear 再还原。QDQ 格式把 Q/DQ 保留在图里,便于 TensorRT 等 EP 识别并做二次融合;QOperator 格式则直接生成 QLinearConv 等算子,图更紧凑但灵活性差。ORT 的默认推荐是 QDQ。
配置代码与敏感层排除
from onnxruntime.quantization import quantize_static, QuantFormat quantize_static( model_input="model_fp32.onnx", model_output="model_int8.onnx", calibration_data_reader=calib_reader, quant_format=QuantFormat.QDQ, op_types_to_quantize=["Conv", "MatMul", "Gemm"], nodes_to_exclude=["/layer1/attn/softmax", "/layer1/attn/dropout"], )
nodes_to_exclude 是量化黑名单:把 LayerNorm、Softmax 及其前驱 logits 节点排除,保留 FP32 计算。排除不是越多越好——每多排除一个节点,INT8 的带宽收益就少一分,正确做法是用 diff 报告决定排除集。
判断直觉与常见误区
⚠️ 全图 INT8 不 exclusions——LayerNorm、Softmax 应进黑名单。量化失败的模型九成是黑名单没建好,而不是校准方法没选对。
💡 量化后分算子对比 FP32 输出,先找最大 diff 节点再决定 exclusions。数据说话,比猜测"哪个层敏感"可靠得多。
硬件差异要留意:Hexagon DSP 支持 INT4×INT4,OpenVINO 走 INT8+FP16 混合——同一 INT8 ONNX 在不同 EP 上 kernel 不同,精度与性能都要按 EP 验收。
本节小结
- 权重对称 per-channel,激活非对称 per-tensor
- 校准默认 KL,outlier 多时 Percentile
- QDQ 格式利于 EP 二次融合
- Softmax 前 logits 是量化红线,必须排除
- 量化粒度是逐算子决策,靠 diff 报告驱动
- 同一 INT8 图在不同 EP 上行为不同
逐算子 diff 报告实践
排除清单不能靠猜,要有一份逐算子 diff 报告。实现方式:给量化模型的每个中间节点挂输出名,与 FP32 模型逐层对比。ORT 支持用 output_names 取任意中间张量:
import numpy as np import onnxruntime as ort def collect_intermediates(model, feed): sess = ort.InferenceSession(model, providers=["CPUExecutionProvider"]) names = [n.name for n in sess.get_inputs()] + [ n.name for n in sess.get_outputs()] out = sess.run(None, feed) return dict(zip(names, out)) def diff_report(fp32_model, int8_model, feed): a = collect_intermediates(fp32_model, feed) b = collect_intermediates(int8_model, feed) rows = [] for k in a: if k in b and a[k].shape == b[k].shape: d = np.abs(a[k].astype(np.float64) - b[k].astype(np.float64)).max() rows.append((k, d)) rows.sort(key=lambda x: -x[1]) for name, d in rows[:10]: print(f"{name}: {d:.4e}") feed = {"input": np.random.randn(1, 3, 224, 224).astype(np.float32)} diff_report("fp32.onnx", "int8.onnx", feed)
误差排前几名的节点就是排除清单的候选。规则:误差超过全局中位数两个数量级的节点,先进排除集再重测;连续迭代两三轮后误差曲线趋于平缓,说明排除集已收敛。
校准集的工程规范
校准集质量直接决定量化质量,规范四件事:样本量(100~500 张,覆盖全场景)、来源(线上日志采样而非训练集)、顺序(打乱,避免 batch 内相关性)、数量基准(每类输入至少一份)。校准不是一次性的——线上分布漂移后要重校准,这就是第6章提到的 Model Drift Detection 的用武之地。
不同 EP 的 INT8 行为差异
同一份 INT8 ONNX,在 CPU、CUDA、TensorRT、DML 上的 kernel 实现不同:有的走 QDQ 融合,有的走 QOperator,有的要求 per-channel 权重。经验法则是先在 CPU EP 验证 INT8 数值正确性,再在目标 EP 上验证性能——数值问题先排除工具链,性能问题再排 kernel 差异,两边不互相污染。
下一节:FP16 混合精度——INT8 之外的第二条路。
per-channel 与 per-tensor 的取舍
量化粒度直接影响精度与实现复杂度:
| 粒度 | 精度 | 硬件支持 | 适用算子 |
|---|---|---|---|
| per-tensor | 较低,易受离群值影响 | 几乎所有硬件 | 激活量化、小模型 |
| per-channel | 较高,逐通道独立缩放 | 多数推理引擎支持 | 权重量化、卷积 |
| per-group | 更高,进一步细分 | 新架构(如部分 NPU) | 极端低比特场景 |
权重一般用 per-channel,激活常用 per-tensor。原因是权重分布相对稳定,逐通道缩放几乎无额外推理开销;而激活的分布随输入变化,per-channel 需要额外的缩放查找,部分算子无法融合。
校准方法对比:MinMax 简单但对离群值敏感;Percentile 通过截断少量大值换取整体精度;MSE 最小化量化前后分布误差,效果最好但需迭代搜索。工程上先跑 Percentile(99.99%) 看基线,再按需升级到 MSE。